Concitech AI · 深度长文
2026/09/14 11:10
AI Agent 浏览器测试踩坑:Token、速度和回归资产的三笔账
两条推文引发一场 E2E 测试争论。Agent 操作浏览器耗费 Token,Playwright 脚本提供稳定回归。官方 Playwright Agents 给模型保留位置。问题的答案藏在角色分工。
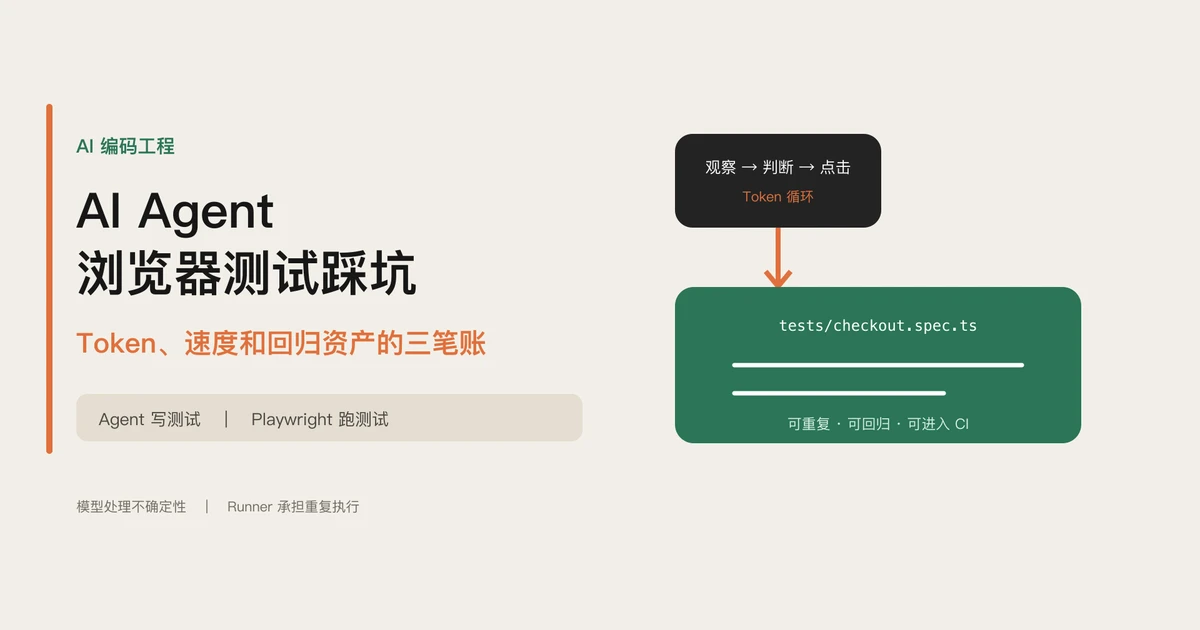
两条推文引发一场 E2E 测试争论。
第一条观点来自开发者“响马”:E2E 执行属于 Node.js 和 Playwright。Agent 适合测试代码生产。
第二条推文扩展了这个判断。作者给出一套工程规则:Agent 编写 Playwright 脚本;Playwright Runner 执行脚本;测试代码进入仓库;失败截图、Trace 和日志成为修复证据。
这套方法击中了 AI 编程的一个浪费点。
很多团队让编码 Agent 承担测试员角色。Agent 读取页面,理解截图,选择按钮,发起点击,读取新页面,作出下一步判断。每轮操作包含模型推理和工具调用。页面状态变化、弹窗、动画和网络延迟拉长循环。
常见测试产物是一段对话和几张截图。
Playwright 脚本提供另一种结果。步骤写入代码,断言写入代码,选择器写入代码。Runner 读取同一份脚本。CI 读取同一份脚本。修复任务复用同一份脚本。
观点的价值来自两者的角色边界。“Agent 与 Playwright 二选一”是误读。
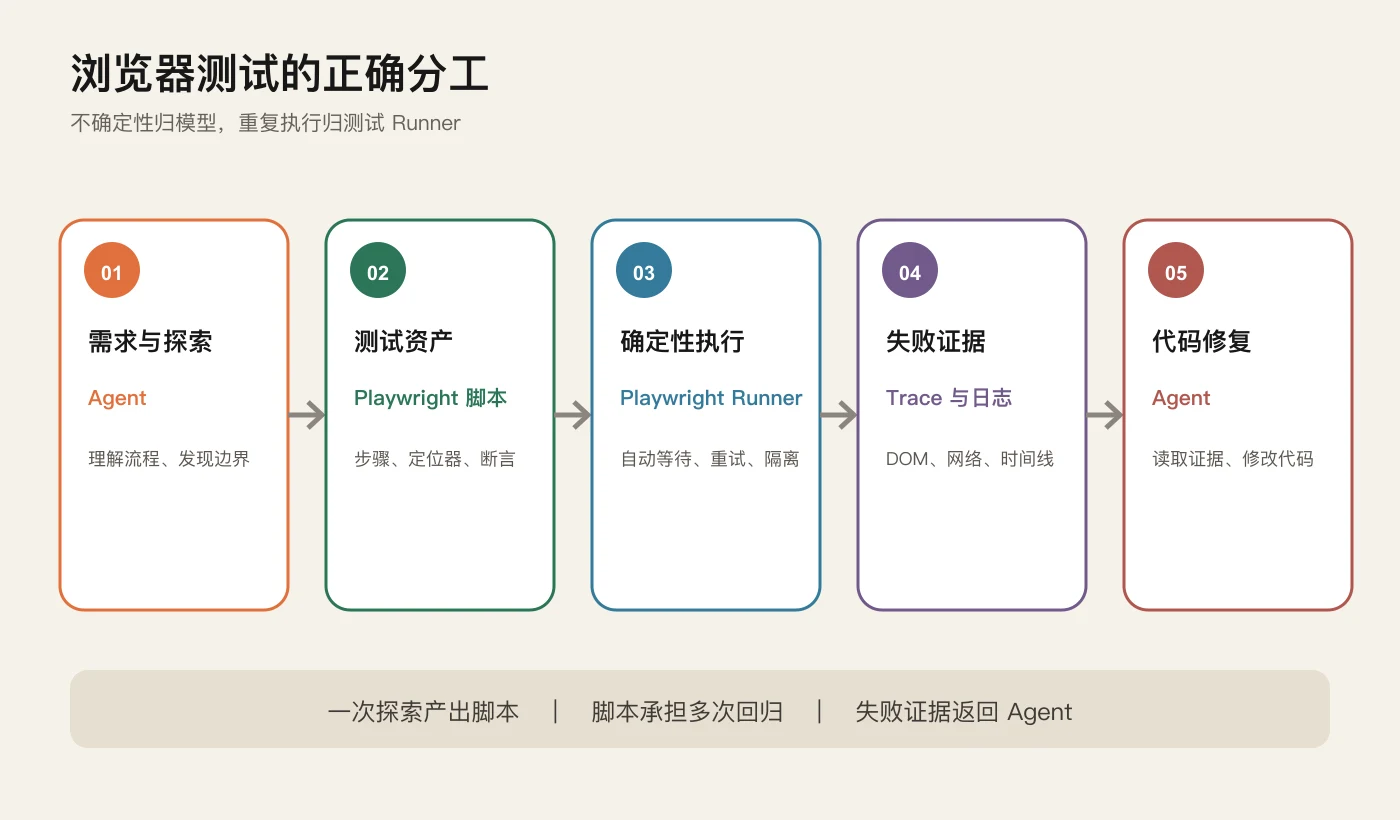
三笔账
第一笔是 Token 账。
交互式 Agent 采用“观察、判断、行动”循环。页面快照进入上下文。模型产出动作。工具返回新状态。每轮循环产生 Token 和推理费用。
Playwright Runner 的执行脱离语言模型调用,模型 Token 成本为零。测试生成、失败诊断、Healer 修复包含模型调用,Token 成本存在。
“Playwright 零 Token”这句话描述 Runner。这句话漏掉完整测试生命周期。
第二笔是速度账。
Playwright 的定位器拥有等待和重试能力。Runner 执行固定步骤。多浏览器项目、并行任务和 CI 分片拥有成熟支持。
Agent 浏览器工具承担判断任务。每个动作等待模型。长流程累积等待时间。页面噪声触发额外判断。
已知路径属于 Runner。未知路径属于 Agent。
第三笔是资产账。
一次 Agent 手测产生临时结论。一份 Playwright 脚本产生持久资产。Git 保存测试历史。CI 保存运行报告。Trace 保存 DOM 快照、网络请求和动作时间线。
Bug 修复得到一份复现脚本,这份脚本保护版本更新。测试成本由一次会话支出变成仓库资产。
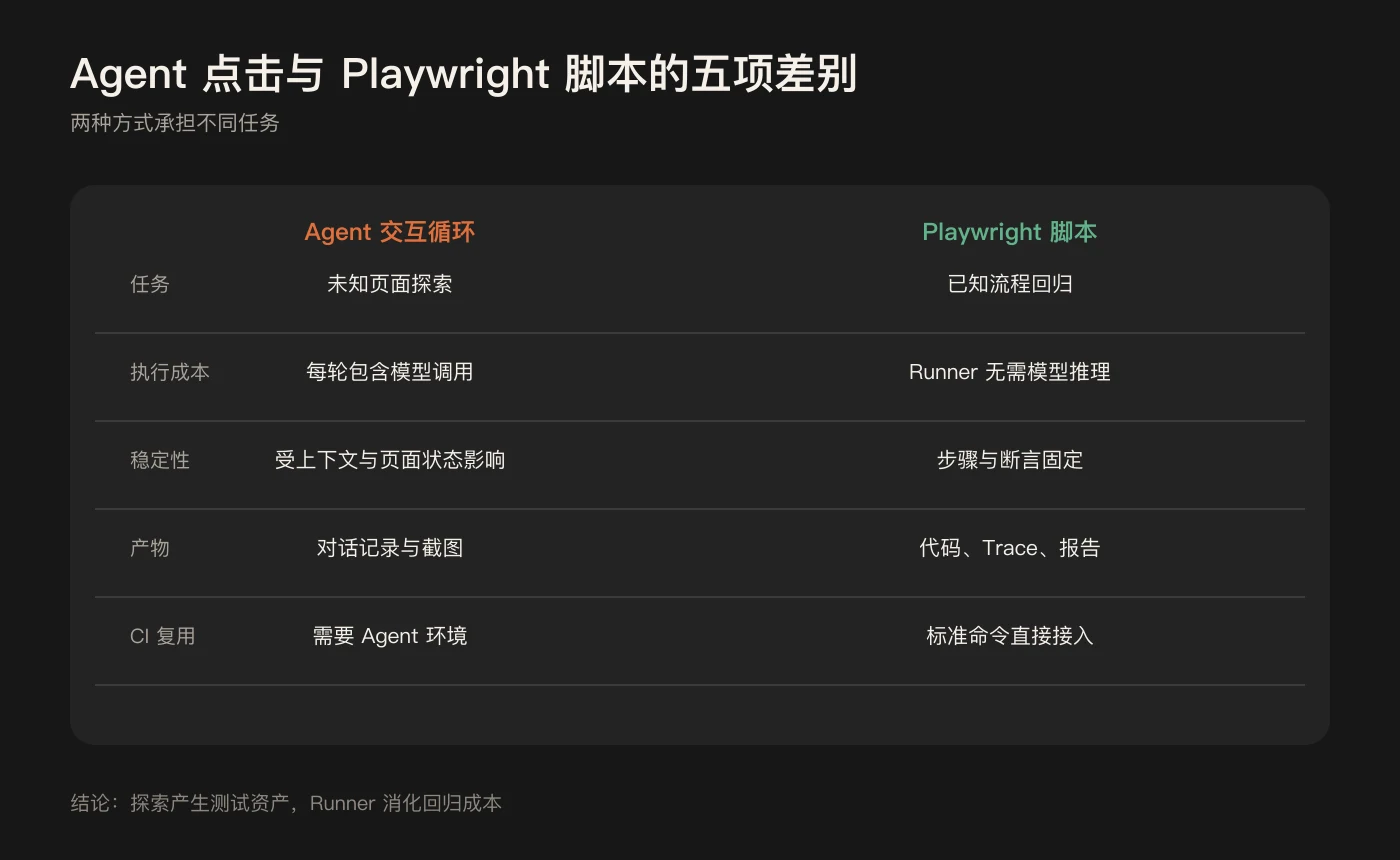
观点缺口
“E2E 脱离 Agent”这条规则范围过宽。
Playwright 官方提供三类 Test Agents:
- Planner 探索应用,产出 Markdown 测试计划。
- Generator 读取计划,产出 Playwright 测试文件。
- Healer 运行测试,分析失败,修复测试。
Agent 是 E2E 参与者。Agent 的位置发生了变化。
Planner 处理需求歧义和页面探索。Generator 把流程编译成确定性脚本。Runner 承担重复执行。Healer 处理选择器变化和测试修复。
这套官方设计与两条推文相容。双方视测试文件为交付物。差别来自 Agent 参与深度。
推文观点偏向成本控制:减少 Agent 浏览器操作。
Playwright 官方方案偏向测试生产:Agent 参与计划、生成与修复。
两种方法共享一个原则:模型输出落到可审计文件。聊天记录欠缺测试套件的复用价值。
UI 单测禁令
延伸讨论里出现另一条主张:UI 单元测试退出,人工验证负责界面检查。
这条主张适合一部分项目,通用性不足。
按钮 className、组件快照、内部实现细节产生脆弱测试。Playwright 官方建议测试用户可见行为。角色、文本和 test id 是选择器首选。长 CSS 链和 XPath 制造不稳定性。
组件测试具有明确价值。纯状态转换、表单校验、权限分支、复杂键盘交互和无障碍行为是低成本测试对象。E2E 套件承担全部边界,运行时间和排错成本增长。
测试类型的选择取决于失败成本。
支付流程、登录流程、数据删除和发布流程适用 E2E。纯函数、状态机和格式化逻辑适合单元测试。接口契约适合集成测试。视觉一致性适合截图比较与人工复核。
全面禁令把工程判断变成口号。
稳定性来源
Playwright 脚本的稳定性来自明确契约。
getByRole 绑定用户可见语义。getByTestId 绑定产品与测试的显式约定。Web-first assertions 等待目标状态。测试隔离切断 cookie、localStorage 和数据污染。Trace 记录失败现场。
下面这段规则适合 AGENTS.md:
## 浏览器测试边界

- Agent 负责未知流程探索、测试代码生产、失败证据分析。
- Playwright Runner 负责已知流程回归。
- 功能变更包含对应测试文件。
- 定位器采用 getByRole、getByLabel 或 getByTestId。
- CI 失败保留 Trace、截图和网络日志。
- 修复提交包含失败复现与回归结果。
规则保留两个出口。
产品原型缺少稳定结构,Agent 探索拥有价值。线上故障缺少复现路径,Agent 交互帮助定位。探索结果转化为脚本、日志或缺陷记录。临时操作具有资产出口。
工程结论
两条推文指出了真实问题:重复点击消耗昂贵推理。
它们给出的方向成立:Agent 写测试,Runner 跑测试。
完整方案保留 Agent 的探索能力。浏览器测试包含两种工作:未知流程发现和已知流程验证。前者承担判断,后者承担确定性。
团队检查一个简单信号:同一条浏览器路径出现第二次,仓库是否出现对应脚本?
答案为“有”,Agent 产生了工程资产。
仓库缺少脚本,团队为同一组点击重复支付 Token。
