Concitech AI · 深度长文
2026/08/22 13:20
Anthropic内部最近流行一个新工具,核心源码只有10行
一个没有脚本、模板和专用模型的Claude Code Skill,只靠两句指令就能把复杂系统变成大图少字的HTML图解。它展示的不是一个小技巧,而是一种新的软件生产方式。
Anthropic 内部最近有人频繁使用一个叫 /eli5 的 Claude Code Skill。
用法很简单:
/eli5 <你想弄明白的东西>例如:
/eli5 how does this module work
/eli5 why did we make this tradeoff
/eli5 what caused this incident
Claude 不会返回一篇密密麻麻的长文,而是生成一个 HTML 页面,用大图、流程和很少的文字,把问题讲给一个没有相关背景的人。
公开演示里,Claude 把一个 Discord Bot 的工作方式整理成一页可视化说明。网站、机器人、数据库、管理员和 Discord 之间的关系,被拆成几张顺着阅读就能看懂的流程图。
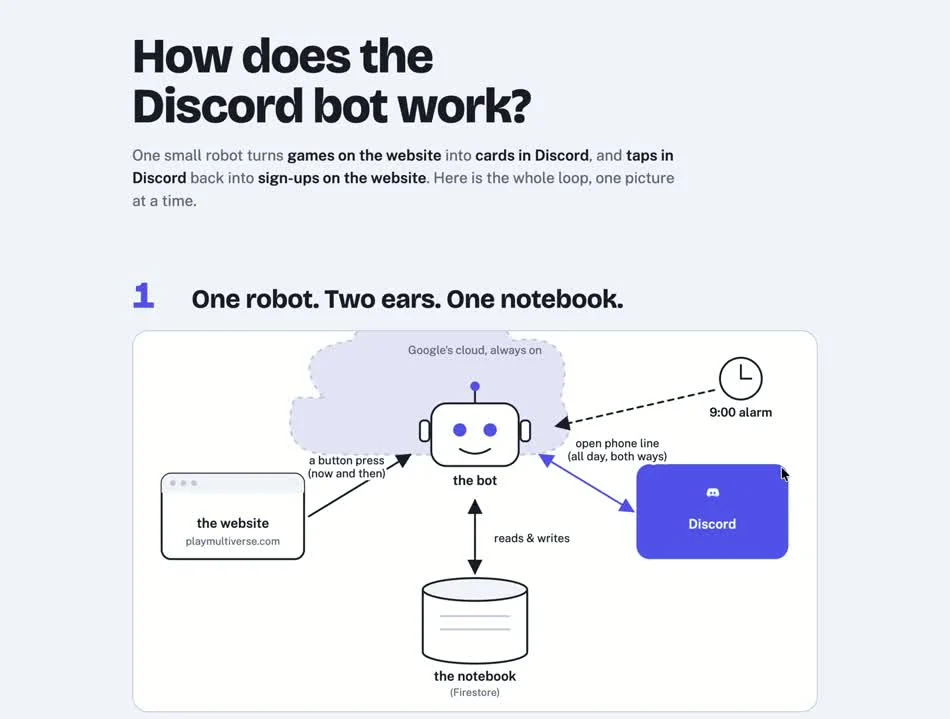
公开演示截图:页面先用一张图交代网站、机器人、Discord 与数据库的整体关系。
这个效果看起来像一个完整功能。
但打开源码后,真正让人意外的不是页面,而是这个插件几乎没有源码。
整个Skill只有10行
eli5 已经合并进 Anthropic 维护的 Claude 社区插件仓库。它的目录里只有三个有效文件:
eli5/
├── .claude-plugin/plugin.json
├── README.md
└── skills/eli5/SKILL.md
没有 JavaScript,没有 Python,没有 HTML 模板,没有 CSS,没有 MCP,也没有图片资源。
真正执行任务的 SKILL.md 只有 10 行、321 字节。去掉 YAML 元数据和标题,核心指令只有两句:
Explain like I'm someone who knows nothing about this topic,
using a HTML artifact with big pictures and few words.

Topic: $ARGUMENTS
翻译过来就是:假设读者对这个主题一无所知,用大图和少量文字制作一个 HTML Artifact。主题由用户输入。
就这些。
通常我们看到一个可视化产品,会自然地寻找它的前端代码、组件库、数据结构和布局模板。eli5 没有提供这些东西。Claude 会先理解用户提出的问题,按需要读取代码或上下文,然后现场决定信息结构、画图方式、页面布局和解释顺序,最后生成一份一次性的 HTML 界面。
Skill 只定义目标和约束,具体产品由模型在运行时完成。
它真正改变的不是难度,而是表达介质
ELI5 是 “Explain Like I’m Five” 的缩写,通常被理解成“用五岁孩子也能听懂的话解释”。
如果只是把术语换成简单词汇,这个 Skill 没什么特别。普通提示词也能做到。
它更有价值的地方,是强制 Claude 换一种表达介质。
聊天回答是线性的。模型从第一段写到最后一段,读者必须在脑子里记住前面出现的组件,再把它们拼成一张关系图。系统稍微复杂一点,文字就会越来越长。
HTML Artifact 可以把关系放到空间里。组件能并排出现,箭头能表达方向,颜色能区分角色,步骤能形成明显层级。读者先看到整体,再决定要不要钻进细节。
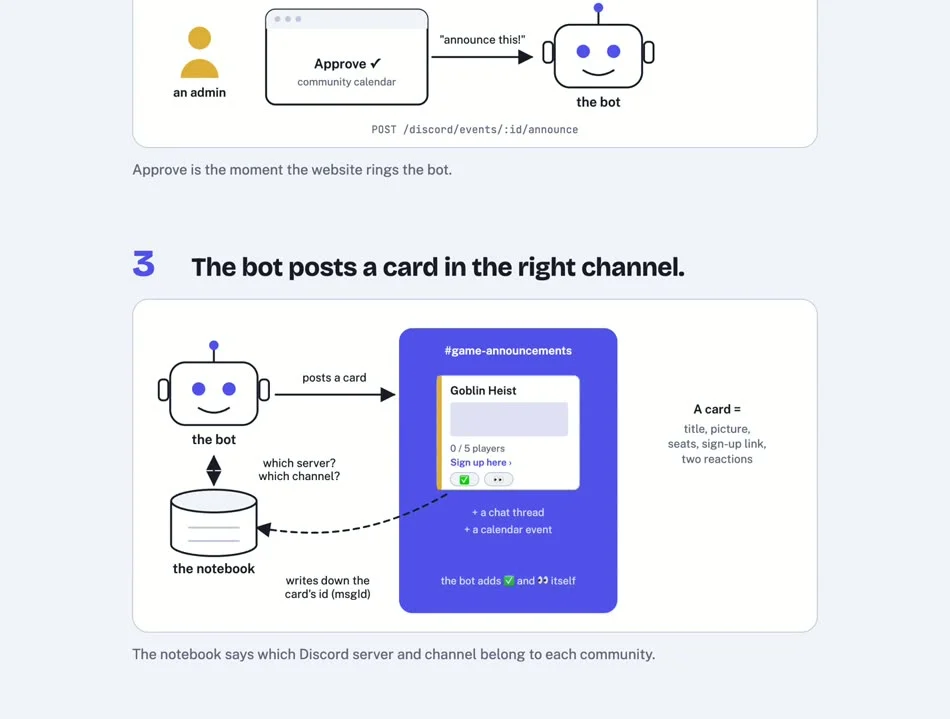
公开演示截图:页面继续向下展开,把机器人发布卡片的过程拆成独立步骤。
这对代码和技术系统尤其有效。
很多新人看不懂一个项目,并不是因为每段代码都很难,而是不知道入口在哪里、数据经过哪些模块、哪个动作会触发下一个动作。让 AI 再写一篇 3000 字架构说明,经常只是把一种看不懂变成另一种看不完。
/eli5 做的是把系统从“文字描述”改成“可浏览的模型”。
所以它适合的场景并不只包括基础科普:
- 新成员第一次理解代码库或业务模块;
- 复盘一次事故的触发链和影响路径;
- 向非技术同事解释架构取舍;
- 阅读陌生 API、协议或数据流;
- 在深入源码前建立一张粗略地图。
这也是为什么 Anthropic 内部会有人把它用于 “这个模块如何工作”“为什么当时做了这个取舍”“这次事故是怎样发生的”。他们需要的不是幼儿化表达,而是迅速建立共同理解。
这算新功能,还是一条提示词?
推文下面有一个很尖锐的质疑:先花 Token 让模型生成冗长内容,再花 Token 把它删短,这不算功能,只是一种绕路。
这个批评有道理,但只说对了一半。
从代码量看,eli5 的确很接近一条被打包、命名并分发的提示词。它没有增加 Claude 原本不具备的底层工具,也没有提供确定性的可视化算法。
但 Skill 的价值不只在“多了多少代码”。
它把一套容易忘记、每次都要重新描述的工作方式,变成了稳定入口。用户输入 /eli5,Claude 就知道输出格式、目标读者和信息密度,不必每次重新讨论怎么呈现。
Claude Code 官方文档把这种机制称为渐进式加载。启动时只把 Skill 的名称和描述放进上下文,官方估算每个 Skill 的元数据约占 100 Token;完整指令只有在触发时才加载,附带脚本和参考资料也只在真正访问时产生上下文成本。
对于 eli5 这种只有 321 字节的 Skill,指令本身几乎可以忽略。
真正昂贵的是后面的 HTML 生成。模型需要理解主题、组织内容、写页面和绘制图形,单次输出很可能比一段普通文字消耗更多 Token。
所以 /eli5 不是 Token 优化工具。
它节省的是人的理解时间,也可能减少后续来回追问。如果一张图能替代三轮“这个组件和刚才那个组件是什么关系”,整个任务的总 Token 反而有机会下降。但对一个本来两段话就能说清的问题,调用它只会更贵。
正确的衡量单位不是“这一轮生成了多少字”,而是“读者建立正确理解用了多少时间和多少轮对话”。
它还不是Anthropic官方插件
这里需要划清产品边界。
截至 8 月 22 日,eli5 位于 anthropics/claude-plugins-community,也就是 Claude 的社区插件市场,而不是 claude-plugins-official 官方市场。
相关代码在 8 月 21 日通过 PR #2372 合并,版本号为 1.0.0。发布者同时表示,团队还在讨论是否把它做成官方插件。
Anthropic 官方文档说明,社区市场里的第三方插件会经过自动验证与安全扫描,并固定到具体 Commit SHA;官方市场则由 Anthropic 单独维护和筛选。通过社区检查,不等于获得官方产品背书。
想试用,可以在终端运行:
claude plugin marketplace add anthropics/claude-plugins-community
claude plugin install eli5@claude-community
安装后即可在 Claude Code 中执行:
/eli5 how does DNS work如果当前会话没有立即出现 Skill,可以按安装提示执行 /reload-plugins 或重新启动 Claude Code。
从安全角度看,这个版本的 eli5 攻击面很小,因为它没有脚本、Hook、MCP 和外部依赖,审计 10 行 SKILL.md 就能看完主要行为。
但不能由此推导出所有 Skill 都安全。Claude Code 插件可以包含可执行脚本、Hooks、MCP Server 和二进制文件,并以用户权限运行。Anthropic 的文档明确建议把安装 Skill 当成安装软件,检查网络请求、文件访问和工具权限,而不是只看插件名字。
生成的 HTML 也应该保留基本警惕。用于解释敏感代码库时,先确认页面是否只保存在本地、是否引用外部资源,以及里面有没有不该出现的内部信息。
最好的用法,不是让Claude把一切都讲成童话
“大图、少字”很容易制造一种危险的清晰感。
页面越漂亮,读者越容易忽略它可能漏掉条件、混淆因果,或者把模型的推测画成确定事实。复杂系统有时确实复杂,不能靠隐藏细节解决。
更稳妥的使用方式,是把 /eli5 当作第一层导航,而不是最终文档。
例如解释代码库时,可以补充约束:
/eli5 explain how authentication works in this repository.
Read the actual code first, label assumptions, and list the source files
for each major step at the bottom.
解释事故时,可以要求它区分证据和推测:
/eli5 explain what caused this incident from the logs and timeline.
Mark confirmed facts and unknowns separately.
这样生成的页面既保留低门槛,也能回到原始证据。读者先用图建立结构,再沿着文件、日志或文档继续验证。
如果要把它用于团队培训,还可以进一步固定颜色含义、页面层级、引用格式和术语表,并为典型问题做一组评测。Skill 越短,模型自由度越大,输出也越不稳定。个人临时使用可以接受,正式知识库则需要更多模板和检查。
两句话为什么值得讨论
eli5 最值得注意的地方,恰恰是它看起来太简单。
过去的软件功能由开发者提前写好。页面有哪些组件,按钮放在哪里,数据怎样进入图表,都在发布前确定。
现在,一份 10 行的 Skill 可以只规定目标、受众和约束,把界面生成推迟到用户提出问题之后。每个主题得到一张临时页面,用完就可以丢掉。
这类 Skill 更像“界面生成规则”,而不是传统插件。
当模型和 Agent Harness 足够强,很多长尾功能不会再以固定页面存在。用户说出意图,Skill 提供少量产品判断,模型读取当前上下文并生成最合适的交互界面。
这也会把产品开发的难点往后推。
写出两句指令不难。难的是判断什么时候应该触发、怎样避免过度简化、如何引用证据、怎样评估不同主题下的输出是否真的帮助理解。
eli5 现在仍是一个很早期的社区实验。它可能被官方化,也可能很快被更完整的版本取代。
但它已经把一个变化展示得很清楚:在 Agent 时代,有些看起来像完整产品的功能,源码可能只剩几句话。剩下的代码,临时生成。
