Concitech AI · 深度长文
2026/09/28 05:15
Claude写下Anthropic八成代码:AI自我改进卡在研究品味
Anthropic披露内部AI研发数据:Claude贡献超过80%的合并代码,工程师代码产量达到2024年的8倍,训练代码优化达到52倍。执行循环出现自动化,目标选择与研究品味构成人类瓶颈。
Anthropic公布了一组内部数据。
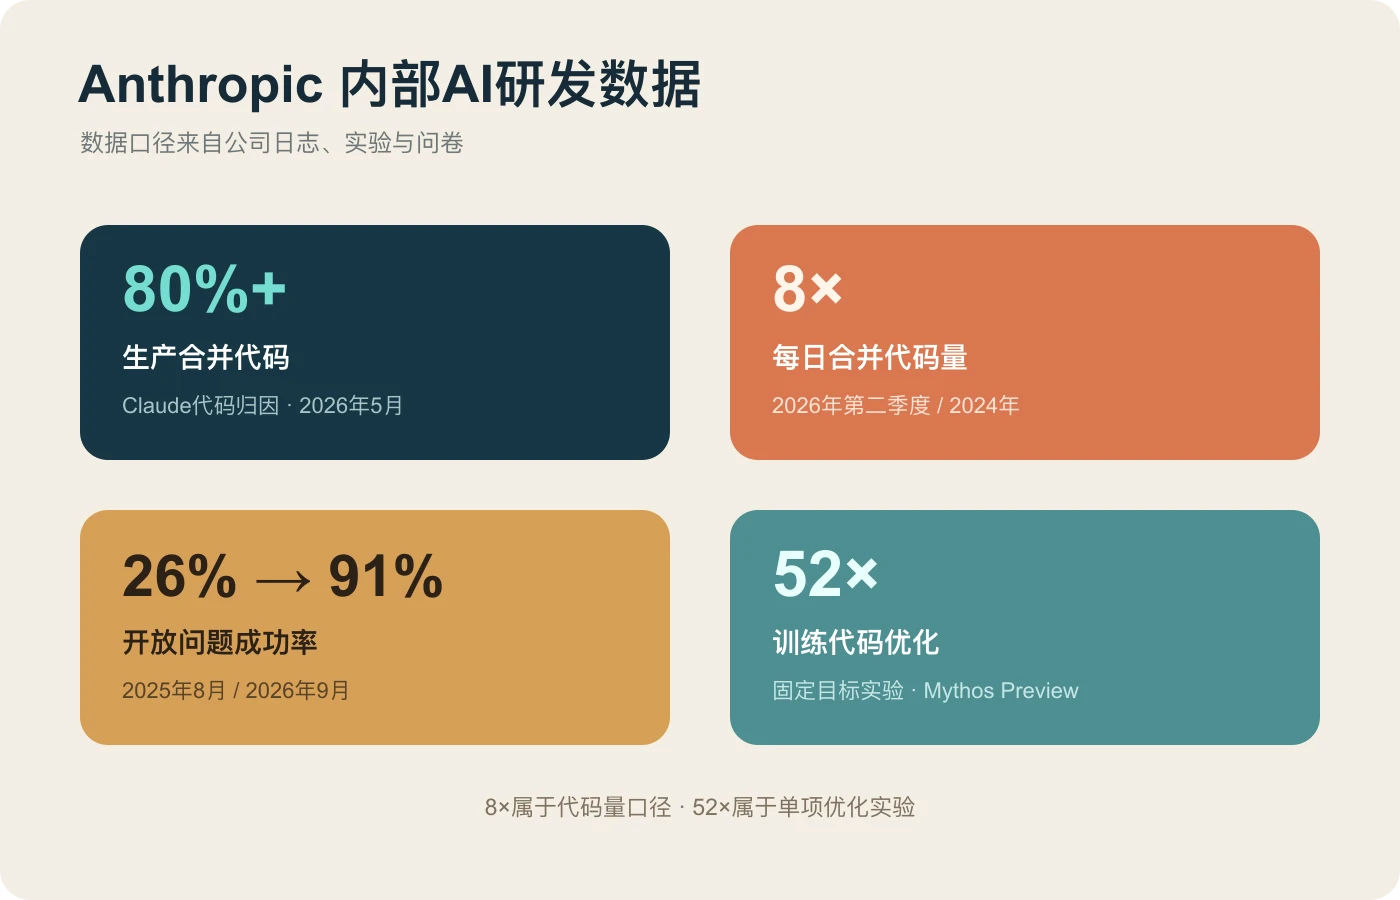
Claude贡献生产代码的比例超过80%。典型工程师的每日合并代码量达到2024年的8倍。开放问题会话成功率的起点是26%,终点是91%。一项训练代码优化实验给出52倍加速。
Anthropic称这组变化为Recursive Self-Improvement,递归式自我改进。
这个词引出科幻想象。一个模型设计、训练、评估下一代模型,下一代模型重复这个过程。Anthropic的证据停在闭环前一站:Claude接管执行,人类掌握方向。
八成代码是谁写的
Anthropic的代码归因系统给出一个数字。数据日期是2026年5月。Claude编写的代码占合并代码行数80%以上。公司管理层公开口径超过90%,该口径包含脚本和实验代码。80%属于生产合并代码口径。
代码量变化呈现另一量级。2021年至2024年的每名工程师每日合并代码行数保持稳定。曲线的首个拐点对应2025年,Claude Code进入代码运行阶段。曲线的第二个拐点对应2026年,Agent获得长任务能力。2026年第二季度的典型工程师代码量是2024年的8倍。
Anthropic承认这个指标的缺陷。代码行数衡量数量,代码质量、维护成本和业务价值属于其他口径。真实生产率增幅低于8倍。
公司研究团队的一项问卷提供另一项估计。样本包含130名员工,受访者的产出增幅中位估计是4倍。Anthropic认为真实增幅低于问卷估计。问卷属于主观材料。
一个内部案例展示代码规模。Claude提交800余项修复,某类API错误下降1000倍。负责人估计人工工期是4年。这个工期来自单名工程师判断,第三方复现证据缺席。
开放问题成功率升到91%
Claude Code会话分成简单、常规、重大和开放问题四档。Claude裁判模型判定会话成功,条件是任务完成且人工修正缺席。
开放问题成功率的2025年8月图示值接近26%。2026年5月数据是76%,半年增幅是50个百分点。9月18日更新图的2026年9月图示值接近91%,四类任务收敛到88%至92%。
开放问题包含真实事故。一次常规升级导致数万项训练作业崩溃。工程师提供事故描述和集群访问权。Claude检查运行作业、测试环境变量、定位调试标记、复现故障并确认修复。任务耗时接近两小时,人工估计是两至三天。
这个成功率带有三项限制。裁判来自Claude,工作负载发生变化,内部任务集缺少公开数据。91%说明Anthropic工作流里的Agent成功率,通用软件工程成功率属于另一命题。
代码审查进入自动化。Anthropic的代码合并流程包含Claude审查。历史回放实验显示,自动审查捕获过往线上事故缺陷的比例接近三分之一。回放分析属于内部实验,部署后的真实漏报率缺少公开数字。
52倍来自一个清晰目标
工程任务提供明确目标,研究任务多一层判断:什么实验值得做。
Anthropic使用一项固定测试观察这条边界。任务提供一段小模型训练代码,目标是缩短运行时间,正确性测试保持原值。Claude负责改写、运行、计时和迭代。
Claude Opus 4的2025年5月平均结果接近3倍。Mythos Preview的2026年4月结果接近52倍。熟练研究人员的四至八小时结果接近4倍。
52倍属于单项训练代码优化。模型训练整体提速属于另一口径。倍数受初始代码优化空间影响。这个实验测量执行效率,任务范围排除研究方向选择。
Anthropic的弱到强监督实验增加了一层自主性。人类研究员的工期是一周,性能差距弥合率是23%。Agent团队的累计工时是800小时,算力成本接近1.8万美元,差距弥合率是97%。Agent提出假设、运行实验并共享结果。
实验限制包括两项:人类选择问题并设计评分标准,生产级模型迁移效果有限。Agent承担实验设计,人类给出研究议程。
研究品味的测试
Anthropic尝试测量“下一步选择”。研究者筛选129个真实会话节点。这些节点含有人类绕路,后续结果提供答案参照。模型读取绕路前的上下文,另一个Claude裁判比较模型选择与人类选择。
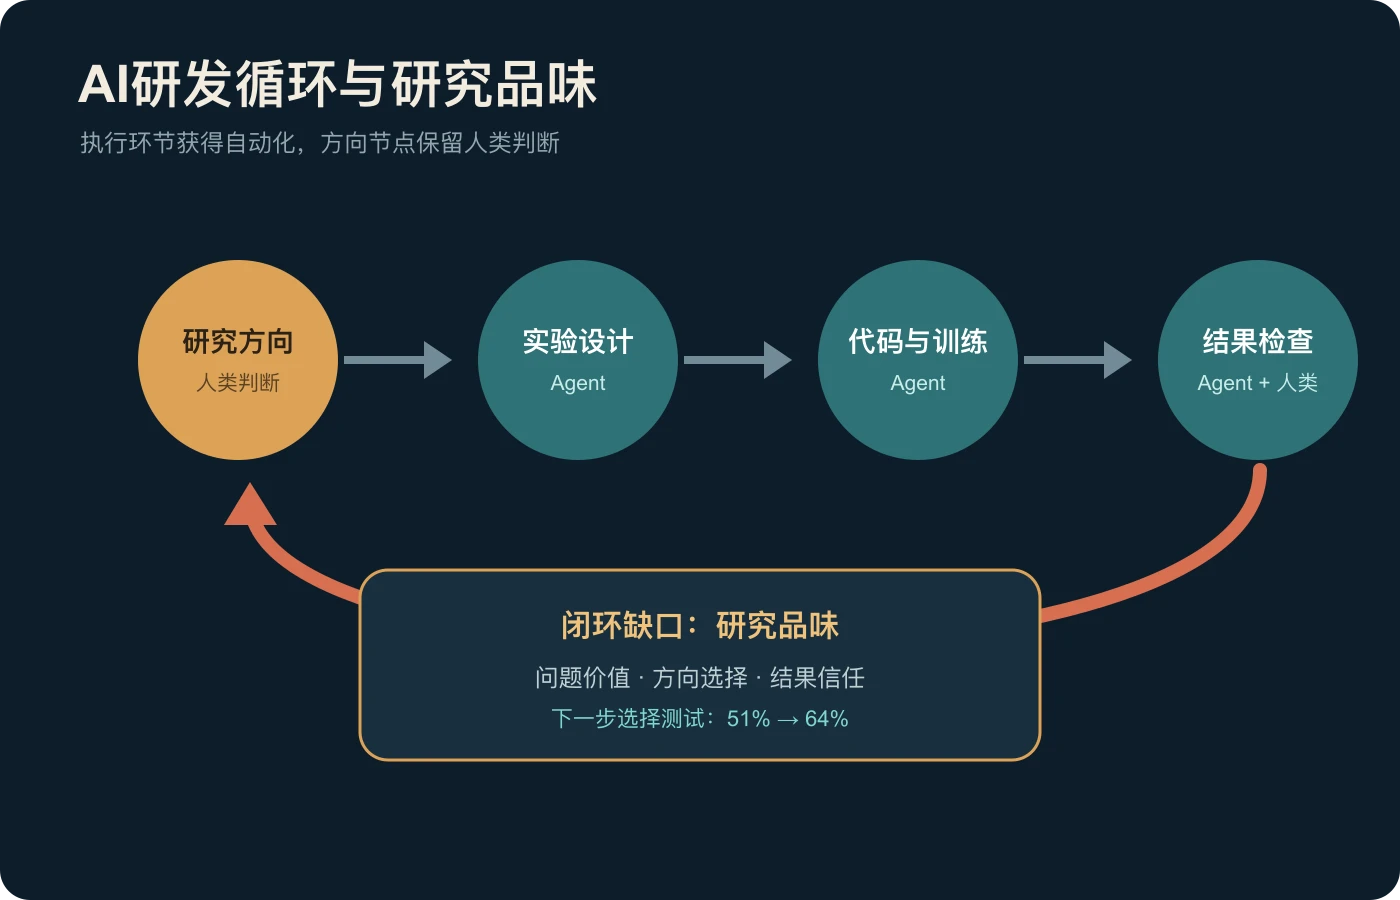
Claude Opus 4.5的胜率是51%。Mythos Preview的胜率是64%。64%胜率的解释依赖样本结构,样本选择偏向人类失误。
团队设置另一组127个节点。这些节点的人类选择表现良好。模型选择的胜率接近20%。两组结果的联合结论清楚:模型纠正一部分明显绕路,模型超越优秀研究判断的稳定性证据不足。
外部基准支持什么
METR的任务时长基准提供外部证据。50%可靠率对应的任务时长呈指数增长。早期趋势的翻倍周期接近7个月,Anthropic引用的新趋势接近4个月。
“12小时任务”有特定含义。测试任务的人类专家用时是12小时,模型预测成功率是50%。整份职业工作的自动化属于另一命题。
METR任务集的主体是软件工程、机器学习和网络安全。任务具有自包含、规格清晰、自动评分等特征。现实工作包含组织背景、隐性知识、人际沟通和模糊目标。METR页面说明,16小时以上测量的可靠性不足。
人类工时带有偏差。基准参与者缺少日常项目背景,任务熟悉成本推高工时。METR给出的基准人类定位是低上下文新员工或外部承包者。
这些限制界定趋势的解释范围。模型攻克的对象是长度增长的软件与研究执行任务。整份工作和研究议程包含额外部分。
自我改进循环缺哪一环
AI研发包含一条循环:研究方向、实验设计、代码实现、训练运行、结果判断、模型更新。
Anthropic的数据覆盖中间四环。Claude写代码、运行实验、检查结果和审查变更。研究方向与结果价值留在人类手里。
这个结构产生复合加速。每名研究员指挥众多实验,实验结果缩短模型迭代周期,新模型扩大Agent能力。执行规模与模型能力互推构成复合加速前提,完整闭环属于下一阶段。
瓶颈发生迁移。代码生成速度超过代码审查速度,人工审查限制总体吞吐。实验执行成本下降,实验选择、算力、电力和验证成为新约束。Anthropic的解释框架是Amdahl定律:局部环节加速,总体瓶颈落在其他环节。
三种未来
Anthropic列出三种情景。
第一种是能力曲线进入平台期,现有能力扩散到经济系统。研究品味、算力、电力或芯片供应链成为硬约束。
第二种是研发效率保持复合增长,人类选择方向,Agent承担大部分执行。作者倾向这条路径。代码审查瓶颈提供一个组织样本。
第三种是完整递归式自我改进。AI设计并训练继任模型,人类角色收缩到监督、验证和治理。能力增长速度受算力与算法效率支配。
文章支持可验证的减速或暂停机制。方案需要多个前沿实验室、多个国家和共同触发条件。训练活动的隐蔽性让验证机制变得困难。Anthropic计划推动政策、研究和社会组织参与讨论。
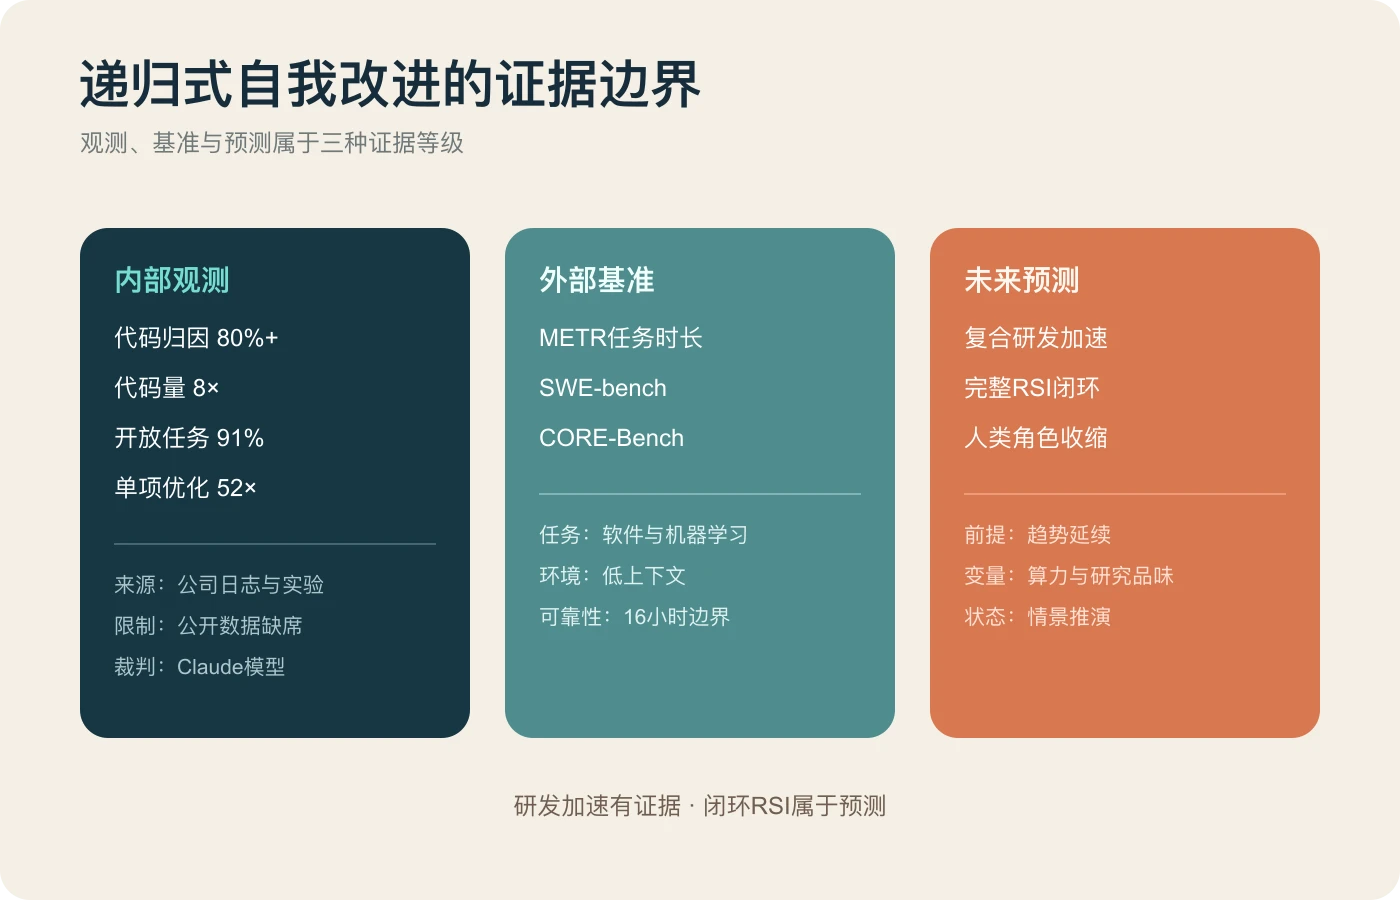
证据与预测分开看
内部数据证明Anthropic研发流程出现巨大变化。80%代码归因、8倍代码量、开放任务成功率和实验优化倍数构成直接证据。
闭环自我改进属于预测。研究方向选择、优秀判断复现、独立安全验证和跨实验室协调存在空白。Anthropic拥有三重身份:数据提供者、加速收益方、政策参与者。这层利益关系属于解读条件。
80%代码占比属于执行指标。闭环RSI的判定点是研究议程选择、继任模型设计和结果价值判断。Anthropic的数据说明这条边界发生移动,边界跨越证据缺席。
参考资料
- Anthropic Institute, When AI builds itself
- METR, Task-Completion Time Horizons of Frontier AI Models
- METR, Measuring AI Ability to Complete Long Software Tasks
- Anthropic Alignment Science, Automated Weak-to-Strong Researcher
- CORE-Bench, Computational Reproducibility Agent Benchmark
- LotusDecoder, 相关推文
