Concitech AI · 深度长文
2026/09/10 08:21
Anthropic 的秘密图书馆,Claude 得到文字,读者失去出处
一枚 GPS 追踪器揭开 Anthropic 的购书扫描计划。法院材料呈现盗版下载、纸书数字化、模型训练三条路径。《纽约客》的调查指向另一个问题,模型记住文字,公众失去出处。
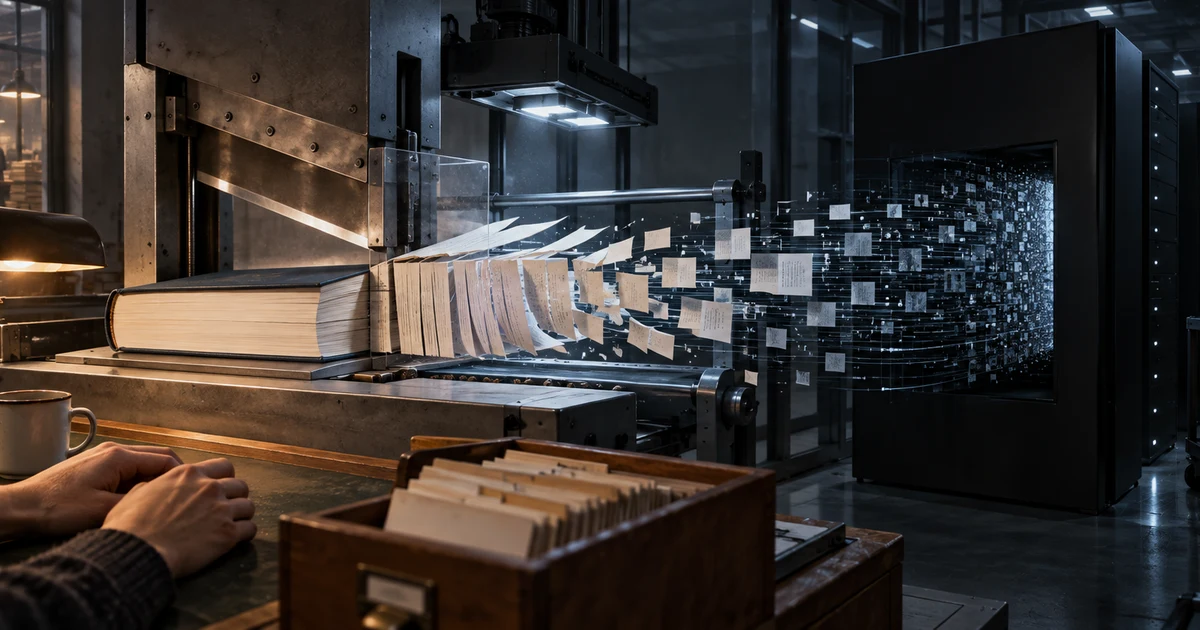
一本旧书带着一枚 GPS 追踪器上路。
买家是陌生公司。订单是大单,价格缺少讨价还价。书商产生疑心。包裹藏着追踪器。信号终点是一家工业扫描厂。
装订遭到切除。书页进入扫描仪。纸本进入废料箱。数字副本进入 Anthropic 的研究语料库。
《纽约客》调查披露了这条路线。项目代号叫 Project Panama。法院文件记录过一个目标,收集世界上的书,保留这座数字图书馆。
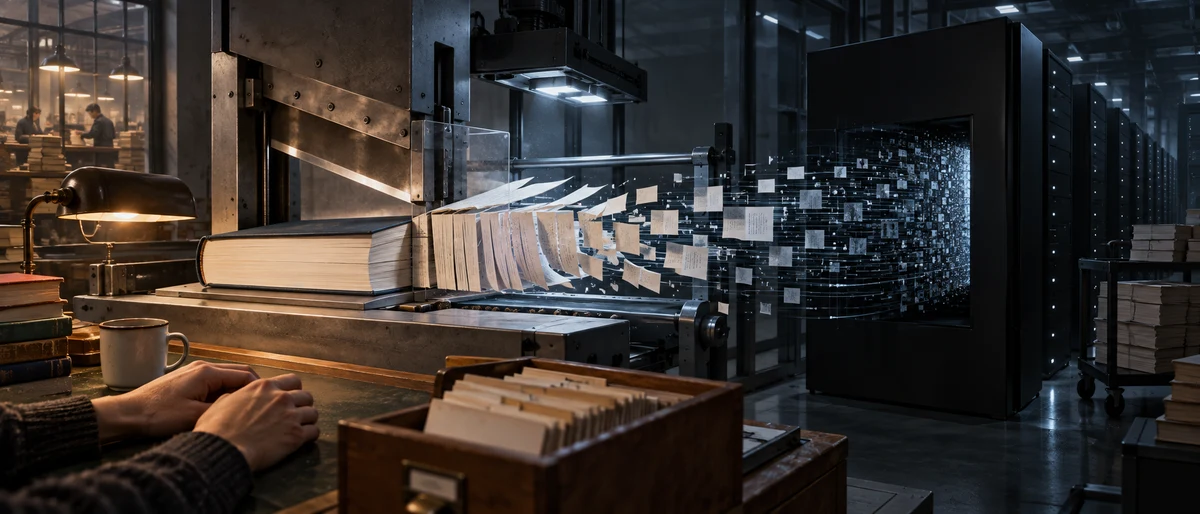
碎书机给这则故事提供了画面。版权案给它提供了数字。图书馆问题给它提供了分量。
我的判断是一句话。
纸张的毁损构成表层冲突。出处的消失构成长期冲突。一本书原有公共文化对象身份。私有训练材料成为新身份。作者、版本、章节顺序、出版背景和读者批注失去位置。模型得到句子。社会失去检索这些句子的目录。
这座秘密图书馆存在三条路线。
第一条路线来自盗版站点。
美国加州北区联邦地区法院的裁决记录了三批下载。Books3 提供 196,640 本书。LibGen 数量下限为 500 万本。PiLiMi 数量下限为 200 万本。文件格式包含 PDF、TXT 和 EPUB。配套目录保留书名、作者和 ISBN。
第二条路线来自旧书市场。
法院材料记载了数百万册纸书采购。支出规模达到数千万美元。服务商切掉装订,裁齐书页,完成扫描,丢弃纸本。一本纸书对应一份数字文件。软皮书扫描件包含封面和封底。Anthropic 为这些文件建立书目元数据。
第三条路线通向 Claude。
工程师选择语料库中的书籍子集。处理流程包含清洗、分词和训练。文字变成数字序列。数字序列进入统计关系。统计关系进入模型参数。
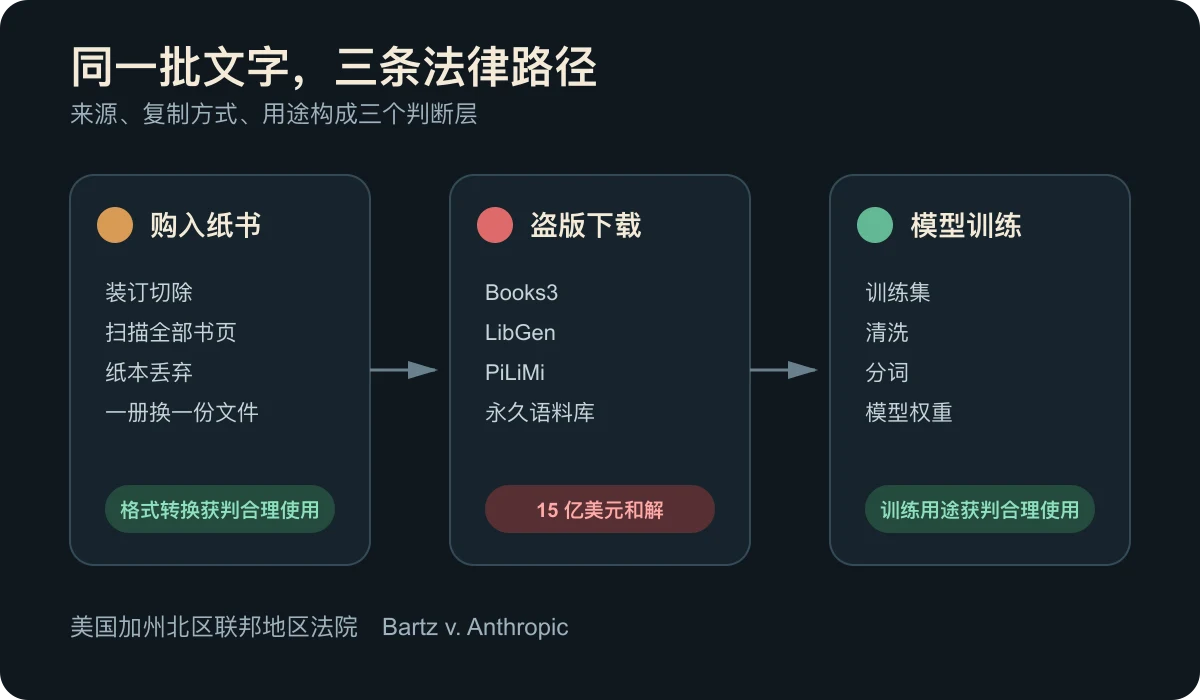
图一 三条来源与用途对应三种法律判断
三条路线拥有三种法律结果。
2025 年 6 月的地区法院裁决认定模型训练属于合理使用。裁决称训练属于高度转换性用途。原告主张的案件记录缺少 Claude 输出原著副本或近似仿作的指控。
购书扫描获得另一项合理使用认定。法院采用一对一替换逻辑。Anthropic 购买一册纸书,制作一份数字副本,销毁原件。案卷缺少数字副本外传、分享或销售的证据。存储空间和检索能力构成格式转换理由。
盗版语料库得到相反判断。法院拒绝下载行为与训练用途的合并判断。训练的转换性缺少来源清洗效力。数百万份盗版文件承担一座永久语料库的功能。版权人失去销售合法副本的机会。
这条争议走向和解。2026 年 7 月的最终批准令确认 15 亿美元和解。作品清单包含 482,374 部作品。法院称审判结果存在风险,和解提供确定补偿。案件获得有终局效力的驳回。
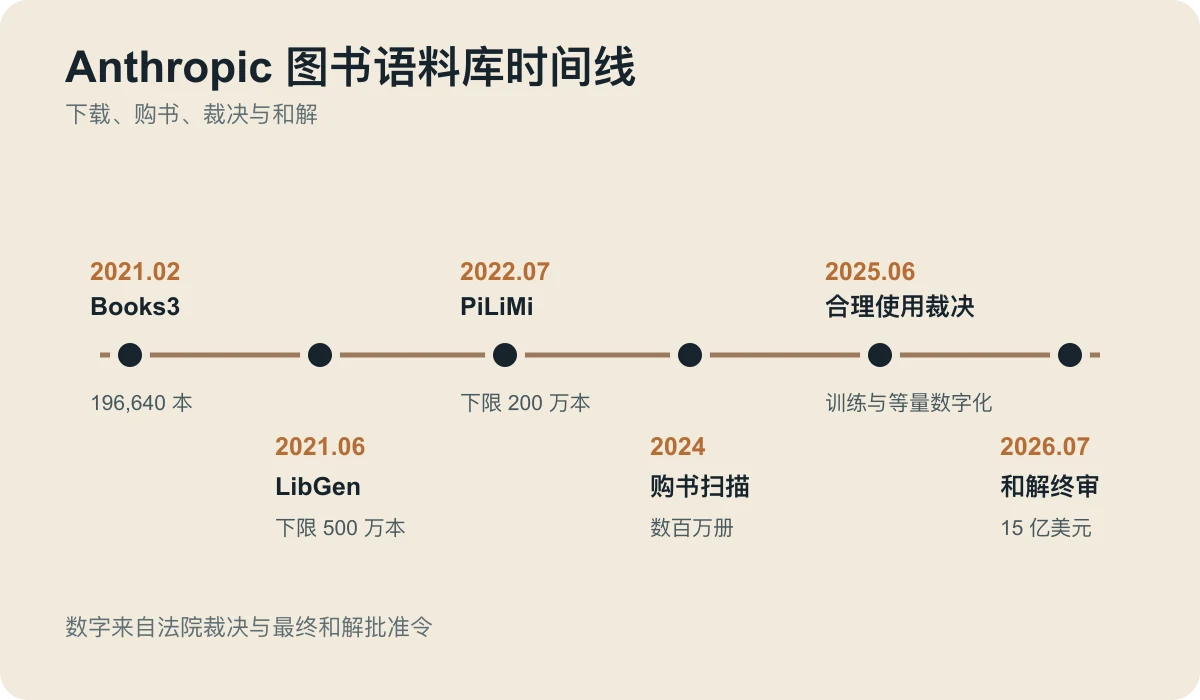
图二 图书语料库的六个节点
这组裁决给 AI 行业画出一条窄线。
训练用途和语料获取属于两个问题。模型行为缺少来源瑕疵清洗效力。合法购书支撑数字化。盗版下载留下赔偿责任。
这条线解决版权案的一部分。文化问题留在桌面。
《纽约客》获得了一份六百多本书的样本。样本主体属于 1970 年代至 2010 年代出版物。八个头部出版方属于大学出版社。学术出版社作品占比接近三分之一。主题包含历史、传记、诗歌、文学批评、法律和社会科学。
珍本毁灭的恐慌缺少样本支持。Anthropic 发言人称采购项目排除珍本和古籍。美国古籍书商协会称其成员缺少相关报告。接受采访的书商售出的多为带 ISBN 的现代书。
普通书籍构成另一个损失尺度。
地方史发行量有限。冷门诗集和早期社会调查拥有相同处境。数字版处于空缺状态。这些书拥有低市场价格和高文化替代成本。一本绝版书进入碎书机,市场少了一册。数字副本进入封闭服务器,公共馆藏缺少补充。
Anthropic 得到一座支持搜索的语料库。研究者缺少完整目录。Claude 用户缺少答案对应的书名、页码和版本。外部团队缺少复现实验所需的训练书单。
传统图书馆依靠目录建立信任。目录说明一本书来自哪里,属于哪个版本,处于哪排书架。学术写作依靠注释建立信任。注释允许读者返回原文,检查上下文,比较版本。
模型提供另一种记忆形式。训练流程拆分句子,产生 token。模型参数容纳 token 的统计关系。答案保留语言模式,来源关系失去可见性。
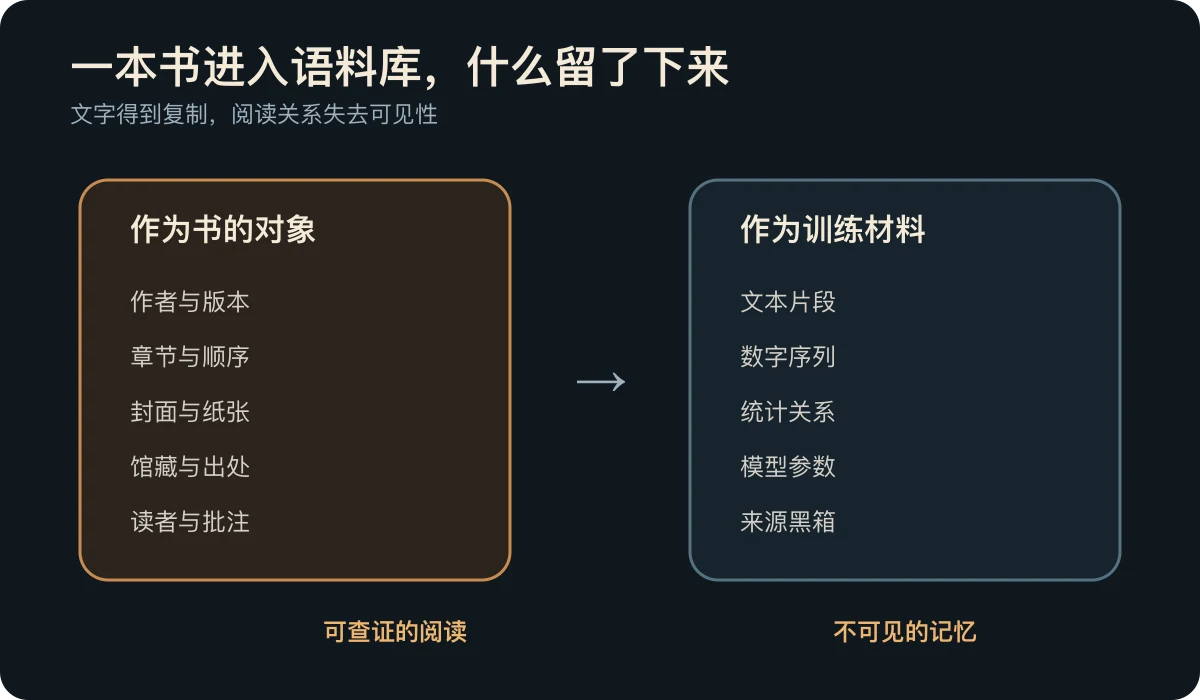
图三 书籍对象与训练材料保存不同信息
《纽约客》引用学者 Leah Price 的观点。一本小说拥有句子和句子顺序。叙事效果来自排列、节奏、回声和结构。训练流程关注片段之间的统计关系。阅读关系遭到压平。
媒介研究学者 Matthew Kirschenbaum 提醒人们关注物质信息。封面、纸张、出版时间、作者身份和作品间关系构成文本的一部分。统一的数据管道抹去这些差异。
这里出现一个反常结果。
图书馆语言成为 AI 公司的语料库描述工具。传统图书馆服务读者。私人语料库服务模型。传统图书馆提供目录。私人语料库保护商业秘密。传统图书馆保存对象。破坏性扫描保留内容副本。
两者共享藏书规模,缺少同一种公共责任。
行业争论聚焦授权价格。价格拥有重要性。出处基础设施拥有同等价值。出版方提供机器可读许可。模型公司保存训练书目、版本标识和权利状态。产品提供来源追踪和引用接口。独立审计检查语料边界。
这些机制存在成本。碎书扫描拥有成本。15 亿美元和解拥有成本。缺少目录的机器记忆拥有社会成本。
Project Panama 留下的核心问题超出 Anthropic。
模型成为知识入口。入口背后是一座封闭图书馆。读者缺少访问权。书名变成数据行。章节变成 token。出处变成公司机密。
机器获得了一种记忆。
社会需要一份目录。
