Concitech AI · 深度长文
2026/09/19 09:32
AI告别文字:清华C2C打通模型缓存,Agent协议换轨
清华、无问芯穹、中大、上交、上海AI实验室团队推出C2C。模型共享KV Cache,文字中继退出协作链。ICLR 2026正式论文给出2.5倍平均延迟加速,代码开源。
两个模型合作。
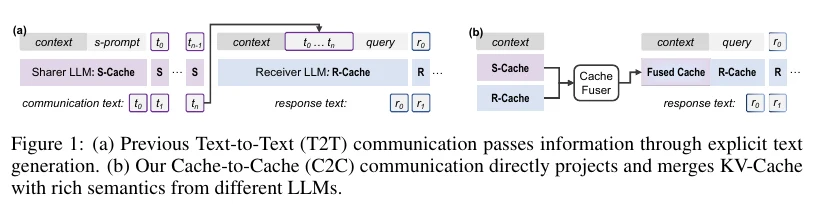
模型甲生成分析文本。模型乙读取文本,重建语义,输出答案。
人类习惯塑造了这条路径。机器系统支付三笔费用:文本生成延迟、重复前缀计算、语义压缩损失。
清华大学、无问芯穹、香港中文大学、上海交通大学与上海人工智能实验室团队给出另一种接口:Cache-to-Cache,简称 C2C。
C2C 让模型交换 KV Cache。中间文本输出量为零。
论文收录于 ICLR 2026。正式版摘要给出三组结果:单模型平均准确率增幅 6.4%—14.2%,文本协作平均准确率优势 3.1%—5.4%,平均延迟加速 2.5 倍。
代码仓库开放。
社交平台称它为“脑电波直连”。这个名称有传播力,缺少技术精度。C2C 传递计算张量,内容属于模型注意力系统的中间状态。它与意识、完整思维、可读推理链属于不同概念。
新闻焦点有别于“AI 获得心灵感应”。
真正的新闻是:自然语言失去机器协作唯一媒介的地位。
文字成了 Agent 协作的收费站
大型语言模型拥有高维内部表征。自然语言是一串离散 token。模型之间的文字通信包含一次压缩与一次解压。
模型甲压缩上下文理解,产物是一串句子。模型乙编码这些句子,产物是内部状态。压缩造成细粒度特征缺失与歧义风险。token 序列解码产生等待。
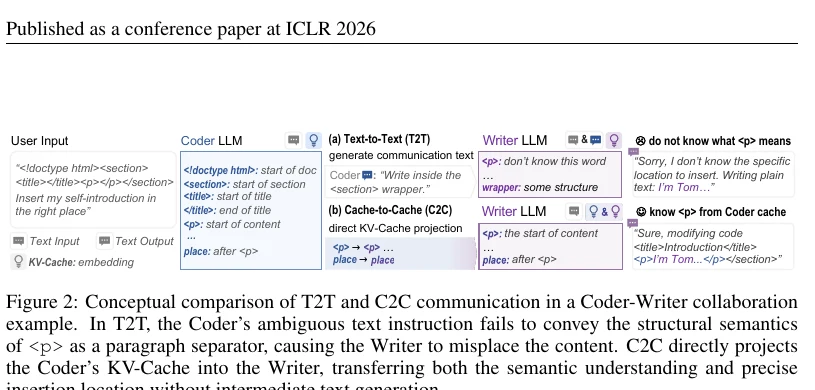
论文给出一个代码协作例子。Coder 模型理解 HTML 结构。Writer 模型接收一句“写进 section 容器”。这句提示缺少 <p> 的结构位置。Writer 放错内容。缓存融合保留了标签语义与插入位置。
这类损失源自目标错位。人类语言服务人类交流,优势包括压缩、共享、审计与跨设备传输。模型协作追求另一组目标:高带宽、低延迟、内部表征保真。
两类目标产生两类接口。
KV Cache 是模型的工作记忆
Transformer 的注意力层生成 Key 与 Value 张量。系统保存这些张量。解码器复用张量,历史 token 的重复计算归零。
KV Cache 记录模型对当前上下文的编码结果。它的信息密度高于文字,体量低于模型权重。
C2C 的通信介质是这层状态。
问题出现。不同模型拥有不同层数、隐藏维度、注意力头和分词器。Qwen 缓存与 Gemma 缓存存在空间差异。0.5B 模型与 4B 模型存在层结构差异。
C2C 的答案是一组 Neural Fuser。
Fuser:两套内部语言的翻译器
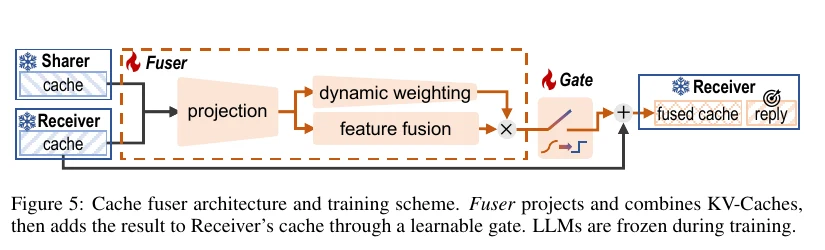
Fuser 接收 Sharer 缓存与 Receiver 缓存,完成投影、特征融合、动态加权和门控。融合结果进入 Receiver 缓存。残差结构保留 Receiver 原状态。
门控层负责层级选择。论文的预备实验发现,部分层接受外部缓存,准确率上升;另一部分层接受外部缓存,准确率下降。全层灌入存在伤害。可学习 Gate 选择受益层。
模型差异包含 token 与层的错位。C2C 采用两套对齐规则:分词结果接受字符串映射;网络层接受末端对齐。深层语义层获得优先匹配。
Fuser 参数是训练对象。Sharer 与 Receiver 权重保持冻结状态。训练损失沿用下一 token 预测目标。
这个设计揭示 C2C 的配对适配性质。通用插头这个比喻与现实存在差距。每组模型对应一套适配器。模型组合数量增长,训练成本增长。
2.5 倍来自哪一段时间
正式版论文的平均值是 2.5 倍。单组实验展示了成本来源。
Qwen2.5-0.5B-Instruct 担任 Sharer,Qwen3-0.6B 担任 Receiver。文本方案总耗时 1596 毫秒,C2C 总耗时 445 毫秒。
文本方案的 Sharer 生成 80 个输出 token,解码耗时 1312 毫秒。C2C 的 Sharer 输出 token 数是 0,缓存融合耗时 90 毫秒。
测试硬件是一张 NVIDIA A100,batch size 是 1。主任务包含 MMLU-Redux、OpenBookQA、ARC-Challenge 与 C-Eval。评测核心指标是选择题准确率。
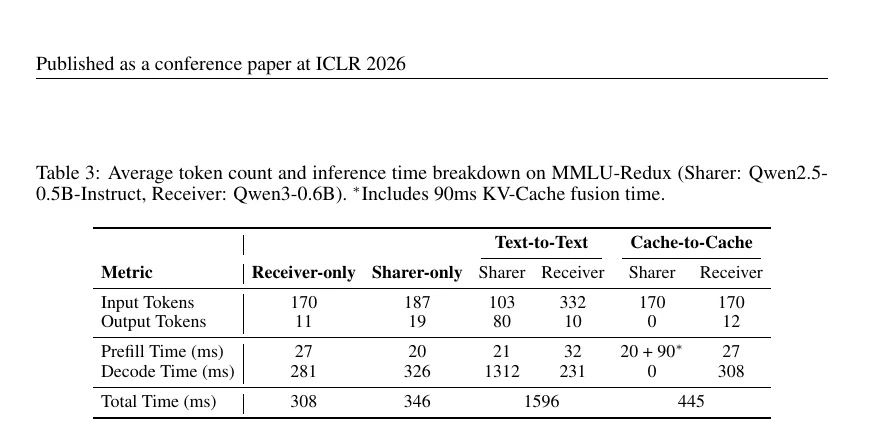
论文表 4 给出三组速度倍率:3.46 倍、1.51 倍、14.41 倍。14.41 倍对应 Qwen3-4B Base 充当 Sharer 的场景。这个基础模型产生冗长文本,文本基线耗时异常高。14.41 倍属于异常长文本场景,代表性有限。
平均 2.5 倍是论文总体结论。
Agent 基础设施出现三处换轨
第一处换轨属于协议层。
MCP、A2A 与多 Agent 框架使用文字或结构化文本。它们服务跨进程、跨厂商、跨网络协作。C2C 服务推理系统内部的模型协作。两类协议构成双层架构的候选方案。
第二处换轨属于成本层。
多 Agent 系统的大量 token 支出源于代理间解释、复述与总结。C2C 的方案是张量投影。输出 token 账单与通信等待获得压缩空间。
第三处换轨属于模型生态。
C2C 依赖 KV Cache 访问权。闭源 API 的接口范围是文本输入输出。开源权重、本地部署与同机推理拥有接口优势。缓存级接口对应新的互操作标准与安全边界。
三道边界决定产业价值
第一道边界是可靠性。
Sharer 的错误理解污染 Receiver。论文承认,弱 Sharer 与强 Receiver 的组合存在性能下降。缓存信息缺少可读文本,错误归因与人工审计难度上升。
第二道边界是扩展成本。
成对通信可行。N 个模型带来 O(N) 级适配训练成本。模型版本升级带来 Fuser 重训风险。通用缓存协议属于开放问题。
第三道边界是证据范围。
主实验集中于知识问答与推理基准。真实 Agent 工作流包含工具调用、长链任务、状态变化、失败恢复与多轮协商。复杂 Agent 场景属于后续研究方向。代码仓库提供多 Sharer 功能,项目状态标记是初步阶段。
隐私价值的证据有限。无可读文本降低内容暴露。KV Cache 本身是敏感计算状态。隐私保护依赖攻击测试、访问控制与传输安全证据。
语言层留下,状态层生长
Agent 协议栈呈现双层结构。
语言层负责人机界面、跨组织协作、日志与审计。状态层负责同一推理基础设施内的高速模型协作。
人类阅读语言。模型交换高带宽状态。
C2C 的意义超出速度技巧。它提出一个接口问题:机器智能模仿人类说话,是机器合作的必要条件吗?
论文提供一份经过同行评审的工程答案。
文字承担可读接口。缓存具备推理系统内部通信介质的候选资格。
资料来源
