Concitech AI · 深度长文
2026/09/08 21:16
中国模型进入美国生产链:工作量过了海,收入留在哪?
美国风投 Dimension 访华后提出一个尖锐判断:中国开放权重模型已经进入美国 AI 产品的生产链,但模型用量增长并不保证收入留在模型公司。Cursor、Harvey 和 OpenRouter 的公开资料,正在把这条价值链讲清楚。
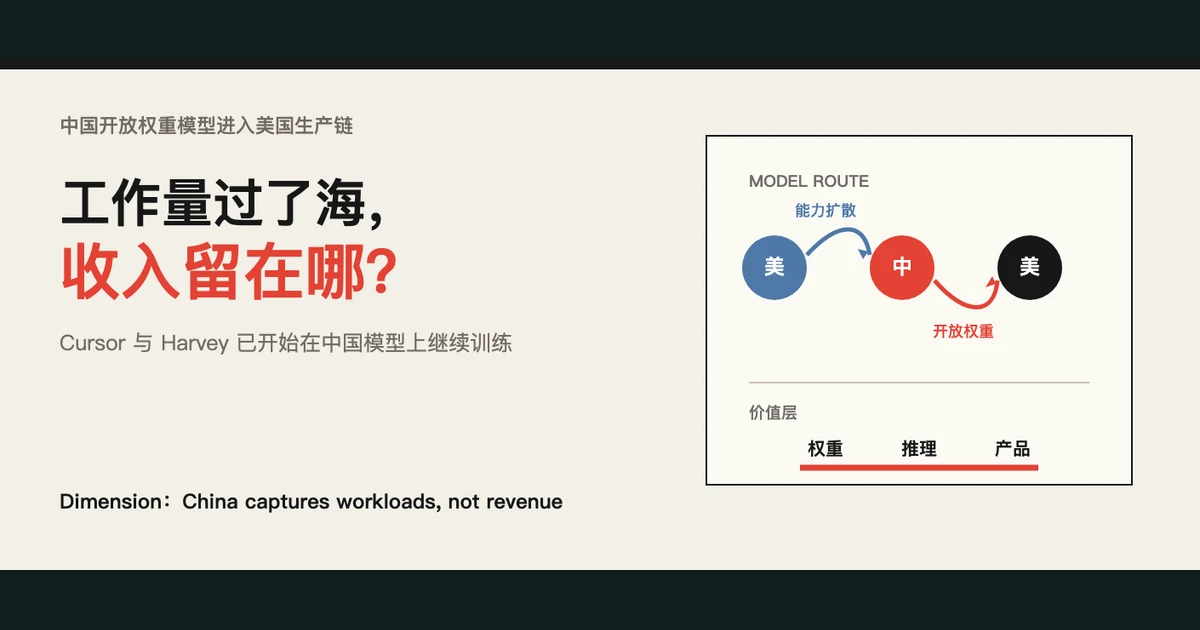
一家美国风投去北京和上海跑了一周,回来后给 LP 写了一封内部信。信里最刺眼的一句不是“中国 AI 追上来了”,而是:
China is capturing Western workloads, not Western revenue.
中国拿到的是西方的工作量,却没有同步拿到西方的收入。
这封信来自医疗与 AI 风投 Dimension,日期是 2026 年 8 月 26 日。Dimension 创始人 Zavain Dar 后来在 X 上公开了信件首页,并称团队拜访了中国的 AI 实验室、投资人和创业者。这是他们继 2025 年上海调研后的再次访华。
投资人的判断当然不是审计报告。信中部分数据来自平台统计和一份没有公开名称的美国咨询报告,不能全部独立复核。不过,它抓住了一个已经能被公司公告验证的变化:中国开放权重模型开始成为美国 AI 产品的“上游原料”。
Cursor 的 Composer 2 以 Kimi K2.5 为基础继续预训练,再做大规模强化学习;法律 AI 公司 Harvey 的 Tenet 则从 Kimi K3 出发,与 Fireworks 一起做面向长程法律任务的后训练。
模型跨过太平洋,进入美国公司的产品栈。问题随之改变:谁提供了基础能力,谁又拿走了收入?
一封内部信,提出了“工作量与收入分离”
Dimension 在信中称,中国模型在 OpenRouter 的 Token 份额不到 18 个月从低于 2% 上升到超过 45%;Qwen 在 Hugging Face 的累计下载量已经超过 10 亿。信里还引用一份 2026 年咨询报告,称约 80% 的美国 AI 初创公司在生产环境使用至少一个中国开源模型,但没有给出报告名称。
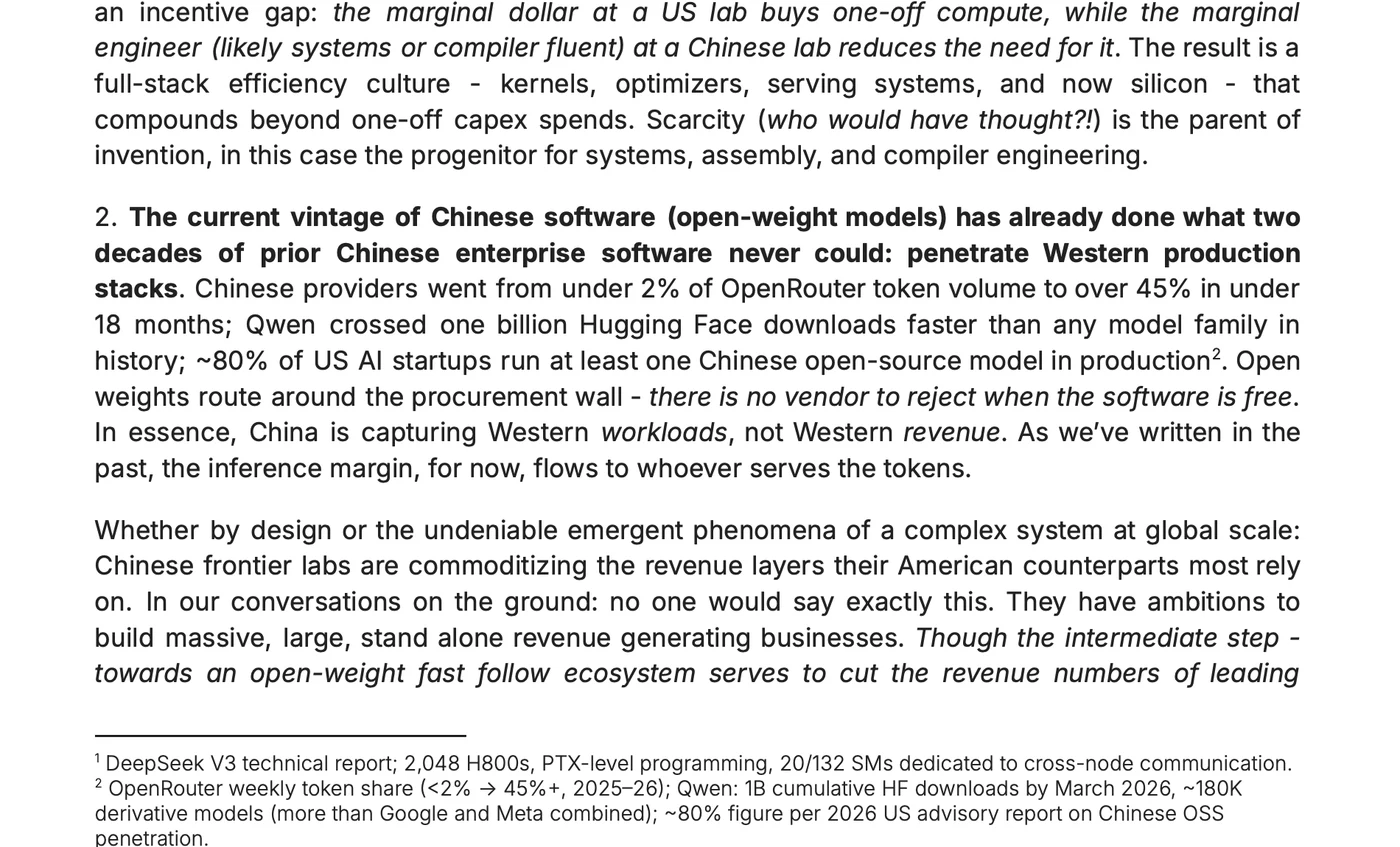
最后那个 80% 无法从公开材料独立确认,本文不把它当成行业事实。前两项的方向却能得到平台材料支持。
OpenRouter 在 2026 年 6 月的分析中称,中国模型在该平台的周 Token 份额一度超过美国模型。Hugging Face 8 月发布的开放模型报告则称,Qwen 生态在 2026 年前七个月记录了约 20.6 亿次下载,并衍生出超过 15 万个下游模型。
这些数字也有边界。OpenRouter 只代表经过该路由平台的流量,不等于整个企业 AI 市场;Hugging Face 下载会受到自动化任务、镜像和小模型重复拉取影响,也不能直接换算成真实用户或收入。
它们至少说明了一件事:开放权重降低了进入生产环境的门槛。企业不必先签一份模型厂商的闭源 API 合同,可以自己部署,也可以交给第三方推理平台托管。
采用变容易了,价值却开始分散。
Cursor 已经把 Kimi 变成自己的代码模型
Cursor 在 2026 年 3 月公布了 Composer 2 的技术报告。团队先评估 GLM-5、Kimi K2.5 和 DeepSeek V3.2 等开放模型,最后选中 Kimi K2.5,理由包括代码知识、状态跟踪、内部代码库困惑度和基础设施效率。
选中基础模型只是开始。
Cursor 随后用大量代码数据做继续预训练,把上下文扩展到 256K,再进行针对性 SFT 和异步强化学习。训练环境尽量复刻真实 Cursor 会话,包括代码库、工具和沙箱。技术报告还提到,Fireworks 为 Composer 2 提供 RL 推理基础设施。
这不是把 Kimi 换个名字接进产品。基础权重提供通用能力,Cursor 用自己的代码数据、任务分布、评估集、强化学习环境和产品反馈,把它改造成适合软件工程 Agent 的模型。
按照 Cursor 自己的基准,Composer 2 在 CursorBench-3 上得分 61.3,比基础 Kimi K2.5 的 36.0 高出不少。这个结果来自 Cursor 内部构建的评测,不能当作独立第三方结论,但它清楚展示了后训练层能增加多少专有价值。
Harvey 也走了同一条路
法律 AI 公司 Harvey 在 8 月 20 日发布 Tenet 研究预览。Tenet 以 Kimi K3 为基础,由 Harvey 与 Fireworks 共同后训练,目标是处理长时间、多步骤的法律工作。
Harvey 使用合成数据、公开法律数据和人类专家数据,让 Agent 在包含客户材料、检索工具和交付要求的沙箱中完成任务,再根据专家评分标准进行训练。
公司称,Tenet 在 LAB 留出任务上完成的任务数接近基础 Kimi K3 的两倍,在合同子集上多完成 20%。这些同样是 Harvey 报告的初步结果。文章标题写的是 Research Preview,部分能力计划逐步进入产品,不应解读为已经全面商用。
两个案例放在一起,Dimension 所说的“横跨太平洋两次”就容易理解了。
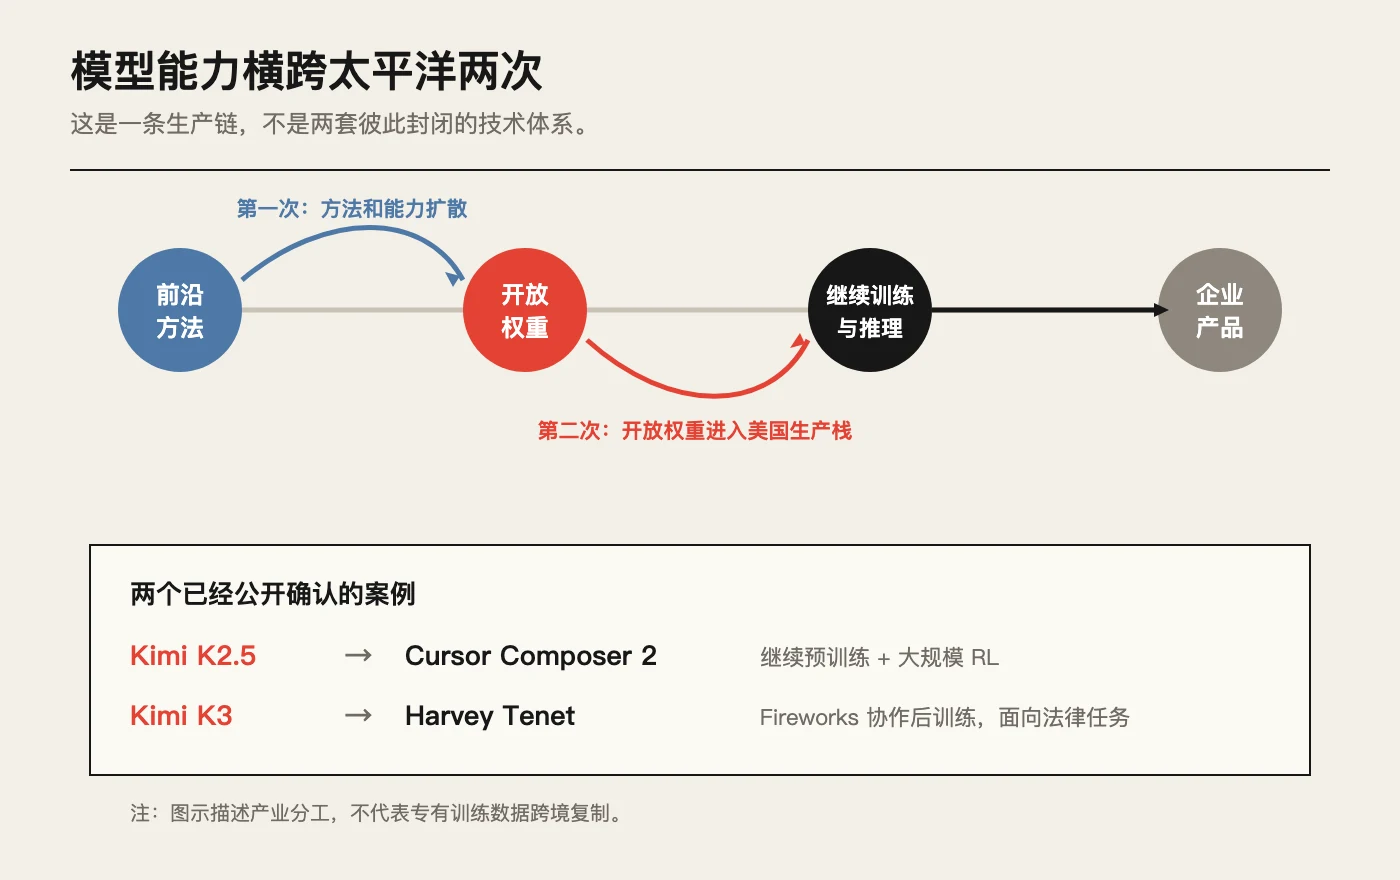
第一次是前沿方法和工程经验在全球研究社区扩散,中国实验室吸收后训练出有竞争力的模型。第二次是中国实验室开放权重,美国应用公司拿来继续训练,加入自己的数据、RL、评估和产品分发,再卖给企业客户。
这里没有一条清晰的国界线。模型、论文、训练方法、推理框架和开发者社区仍在流动。真正分开的,更多是先进芯片、数据中心建设和监管约束。
OpenRouter 流量起来了,但它没有回答收入归属
OpenRouter 的官方图表很容易让人得出“中国模型赢了”的结论。2026 年 6 月初,该平台中国模型的周 Token 份额达到 55%,美国模型为 43%。
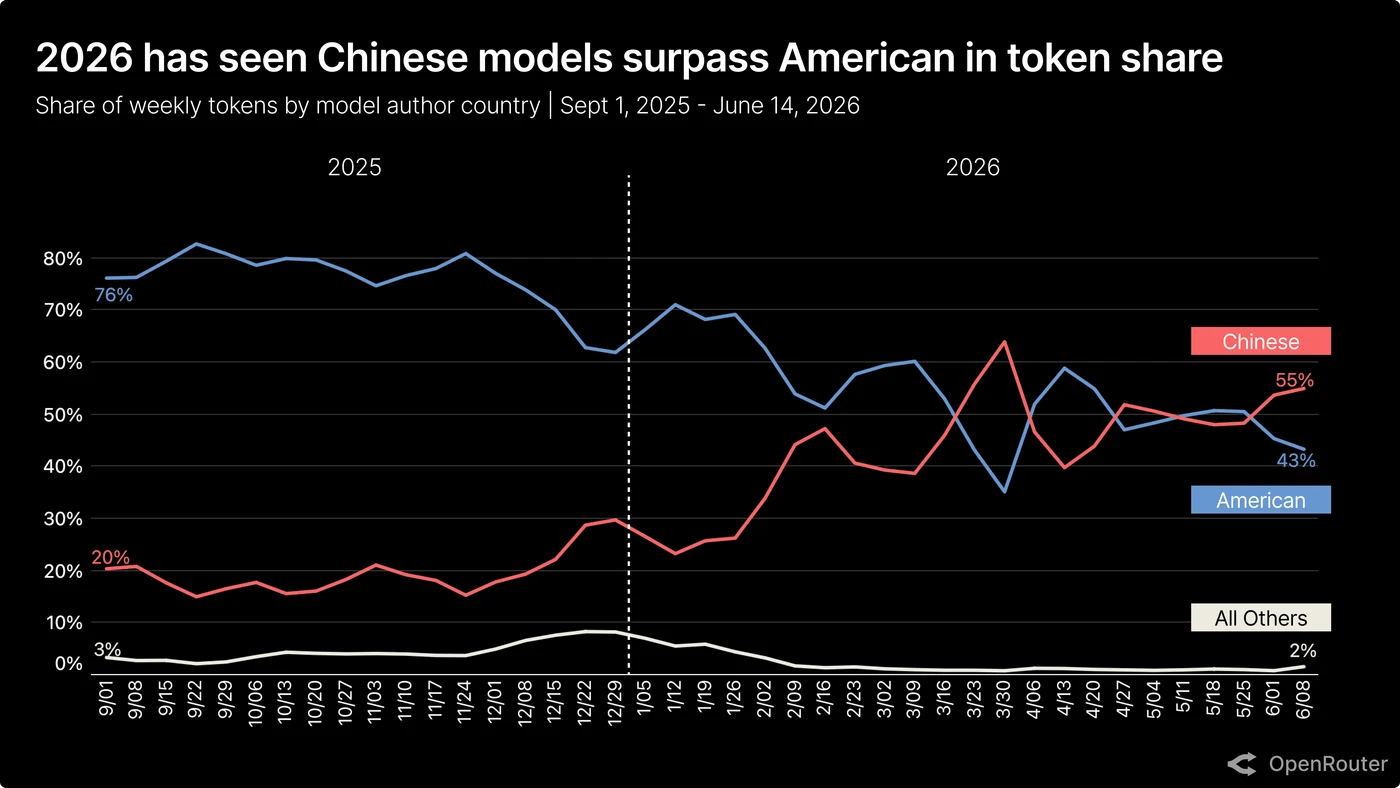
可 Token 从中国模型流过,不代表钱一定付给中国模型公司。
开放权重允许客户选择部署位置。它可以运行在模型实验室自己的 API 上,也可以运行在 Fireworks、Baseten、Modal 等推理平台,或企业自建的云环境里。模型厂商若没有承接推理服务,收入就会留在提供 GPU、吞吐优化、部署工具和 SLA 的平台。
再往上,应用公司掌握客户、工作流和定价。Cursor 卖的是开发环境与 Agent 体验,Harvey 卖的是法律工作流、专业数据和可信交付。基础模型很重要,但企业客户最终为完整产品买单。
这就是使用量与收入分离的机制。
收入到底留在哪一层
AI 产品的价值链至少可以拆成四层:基础权重、后训练与数据、推理与云、应用与分发。
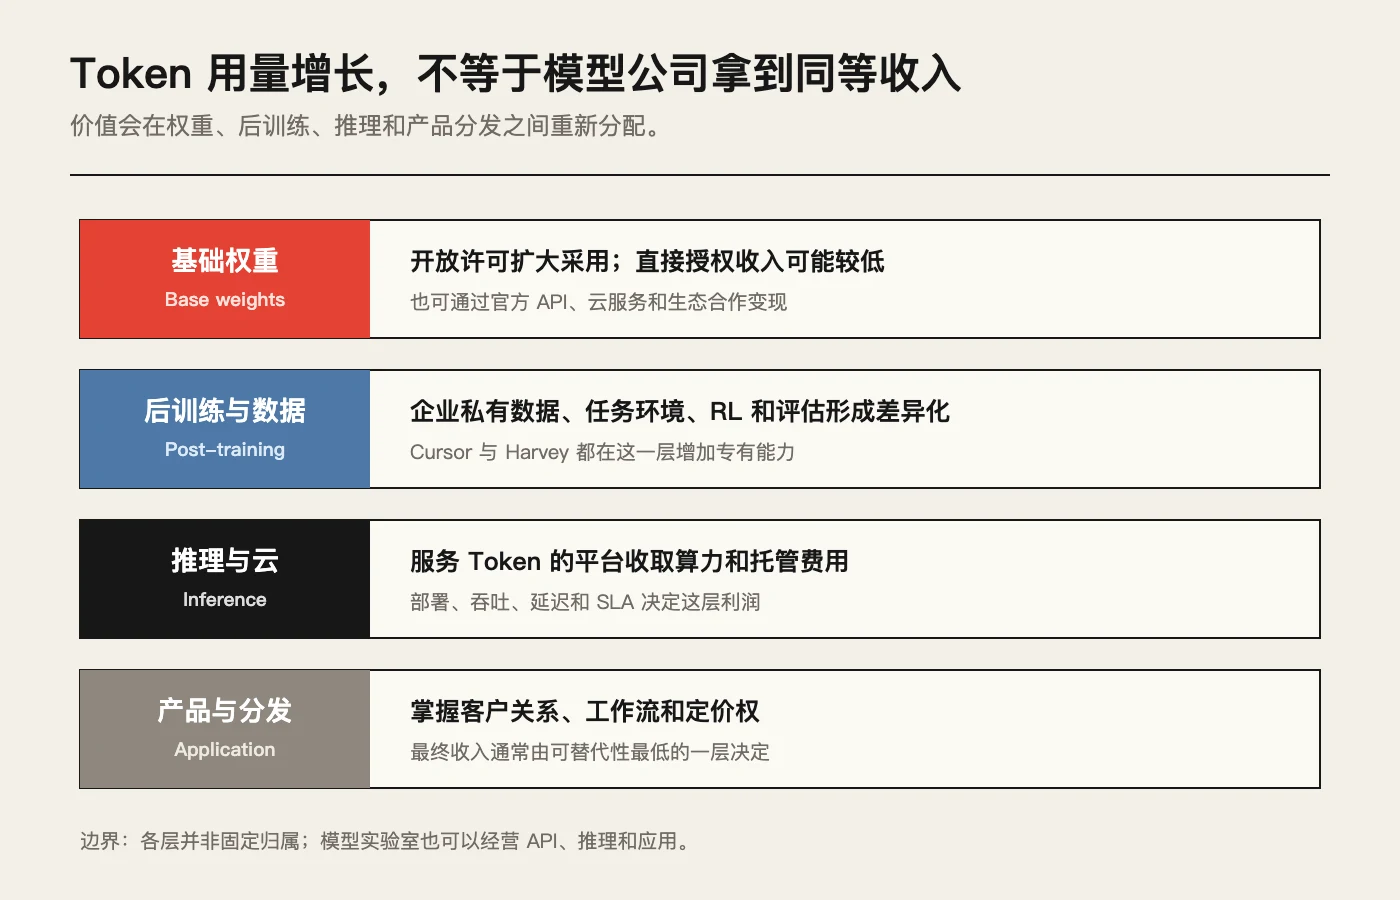
开放权重会扩大基础模型的采用,也会压低直接授权的稀缺性。模型实验室仍可通过官方 API、云服务、企业支持、硬件生态或更强的新模型赚钱,只是“被大量使用”不再自动等于“每次使用都向原作者付费”。
后训练层依赖私有数据、任务环境和评估。Cursor 有真实编程会话,Harvey 有法律专家数据和客户材料。这里形成的能力不容易被基础模型更新直接抹平。
推理层赚的是工程钱。谁能以更低成本、更高吞吐和更稳定的 SLA 服务 Token,谁就更接近持续收入。Fireworks 同时出现在 Composer 2 和 Harvey Tenet 的公开材料里,说明推理平台已经从“代跑模型”延伸到训练和优化。
应用层则掌握分发和客户关系。当模型之间越来越容易替换,嵌入工作流、积累用户反馈和承担结果责任的一方,往往拥有更强定价权。
因此,Dimension 那句“工作量,而不是收入”不是在说中国模型公司没有商业机会。它指出的是一个阶段性错位:开放策略先换来了全球采用,商业捕获还没有以同样速度跟上。
“中美 AI 谁赢了”已经是个过于粗糙的问题
如果只看模型榜单,会漏掉训练数据、推理平台、云计算和企业分发;如果只看公司收入,又会低估开放权重对整个产品栈的影响。
更有效的问题应该拆开问:谁提供基础权重?谁完成后训练?Token 在哪里运行?企业客户向谁付费?利润最高的一层是否容易被替代?
中国开放模型已经证明自己能进入美国生产栈。下一场较量要继续压低训练和推理成本,也要把全球开发者使用转化成可持续的 API、云服务、企业支持或应用收入。
美国应用公司则在享受另一种红利:用开放权重降低模型成本,把资金和数据集中到专有后训练、产品体验和客户渠道上。
硬件供应链可能继续分开,软件价值链却在交叉生长。谁赢并不取决于模型出生在哪个国家,而取决于谁能控制最难替代、也最接近客户付款的那一层。
