Concitech AI · 深度长文
2026/10/06 10:37
200 美元 AI 编程订阅:Claude 与 Codex 的额度差约五倍?
SemiAnalysis 测量 Claude 与 OpenAI 订阅的 Token 额度。约五倍的差距属于主力模型的 API 等价价值,与模型能力评分分属两类指标。OpenAI Pro 额度调整改变了比较结果。
一份 200 美元的 AI 编程订阅包含多少模型用量?套餐页面给出价格与使用进度条。Token 总额留在进度条背后。
SemiAnalysis 的订阅实测给出一个醒目的结果。主力模型的对比数值是:Claude 套餐的 API 等价价值约为 OpenAI 的五倍。研究对象是编程 Agent 工作负载,比较模型为 Claude Opus 5.5 与 GPT-6.1 Sol。额度测算与模型能力评分属于两类指标。其他模型的差距另有数值。
五倍,指的是什么
订阅额度没有统一的“每月一亿 Token”标签。输入、缓存写入、缓存读取、输出四种 Token 各有消耗规则;模型和套餐改变消耗比例。
SemiAnalysis 为每类 Token 设计独立测试。研究人员发送多轮请求,记录用量进度条的跳动幅度。每个额度窗的 Token 容量来自刻度变化与请求消耗量。报告将测得的 Token 组合乘以对应的 API 标价,得出“API 等价价值”。这个金额回答一个假设问题:相同用量的 API 账单是多少钱?
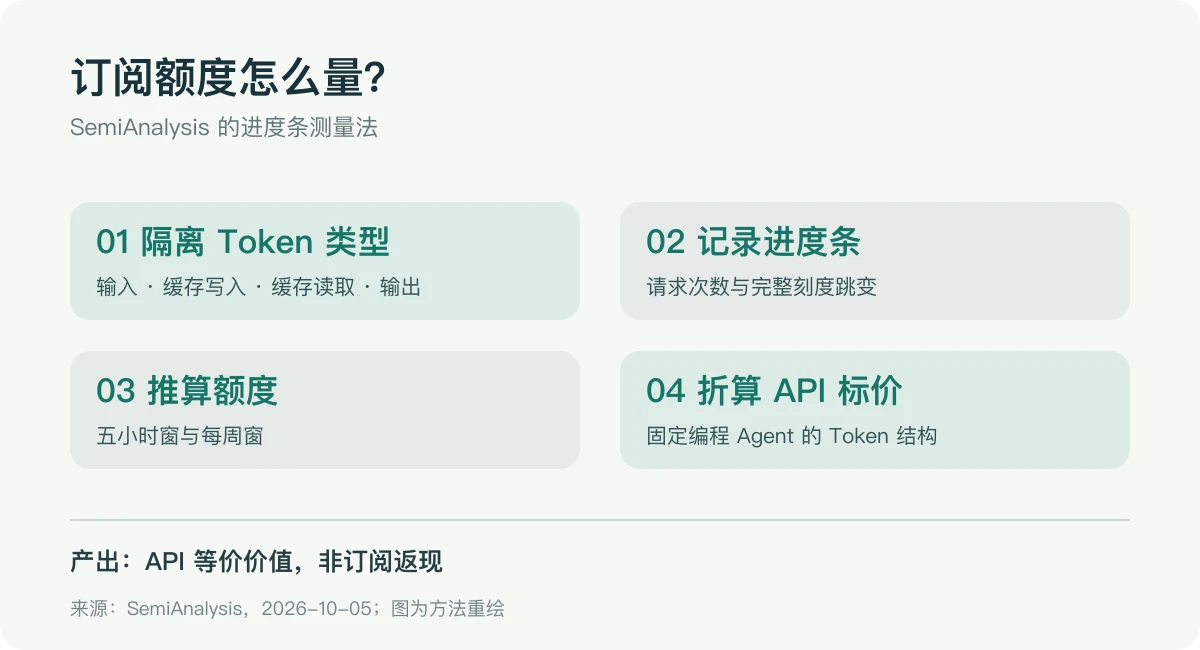
研究使用编程 Agent 的 Token 结构。长对话包含大量旧上下文的缓存读取。SemiAnalysis 的方法记录进度条整数跳变,单次请求存在测量误差;报告使用多个完整跳变区间,目标误差范围为 ±5%。
API 等价价值与套餐返现、实际节省额无关。 OpenAI 官方文档将 API 定价和订阅用量划为两套机制。API Token 价格与套餐包含的任务数之间缺乏直接换算关系。任务长度、工具调用和缓存状态会改变真实消耗。
顶配模型接近,主力模型拉开差距
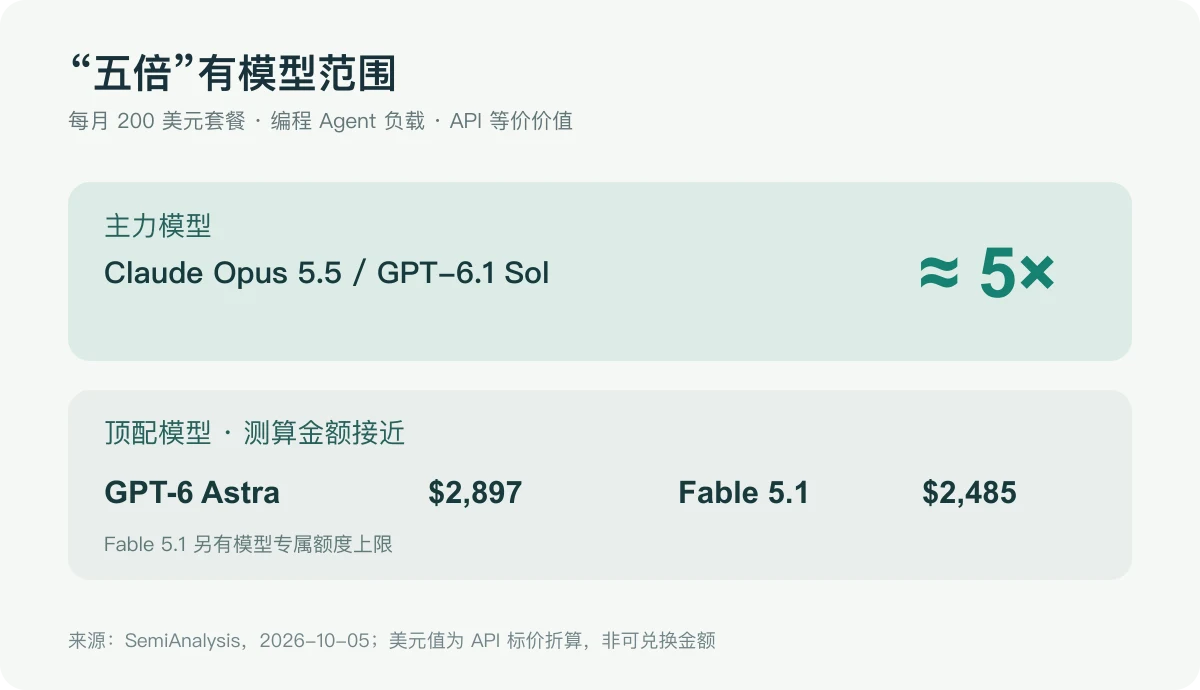
五倍差距属于主力模型对比。SemiAnalysis 报告称,Opus 5.5 相对 GPT-6.1 Sol 的 API 等价价值约为五倍。Token 数量比较呈现 Claude 的优势;报告正文没有给出统一倍数。
顶配模型的结果不同。报告给出的 200 美元套餐测算值为:GPT-6 Astra 约 2897 美元,Claude Fable 5.1 约 2485 美元。Fable 5.1 存在模型专属额度上限;其用量占整份 Claude 套餐额度的上限约为一半。两组金额指向顶配模型的接近结果,主力模型的比较结论另有边界。
模型价格会改变美元折算结果。OpenAI 的 GPT-6.1 Sol API 页列出每百万输入 Token 2 美元、输出 Token 10 美元、缓存读取 0.10 美元。Anthropic 的 Opus 5.5 文档列出相应价格为 4 美元、20 美元和 0.20 美元。相同 Token 数量对应不同 API 折算金额。
OpenAI 的 200 美元档发生了什么
这份比较撞上一次套餐调整。OpenAI 的 Tibo 公告称,200 美元 Pro 套餐的新规则对应的 API 等价额度约为旧方案的一半。SemiAnalysis 的测试记录支持这一变化。报告称,旧方案购买者保留原额度至 10 月 29 日;新购买者使用调整后的额度。
OpenAI Pro 没有五小时额度窗,官方定价文档确认这一点。Claude 的 Max 套餐包含滚动五小时额度窗和每周额度窗。额度总量与使用节奏共同影响套餐体验:高强度任务与分散任务会遇到不同的限制。
SemiAnalysis 发现,同一供应商的三个同款测试账号中,一个账号的额度低约 20%。供应商向研究团队确认,该账号属于小范围 A/B 测试。订阅额度具有变动性;一次测量无法充当永久价目表。
用户该看哪张账单
订阅选择需要三组数据:模型产出的可用程度、任务完成量、额度重置节奏。五倍的 API 等价差距回答的是额度问题。项目完成率属于另一组数据。Claude 的 Token 优势与工作量优势缺乏固定倍数关系;Codex 的 Token 数量与产出质量缺乏固定比例。
这份实测的核心价值,是揭示订阅产品的计价方式:月费固定,模型级额度浮动,缓存价格和厂商规则改变最终结果。200 美元不是一张统一的 Token 兑换券。它是一组模型、额度窗和工作负载的组合。
