Concitech AI · 深度长文
2026/09/02 07:49
Claude Fable 5.1 上线:缓存便宜 75%,安全监控数据由企业自己保管
Anthropic 同时发布 Claude Fable 5.1 与 Mythos 5.1。跑分提升只是表面,真正影响企业采用的,是 Agent 长任务成本下降,以及 Enterprise Frontier Safeguards 把安全监控数据、密钥和人工复核交还给客户。
Anthropic 又更新了 Claude。
这次同时出现了两个名字:面向广泛用户的 Claude Fable 5.1,以及只向经过审核的网络安全、生命科学等机构开放的 Claude Mythos 5.1。它们底层是同一个模型,区别主要在安全措施与访问门槛。
最容易传播的消息当然是跑分。Fable 5.1 在 Anthropic 自己的 Terminal-Bench-Science 0.1 测试中拿到 52.6%,上一代 Fable 5 是 24.7%。但如果只把这次更新理解成“性能翻倍”,会错过更重要的部分。
Anthropic 正在处理企业采用前的三道门槛:模型能不能完成长任务,一次任务到底要花多少钱,敏感数据又由谁保管和审阅。
先看能力,但别把一张表当成全部答案
在 Anthropic 公布的评测中,Fable 5.1 在多项 Agent 与科研任务上都有明显提升。
Terminal-Bench 4.0 测试的是模型在终端环境中完成真实任务的能力,Fable 5.1 得分 55.8%,Fable 5 为 42.0%;限制更少、面向受信任机构的 Mythos 5.1 达到 60.9%。AutomationBench 上,Fable 5.1 从上一代的 17.1%升至 31.4%。
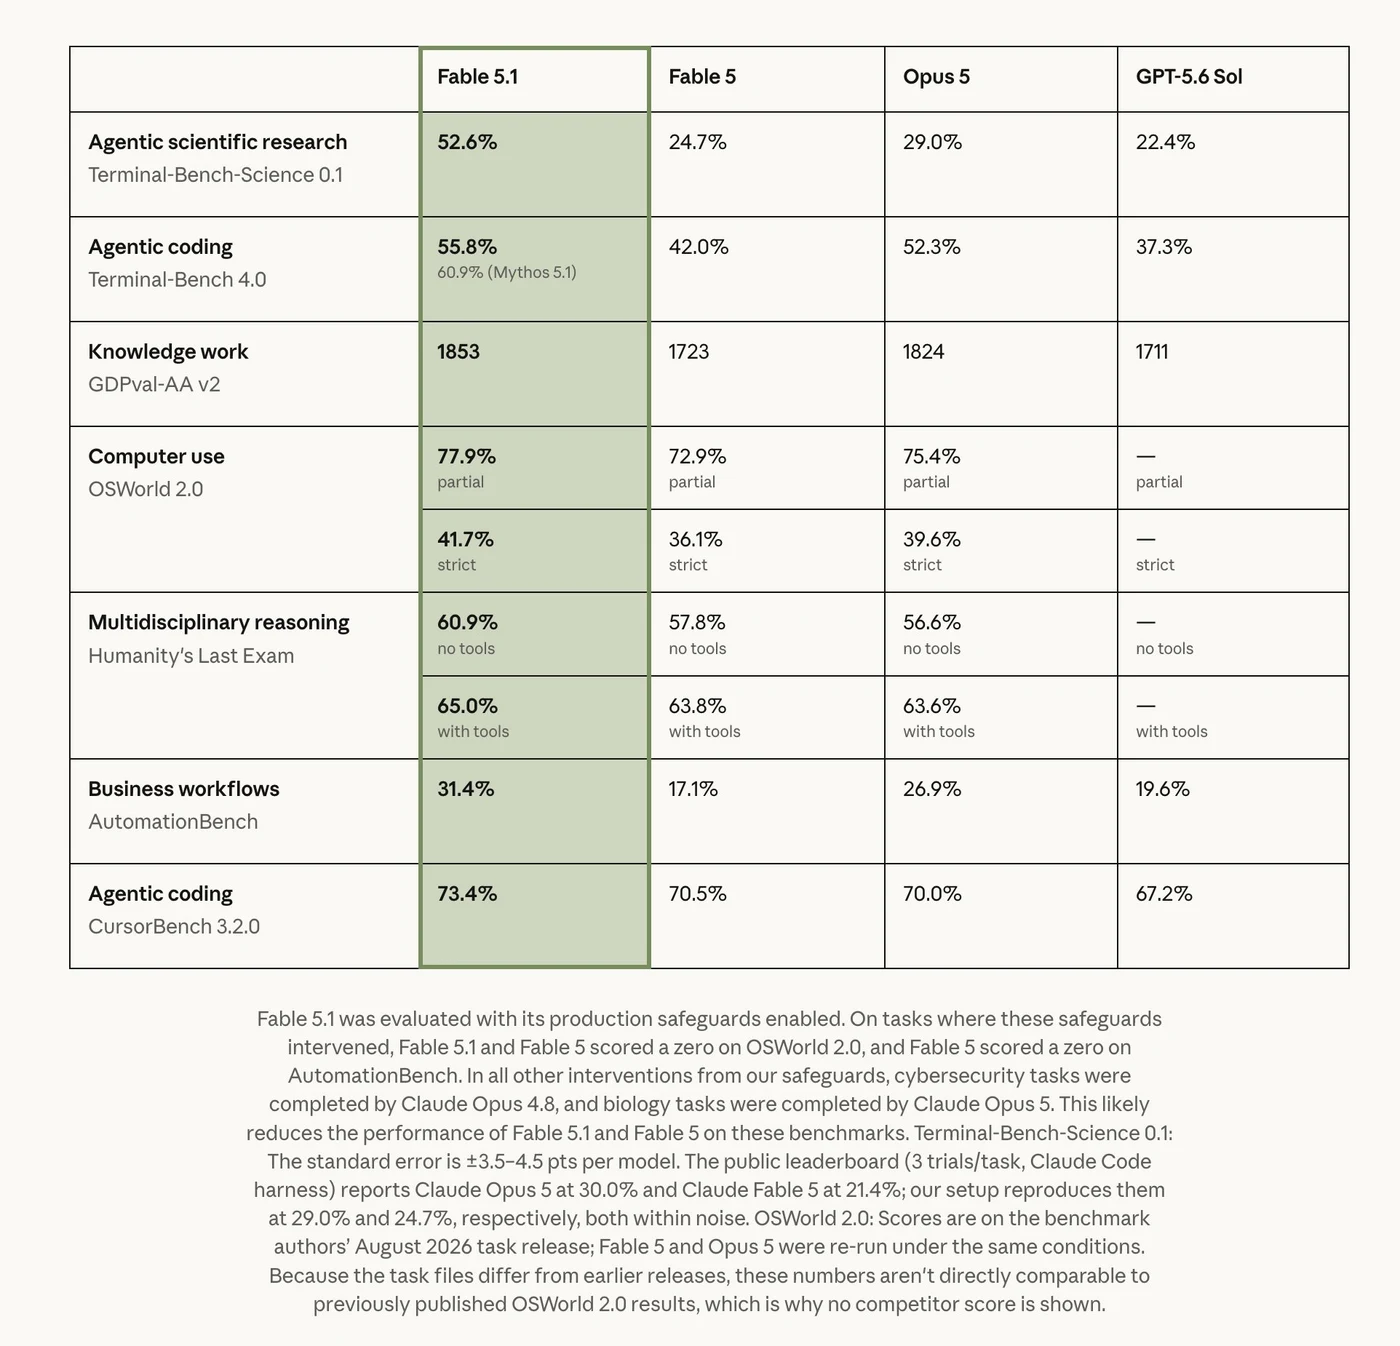
这些数字说明模型在工具使用、长任务推进和科研环境中的能力可能跨过了一个台阶,但仍需留意两个边界。
第一,数据来自 Anthropic 官方测试,并非全部由独立第三方复现。以 Terminal-Bench-Science 为例,官方也注明了标准误差;上一代的公开榜单成绩与 Anthropic 复测结果存在小幅差异,但仍处于统计波动范围内。
第二,安全策略会直接影响 Agent 的得分。模型发现高风险操作后,可能拒绝继续,或回退到受限模式。同一个底层模型,采用不同防护和访问机制,最终表现就会不同。Mythos 得分更高,并不能简单理解为“更聪明”,其中也包含使用边界更宽带来的差异。
所以,跑分适合用来判断方向,不适合替代真实业务试验。企业更该观察的是:模型能否在自己的代码库、工具链和权限规则下,稳定完成整个任务,而不是在某个基准上多拿几分。
真正改变 Agent 账单的,是缓存价格
Fable 5.1 的输入和输出价格没有变化,仍是每百万 Token 10 美元和 50 美元。真正大幅降价的是缓存读取:从每百万 Token 1 美元降到 0.25 美元,降幅 75%。
这看起来只是计价表里的一行,对 Agent 产品却很关键。
普通聊天常常是一问一答;Agent 会反复读取系统提示、代码仓库摘要、工具说明和此前的任务历史。一次长任务可能调用模型几十次,大段固定上下文会在每一轮重新出现,累积成主要开销。
缓存把重复上下文保存下来,后续调用只按更低价格读取。Agent 循环越长、共享上下文越大,缓存的影响越明显。
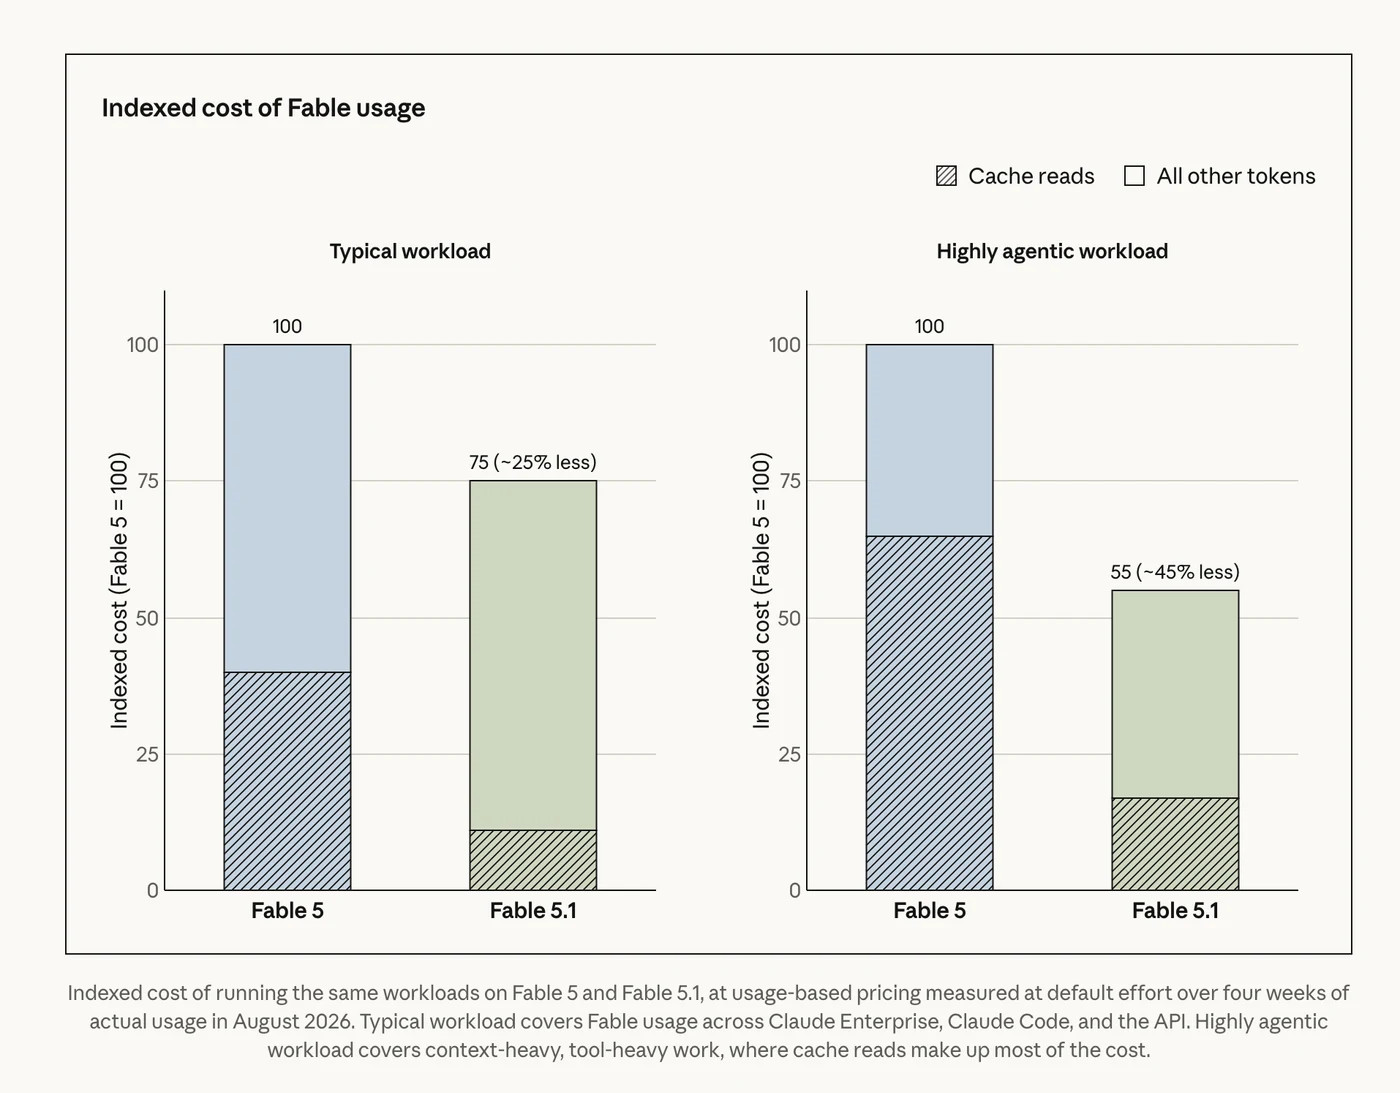
Anthropic 根据 2026 年 8 月连续四周的实际使用数据估算:典型工作负载的总成本可下降约 25%,高度 Agent 化的工作负载可下降约 45%。这不是对每个客户的统一承诺。缓存命中率、输出长度和任务结构不同,最终账单也会不同。
但它指出了一个比“Token 单价”更有用的指标:完成一次任务的总成本。
模型更贵,却能减少重试、缩短工具调用链,可能反而更便宜;模型标价不变,但缓存成本下降,也可能让过去不划算的长任务进入生产。未来企业比较模型,不会只看每百万 Token 的价格,而会看完成一个工单、一次代码迁移或一份研究报告究竟需要多少钱。
数据留在谁手里,是另一道更硬的门槛
Anthropic 此前为 Fable 5 引入了默认 30 天的数据保留期,用于发现大规模网络攻击和生物安全滥用。这个安排有安全理由,却会让处理源代码、客户记录或研发资料的企业犹豫。
新推出的 Enterprise Frontier Safeguards,简称 EFS,试图同时满足安全监控和企业数据控制。
在这套方案中,用于安全监控的活动数据存放在客户自己的云账户,可以使用客户自己的密钥、权限和审计机制。自动化系统在滚动时间窗口内分析风险信号,发现异常后把告警交给客户,由客户自己的人员复核。按照 Anthropic 的说明,默认不需要其员工查看客户数据。
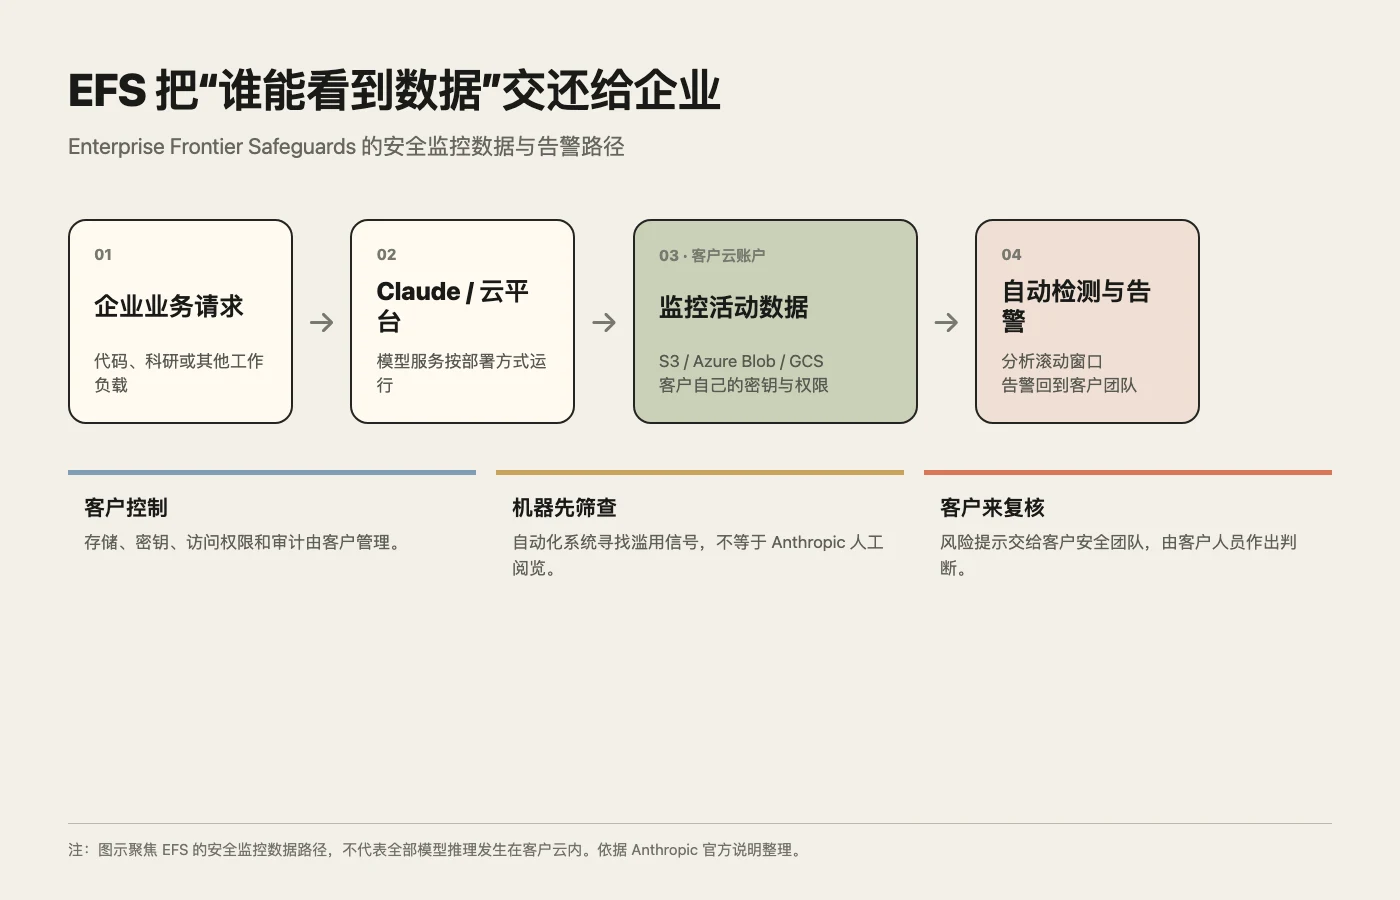
这里需要说准确:EFS 解决的是安全监控相关数据的存储、访问和复核问题,并不意味着全部模型推理都在企业自己的云里完成。企业仍需根据实际部署方式,确认跨境、地域、日志、备份和供应商访问等合规细节。
EFS 计划在 2026 年秋季分阶段推出,Anthropic 称已有超过 100 家客户参与共创。符合条件、正在等待 EFS 的企业可以暂时获得零数据保留安排。Anthropic 不额外收取 EFS 费用,但客户需要承担自己的云存储成本。
“零留存”只是表象,责任边界的变化更关键:模型公司继续做自动化滥用检测,数据、密钥、审计和人工判断则回到客户手中。
同一个模型,为什么要拆成两个产品
Fable 5.1 与 Mythos 5.1 共用底层模型,却采用不同的防护强度,这可能比模型名称本身更有行业意义。
面向普遍用户的 Fable 允许正常的漏洞发现和防御研究,但会阻止生成可直接利用的攻击能力。面向受信任机构的 Mythos 则在经过审核的环境中放宽部分限制,让专业团队处理原本容易触发拦截的网络安全与生命科学任务。
过去,模型公司常试图用一套统一规则服务所有人。结果要么过松,增加滥用风险;要么过严,让有正当需求的研究者也无法工作。Fable 与 Mythos 的做法,是把能力和访问治理拆开:模型保持一致,风险更高的能力通过机构审核、数据控制和责任机制开放。
它并没有消除风险,只是把“谁能用、在什么环境里用、出了问题谁来复核”变成产品设计的一部分。
三个科研案例,展示的是端到端工作能力
Anthropic 还公布了几项与合作伙伴完成的科研实验。
在蛋白质设计中,Mythos 5.1 生成的部分结合物在三个目标上达到对照设计约 10 倍的亲和力;跨 12 个目标的命中率接近 50%,高于文中所称常见的 10%至 15%,结果由外部实验室验证。另一项工作中,Fable 5.1 帮助制作金星地形图,将细节从约 10至20 公里提高到 2至3 公里。模型还优化了 7 个深度学习生物模型的计算内核,部分速度最高提升 2.5 倍。
这些案例仍主要来自 Anthropic 与合作伙伴的报告,不能自动外推到所有科研任务。尤其是内核代码,官方表示“即将开源”,在真正发布、复现之前应视为预告。
不过,它们透露了模型竞争正在改变的方向。重要的不只是回答一道题,而是能否读资料、调用工具、生成候选方案、接受实验反馈,再继续迭代。科研与企业 Agent 的共同难点,都是把一次漂亮回答变成可验证的完整工作流。
这次发布最值得记住的,不是 52.6%
Fable 5.1 的评测提升会带来关注,但企业是否真正采用,最终取决于三个更现实的问题:能不能完成任务,完成一次要花多少钱,数据与责任边界是否可控。
Anthropic 这次同时调整模型、缓存价格和企业安全架构,说明前沿模型的竞争正在从“谁更聪明”进入“谁能稳定进入生产”。
跑分决定一款模型会不会被测试。成本结构和数据控制权,才决定它能不能留下来。
参考资料
- Anthropic, Introducing Claude Fable 5.1 and Claude Mythos 5.1
- Anthropic, Claude Fable
- Anthropic, Claude Mythos
- Anthropic, Enterprise Frontier Safeguards
- 宝玉, 原始推文
