Concitech AI · 深度长文
2026/09/08 21:16
CLAUDE.md 的灾难性记忆:规则增长 226%,理由失踪
一篇 arXiv 论文追踪 1867 个代码仓库和 247694 段指令生命史。规则数量增长,删除概率下降。实验发现:故障、假设和结果组成维护证据。维护证据压缩冗余,提升指令执行率。
一个智能体犯错。开发者添加一条规则。
另一个智能体犯错。开发者添加另一条规则。
数月迭代产生一堵规则墙。团队记得规则,团队忘了理由。任何一句话的删除是一场冒险。
论文《Why Does CLAUDE.md Keep Growing?》命名了这种现象:灾难性记忆。
机器学习讨论“灾难性遗忘”。模型获得新知识,旧知识发生丢失。智能体指令文件出现相反问题:规则留下,产生规则的因果背景消失。
sleepy0x13 的帖子抓住了论文结论。帖子的“99.3%”存在口径问题:该数字代表冗余增长降幅。提示词总长度降幅属于另一项指标。
1867 个仓库的规则生命史
作者 Kushal Chakrabarti 分析了 1867 个公开 GitHub 仓库。样本文件包含 CLAUDE.md、AGENTS.md 和 copilot-instructions.md。
数据集包含 1801 个多版本文件、299440 次版本迁移和 247694 段指令生命史。
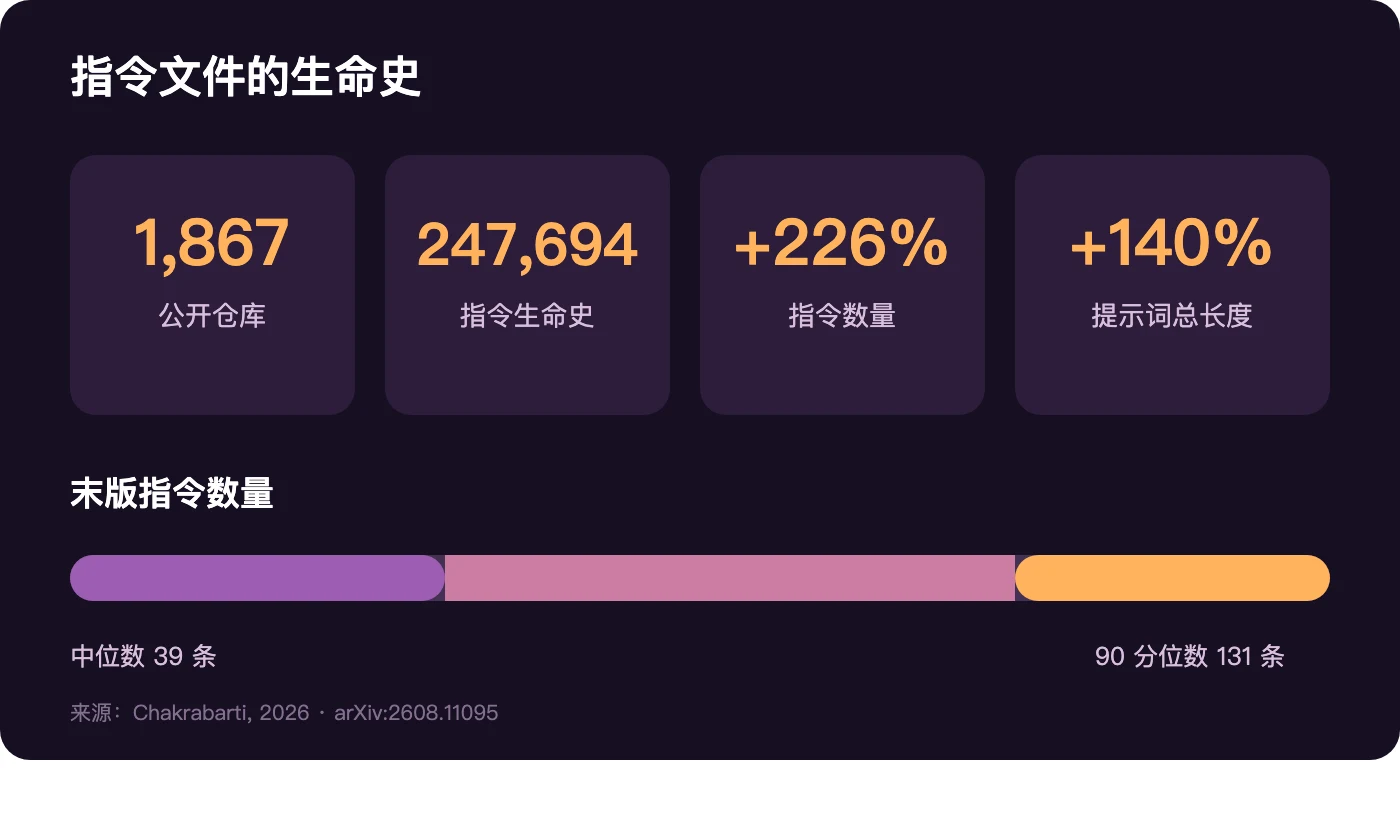
论文语料规模和规则增长指标。
多版本仓库共有 1576 个。64.3% 的仓库出现指令增长,26.6% 出现指令收缩。末版指令的中位数是 39 条,90 分位数是 131 条。
归一化生命轨迹给出三个结果:
- 指令数量增长 226%;
- 平均指令长度增长 10%;
- 提示词总长度增长 140%。
大规模重写之外的 19267 次提交产生 4.9 条指令的净增均值。
年龄与删除概率呈负相关。删除风险的对数斜率是每次提交 -0.032。
规则获得一种制度性寿命。团队缺少删除证据,保留成为默认选择。
大扫除带来锯齿曲线
论文定义了一类“整体重写”。门槛是一次提交删除 50% 的存活指令。风险指令门槛是 5 条。
76.8% 的指令死亡发生于一次文件清扫。重写终点的文件规模是原值的 59.5%。十次提交周期终点的文件规模是原值的 91.5%。
重写前的增长率是每次提交 4.1%。重写后的增长率是 4.9%。
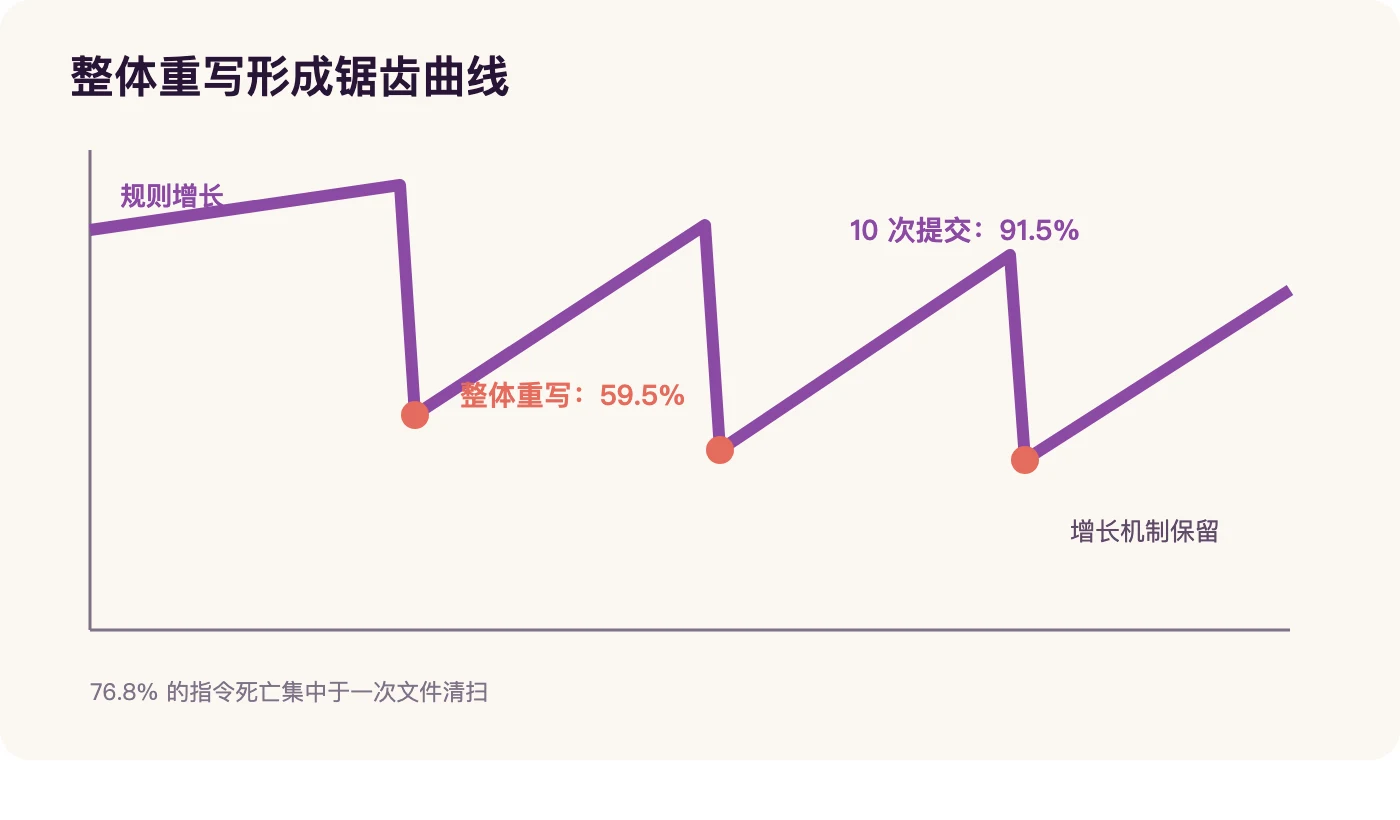
清扫压低规则数量。增长机制维持原状。规则回潮。
这个结果解释了一个常见体验。团队删掉半份指令文件。新事故制造新规则。文件恢复膨胀。
清扫解决存量。因果记忆解决增量。
删除为什么比添加困难
添加规则的证据是一个失败样本。删除规则面对另一个问题:它保护过什么?
论文使用一个复杂度模型描述差异。添加一条规则的验证成本是 O(1)。缺少规则理由的删除验证包含多个规则子集测试。理论上限达到 O(2^|D|)。
理论模型与仓库成本测量属于两类证据。模型表达一种组织现实:故障记录消失,删除者承担旧因果链发现任务。
代码拥有版本历史、提交说明、测试和评审记录。指令文件的常见内容是命令句。命令句保存结论,历史背景掉出上下文。
Prompt Comments 保存因果证据
论文提出 Prompt Comments。每条规则携带三类维护信息:故障、假设、结果。
执行智能体接收规则。维护智能体读取规则与注释。执行上下文排除注释。
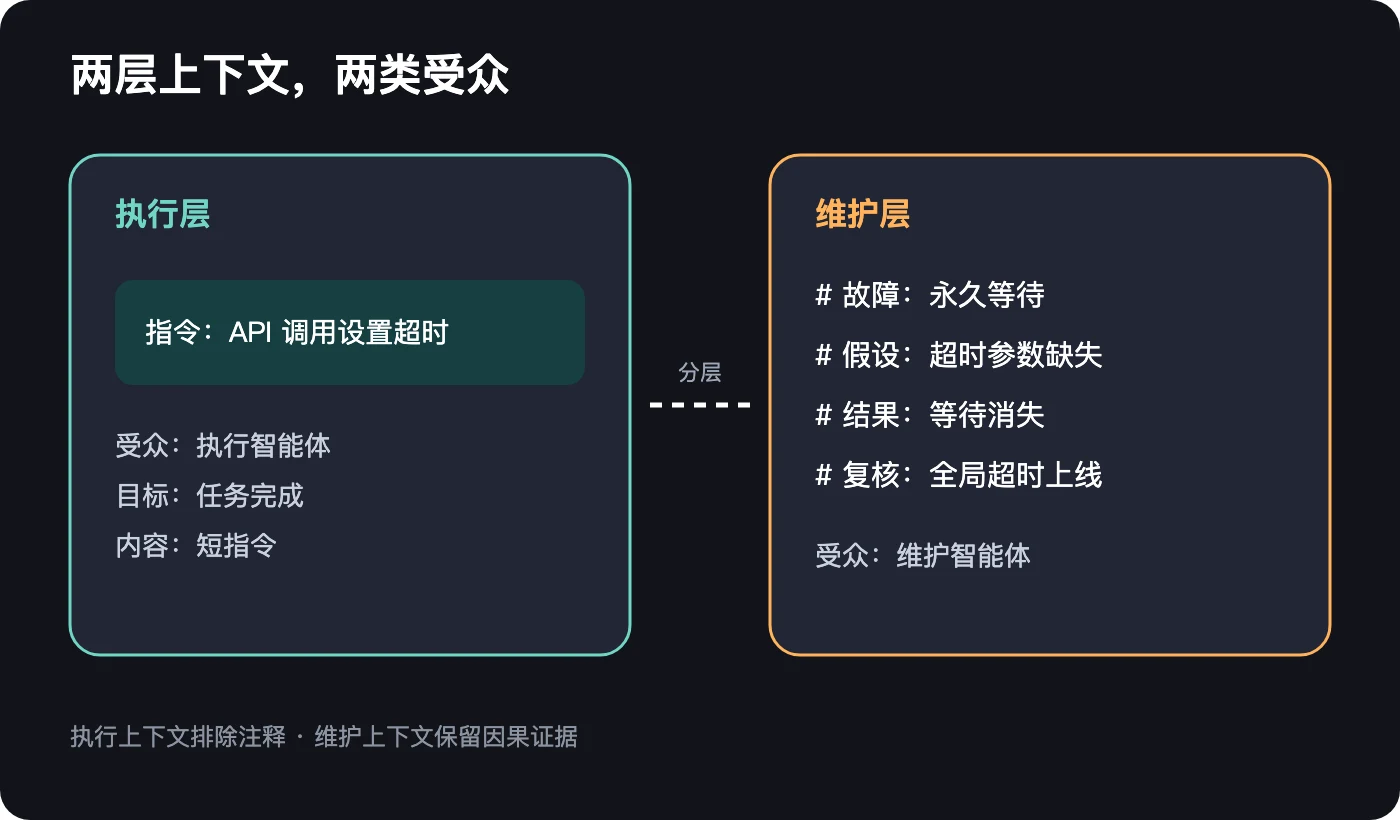
指令服务执行智能体。注释服务维护智能体。
简化格式:
- 指令:API 调用设置超时。
  # 故障:任务进程出现永久等待。
  # 假设:客户端缺少超时参数。
  # 结果:30 秒超时消除永久等待。
  # 复核:客户端库提供全局超时后,检查本规则。
关键设计超越“写更多注释”。关键设计是分离两个受众。
执行层承载短指令。维护层保存因果证据。构建工具负责剥离注释。维护流程负责读取注释。
99.3% 的统计口径
作者构造了 51 轮受控实验。环境拥有已知的最优指令集。每轮结果决定维护智能体的提示词修改。
无注释组的冗余增长达到 211.3%。有效注释组的冗余增长是 1.4%。两组末三轮的约束满足率是 44.0% 和 44.0%。
“99.3%”是两个冗余增长数字的相对降幅。文件总长度降幅属于另一项指标。真实仓库实测属于另一类实验。
形似注释的噪声组出现 147.9% 冗余增长。格式本身缺少效果。失败原因和验证结果构成有效信息。
WildIFEval 实验加入 16 条干扰规则。无注释组的满足率是 50.4%。有效注释组达到 62.0%。绝对增幅是 11.6 个百分点,相对增幅是 23.1%。
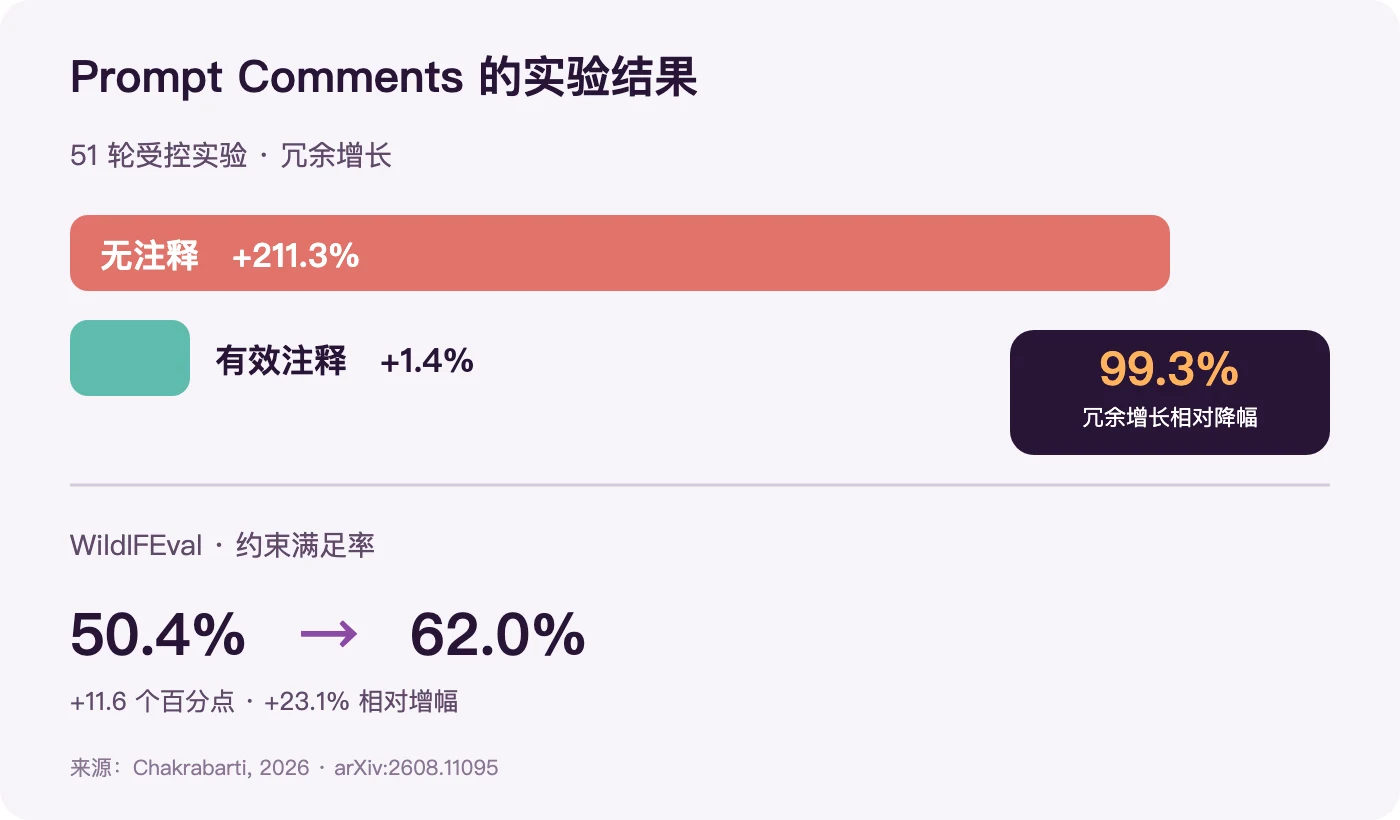
99.3% 指冗余增长降幅。23.1% 指满足率相对增幅。
证据边界
这篇论文是一篇 arXiv 预印本。作者人数为一人。同行评审状态属于空白。
仓库研究使用 50 组人工标注迁移验证匹配器。样本迁移总量是 299440。验证规模是 50 组。
受控环境的最优提示词包含 2 至 3 条指令。真实仓库的中位数是 39 条。两者规模存在 13 至 20 倍差距。
WildIFEval 使用大模型裁判。第二个裁判复制了方向。裁判属于代理指标。
论文覆盖仓库级指令文件。语料范围止于这类文件。系统提示词、技能文件和企业内部规则库属于范围外对象。
作者保留人类删除关口。安全规则获得单独测试。独立授权是自动删除的前置条件。
一份团队指令账本
每条规则包含五个字段:责任人、触发故障、因果假设、验证结果、复核条件。
规则状态分成三类:保护中、待复核、可删除。状态变化拥有测试记录。
团队指标包含四项:规则总数、无理由规则占比、重复规则占比、过期规则占比。
这个制度促成 CLAUDE.md 的资产化。规则拥有出生证明和退出条件。
我的判断
智能体编程提高了规则生产速度。组织记忆的升级速度落后。这个差距制造提示词债务。
论文的核心贡献超越一个注释格式。它提出了一条设计原则:执行上下文与维护上下文形成分层。
短提示词服务任务完成。因果档案服务规则治理。
规则增长 226% 是症状。理由失踪是病因。
