Concitech AI · 深度长文
2026/10/08 08:22
DeepSeek 长文检索的“相位弱点”:字节论文测出四 Token 周期
字节 Seed 论文发现分块 KV 缓存模型的周期性检索差异。DeepSeek-V4 基础模型的最大相位差距为 40.2 个百分点,后训练版本为 19.1 个百分点。本文解析实验、机制与边界。
一段代码,末尾缺少一个数字。正确答案是 FP8 中的 8。研究者改变了开头装饰性注释的长度;代码主体保持原样。DeepSeek-V4-Flash-Base 的候选答案出现 8 与 32 的切换。答案序列呈现四 Token 周期。
字节跳动 Seed 团队的论文给这种现象起名“相位敏感性”。研究对象包含 DeepSeek-V4、V4.1 与一组研究者训练的模型。论文的核心问题是:压缩窗口中的信息位置是否改变检索结果?
答案是会。数字需要分开读:40.2 个百分点的最大差距来自 V4-Flash 基础模型;V4-Flash 后训练版本的差距是 19.1 个百分点;V4.1-Flash 的差距是 6.1 个百分点。它们属于同一篇论文的不同模型结果。
四个 Token,为什么构成一个周期
长上下文推理需要 KV 缓存。历史 Token 的键和值占用显存。上下文增长带来注意力计算成本增长。分块压缩将连续 Token 汇成较少的缓存条目。DeepSeek-V4 的压缩稀疏注意力采用八 Token 窗口、四 Token 步长;V4.1-Flash 的步长是两 Token。
窗口宽度决定一条摘要覆盖多少 Token。步长决定下一条摘要的起点。两个数字属于不同参数。推文采用“几个 Token 捆成一包”的比喻;论文的 V4 配置包含重叠窗口。独立打包的比喻缺少窗口重叠这个细节。
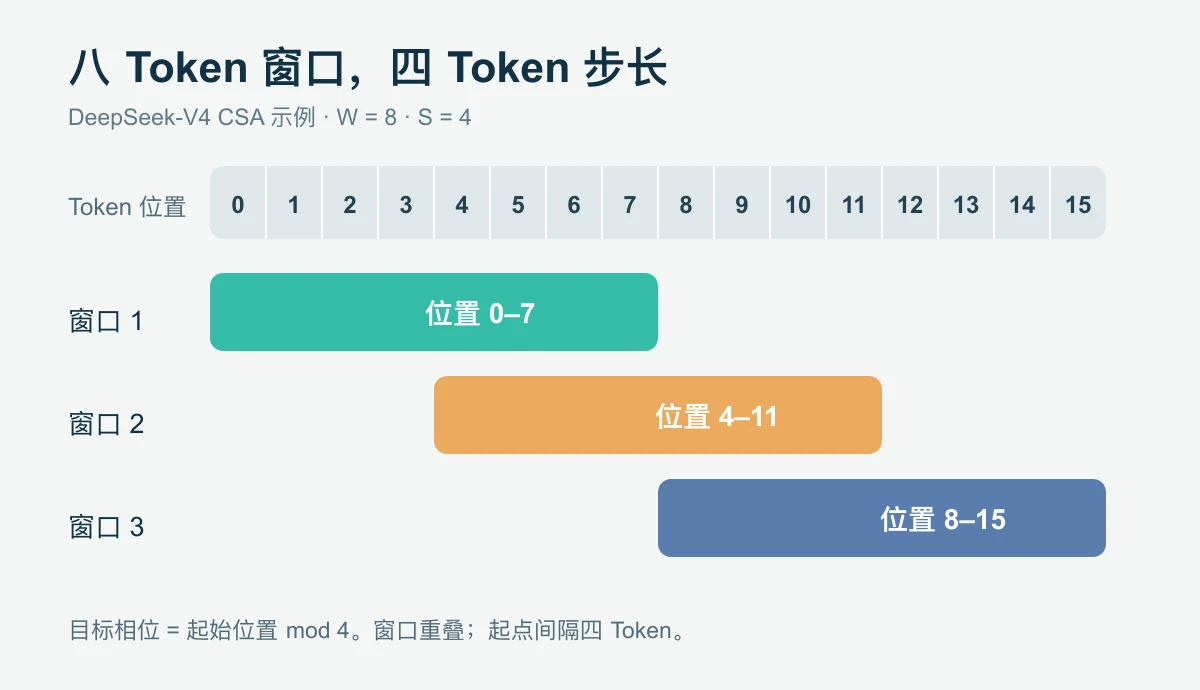
图:论文 W=8、S=4 配置示意。窗口宽度与步长属于不同参数。
论文把目标信息的起始位置记作 t,压缩步长记作 S,相位是 t mod S。V4 拥有四种相位。信息语义保持原样;前缀长度的变化改变信息与压缩窗口的相对位置。缓存条目保存的信息发生变化。
传统的“信息藏在长文中间”关注长文的开头、中间与结尾。相位问题关注压缩窗口内的位置。相位的重复周期等于压缩步长。
一行注释,代码补全出现反转
论文图 1 使用 DeepSeek 自己的 FP8 推理代码。提示词末尾是 T.Cast(FP。代码语义要求补出 8;32 的补全跳过 FP8 舍入步骤。
研究者改变前置注释中的等号数量,形成 16 个长度不同的输入。L mod 4 为 0 或 1 的八个输入偏向错误的 32;余数为 2 或 3 的八个输入偏向正确的 8。模型偏好每两 Token 翻转,四 Token 构成完整周期。
论文附录包含其他注释样式、Shell 测试和 SQL 例子。后训练模型具有类似的周期性反转。这个代码实验显示位置变化与具体答案的关联;真实软件项目的总体错误率属于论文缺项。
40.2 个百分点:基础模型的数字
论文的长文检索实验使用 128K Token 提示词。每份提示词包含 1.6 万组键值对,问题要求模型找出指定键的值。研究者保留键值绑定、提示词长度和查询位置,改变目标键的相位。评测把位置分成八组,用于覆盖 V4 的两个四 Token 周期,以及 V4.1 的四个两 Token 周期。
| 模型检查点 | 相位最佳与最差成绩之差 |
|---|---|
| V4-Flash-Base | 40.2 个百分点 |
| V4-Flash-0731(后训练) | 19.1 个百分点 |
| V4-Pro-Base | 34.8 个百分点 |
| V4-Pro-0813(后训练) | 14.8 个百分点 |
| V4.1-Flash-0910(后训练) | 6.1 个百分点 |
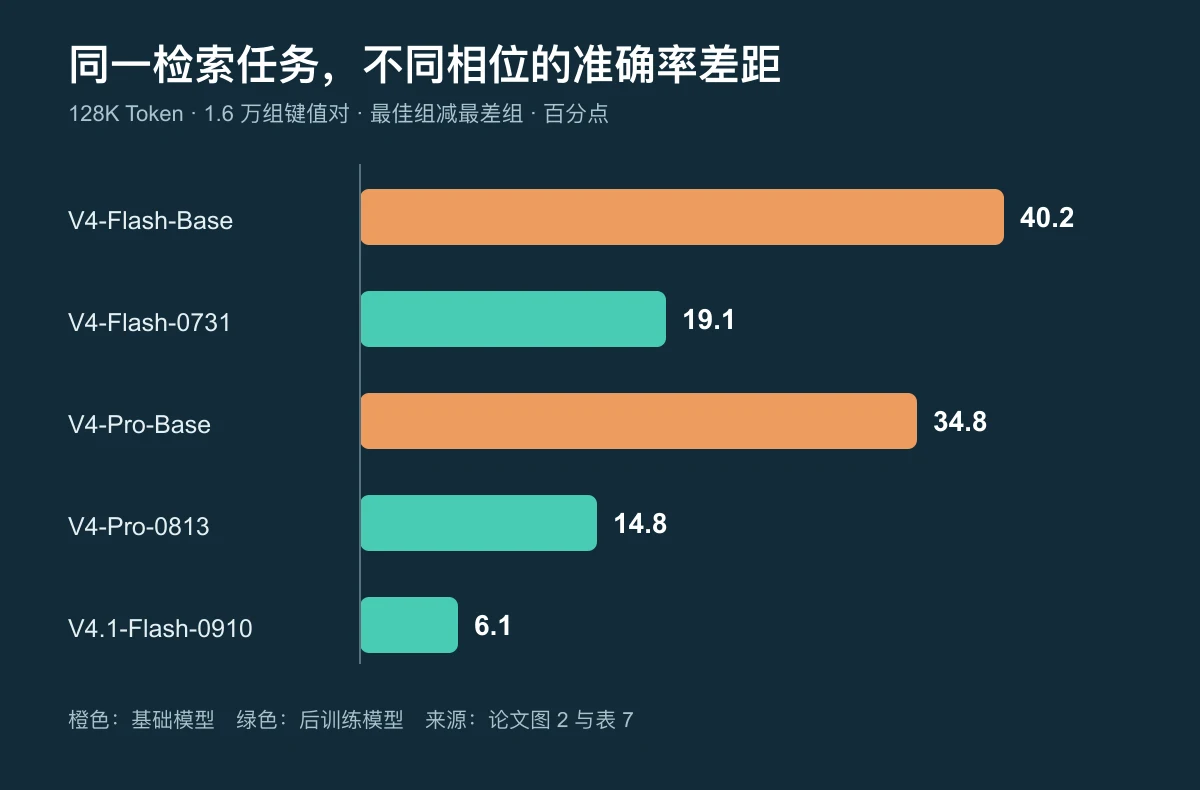
图:论文图 2、表 7 的最大相位差距。单位为百分点;任务是合成键值对检索,非通用长文能力排名。
“同一根针相差 40 个百分点”指 V4-Flash 基础模型的八组准确率之差。后训练提升了准确率,缩小了差距。V4.1-Flash 的平均准确率为 92.38%,最佳与最差组相差 6.09 个百分点。平均成绩与最差相位回答的是两个问题。
压缩结构的证据与因果边界
DeepSeek 两代模型之间存在训练和架构差异。研究者训练了一组 Qwen3-0.6B 骨架模型。实验保留近似架构与训练设置,改变 KV 压缩方案。全注意力基线的相位曲线平缓;受测压缩模型出现周期。窗口步长为四、六、八 Token 的实验,周期分别接近四、六、八 Token。
实验包含重叠窗口、无 RoPE 位置编码与均值压缩。三类设置出现周期。注意力头的干预实验显示,不同头承担不同相位的检索工作。部分头的压缩门控偏好固定窗口位置。
这些实验支持“分块压缩参与形成相位敏感性”。所有大模型共享同一机制,属于证据范围之外的命题。窗口边界效应与窗口内部差异缺少统一解释。论文的实验对象和结论边界需要保留。
长文本评测该补一列什么
单个平均分合并强相位和弱相位。论文建议相位扫描:目标事实保持原样;前缀长度改变少量 Token;评测记录每种相位的准确率。产品团队的报告可以包含平均值、最差值与相位差距。键值检索、代码补全、文档问答属于位置敏感任务。
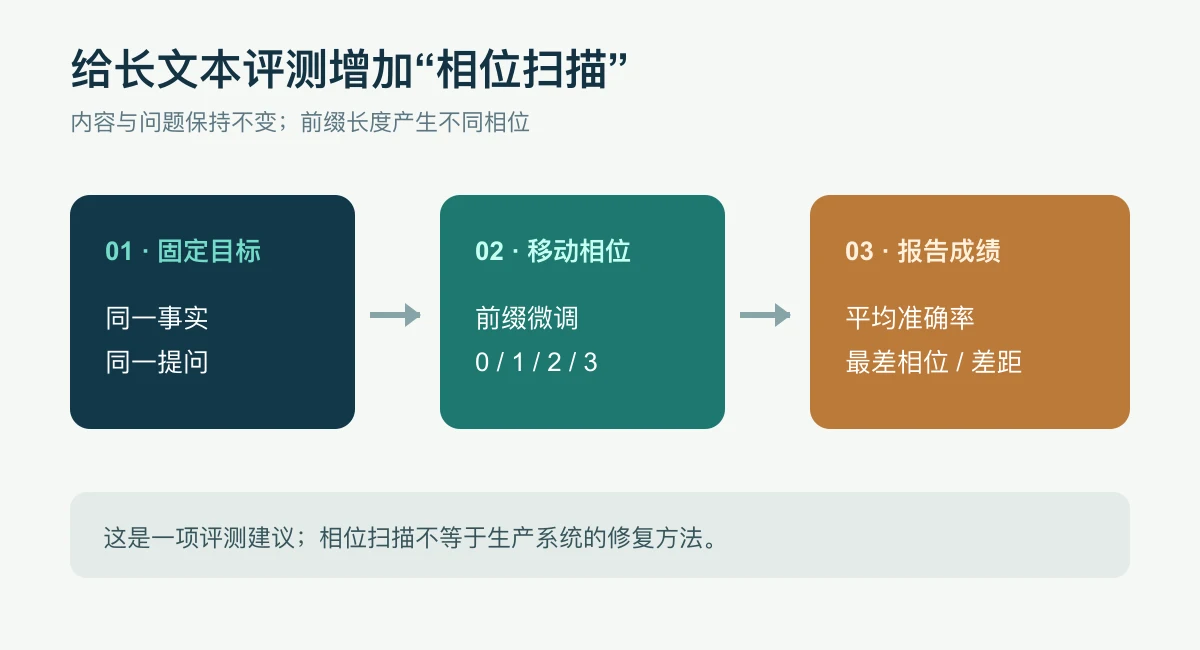
图:依据论文评测方法整理的检查流程。流程属于评测建议,非模型修复方案。
填充 Token 缺乏生产修复的可靠性证据。真实请求包含格式、工具消息和增长的上下文;所谓“好相位”与任务、输入之间的关系缺少统一规律。论文缺少通用修复算法。
这篇论文给长上下文系统增加了一个坐标:压缩相位。平均分衡量总体水平;弱相位衡量局部失效。模型选型和回归测试需要看到两张成绩单。
