Concitech AI · 深度长文
2026/08/24 11:46
Anthropic 最强模型卖不动了:企业为什么不愿为“最后 10%”多付一倍?
Fable 5 只占 Anthropic 企业模型支出的 11.4%,Token 占比更低。最强模型为何输给自家便宜模型?答案藏在企业真正关心的成本单位里。
Anthropic 最强的公开模型 Fable 5,正在遭遇一个以前很少出现的尴尬:能力站在最前面,企业使用量却没有跟上。
Financial Times 根据企业支付平台 Ramp 的数据报道,Fable 5 发布两个多月后,企业支出占比仍停留在 Anthropic 模型支出的约 11%。7 月底才发布的 Opus 5,价格只有它的一半,支出规模却已经超过 Fable 5。
这件事比“某款模型销量不佳”更值得讨论。
过去几年,头部模型公司的增长逻辑很直接:训练出更强的模型,刷新 Benchmark,用户升级,收入再投入下一轮训练。Fable 5 的遇冷说明,这条链路正在多出一个越来越难绕过的环节。
企业会问:这部分新增智能,到底值多少钱?
先把“卖不动”说清楚
Ramp 在 8 月发布的 AI Index 给出了两组关键数据:
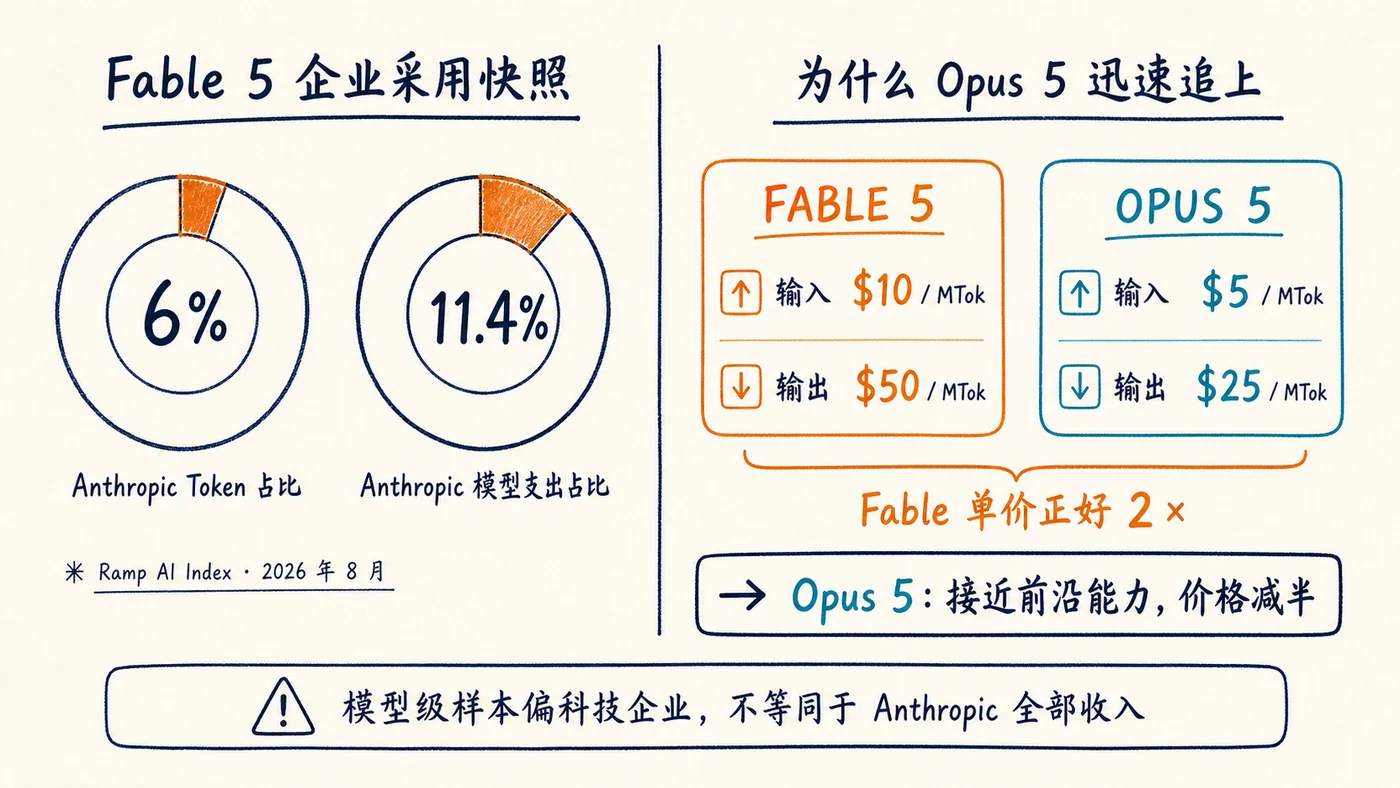
- Fable 5 只占企业从 Anthropic 购买 Token 的 6%;
- 因为单价更高,它占 Anthropic 模型支出的 11.4%。
也就是说,Fable 5 的收入占比几乎是 Token 占比的两倍,但绝对使用量仍然有限。
FT 引用的是 Ramp 覆盖约 7 万家企业的支付数据。Ramp 自己也提醒,具体到模型用量的样本来自它的 Token Spend Management 产品,企业构成比其常规指数更偏科技行业。这不是整个市场的完整账本,也不能直接等同于 Anthropic 的全部收入。
数据还可能漏掉通过云厂商打包采购、固定订阅和免费额度产生的使用量。Fable 5 上线时间也不长,不排除企业仍处在测试和采购审批阶段。
所以,现有数据不足以证明“前沿模型没有市场”。它能证明的是另一件事:即使在更愿意尝试新技术的企业样本里,最强模型也没有自然成为默认选择。
Fable 5 最大的对手,来自 Anthropic 自己
Fable 5 于 6 月 9 日发布。Anthropic 把它定义为“面向长时间运行 Agent 的下一代智能”,定价为每百万输入 Token 10 美元、输出 Token 50 美元。
它确实是 Anthropic 能公开提供的能力上限,但产品定位非常窄:长周期 Agent、深度推理、复杂研究,以及以前模型难以完成的高难度任务。
普通企业任务很少一直待在这个难度区间。
邮件分类、信息抽取、客服草稿、常规数据分析和大量编码任务,较便宜的模型已经能稳定完成。Fable 5 在这些任务上即使更好,差异也未必会改变最终结果。
然后 Opus 5 来了。
Anthropic 在 7 月 24 日发布 Opus 5,输入和输出价格分别是 5 美元和 25 美元,正好只有 Fable 5 的一半。Anthropic 自己对它的描述也很直接:接近 Fable 5 的前沿智能,但价格减半。
在 CursorBench 3.2 上,Opus 5 的最高成绩距离 Fable 5 不到 0.5%,每个任务的成本却只有一半;在 OSWorld 2.0 上,Opus 5 甚至以略高于 Fable 5 三分之一的成本超过了后者的最好结果。
企业当然会算这笔账。
如果两个模型都能把任务做完,采购者不会因为其中一个更接近“智能上限”就长期支付双倍价格。Fable 5 不是输给了低端模型,而是被自家一个“能力足够接近、限制更少、价格便宜一半”的新模型挤进了狭窄的高难度市场。
而且 Fable 5 还有额外摩擦。它在网络安全、生物和化学等领域使用更严格的分类器,部分请求会被拒绝或自动转交给 Opus。Opus 5 的相关限制明显少得多。对企业应用来说,可预测性本身也是产品能力。
企业买的不是 Token,而是“成功完成一个任务”
只看每百万 Token 的价格,也可能得出错误结论。
更强的模型有时会使用更少的轮次、更少的搜索和更少的重试。虽然每个 Token 更贵,完成一项工作的总成本反而更低。
Anthropic 在自己的成本优化文档中给了两个很有意思的例子。
在 DeepResearch Bench II 这类足够困难的研究任务上,Fable 5 使用 low effort 时,不仅准确率高于 Sonnet 5,每个任务的成本还低约 10%。高价模型一次做对,省掉了反复搜索和返工。
但在一组接近饱和的 SWE-bench Pro 子集上,Opus 5 与 Fable 5 的成绩分别是 91.7% 和 91.3%,差异落在运行波动内,Opus 5 的成本却只有后者约 60%。
结论不是“永远选便宜模型”,也不是“最强模型总能省钱”。模型排名会随任务变化。
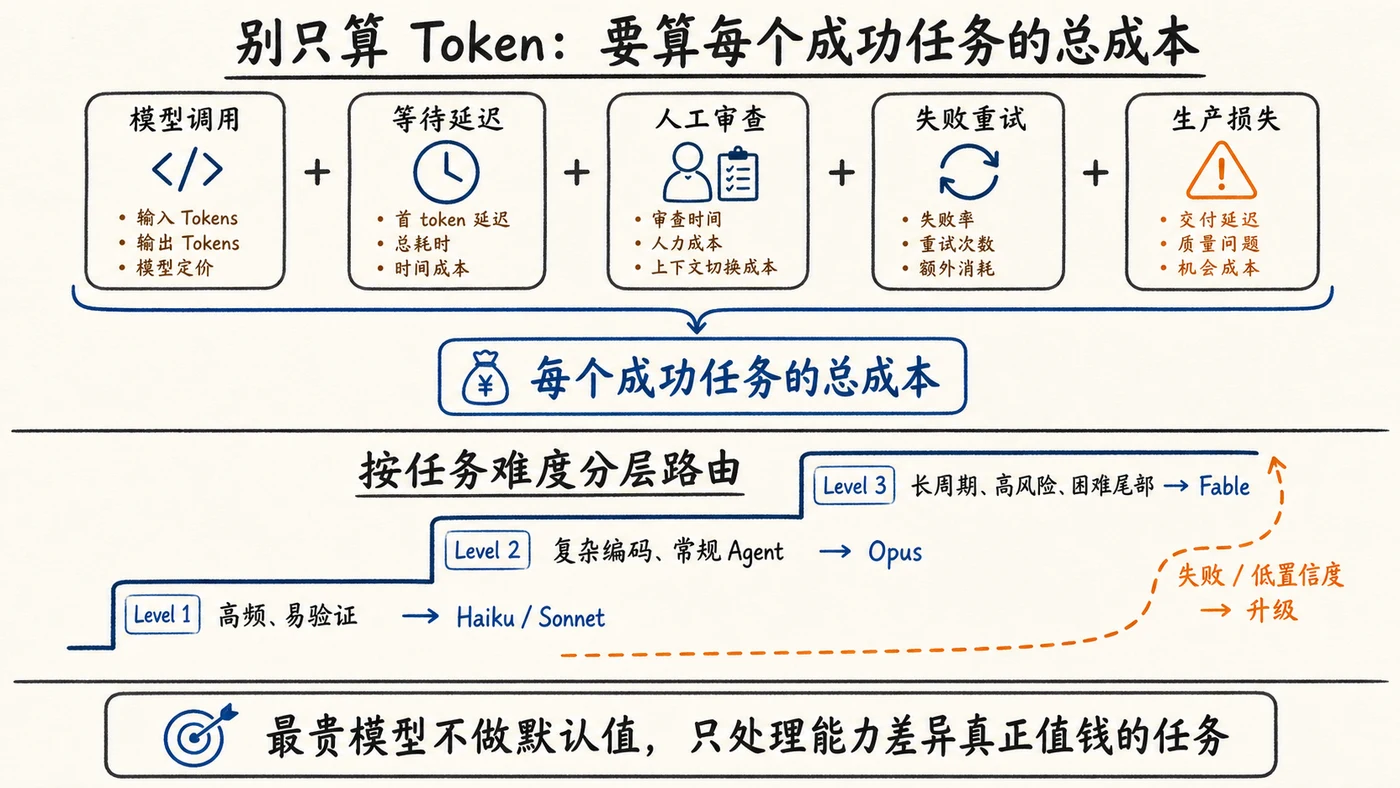
企业真正应该计算的是:
每个成功任务的成本
= 模型调用成本
+ 延迟成本
+ 人工审查成本
+ 失败与重试成本
+ 错误进入生产后的损失
假设 Fable 5 能把某类任务的成功率从 90% 提高到 95%。如果一次失败只需要人工修改 5 分钟,双倍价格很难成立;如果一次失败会造成错误交易、合规事故或数天返工,那 5 个百分点可能非常便宜。
同样是 5% 的能力差异,放在不同业务里,经济价值可能相差几个数量级。
“每一美元买多少智能”仍然不够准确
把 Benchmark 分数除以价格,得到一个“每美元智能”指标,比只看模型能力前进了一步,但还不够。
通用 Benchmark 测量的是平均能力。企业面对的却是一组具体任务,其中大部分可能很简单,少数任务非常困难,失败代价也完全不同。
最省钱的策略通常不是给所有任务固定一个模型,而是建立分层路由:
高频、容易验证的任务
→ Haiku 或 Sonnet

复杂编码、分析和常规 Agent 工作
→ Opus

长周期、强推理、失败代价高的尾部任务
→ Fable

低成本模型失败或置信度不足
→ 自动升级到更强模型
这也是 Anthropic 官方现在推荐的方向。它建议多数 Agent 工作先从 Opus 5 开始,只在需要最高能力时选择 Fable 5;还建议对失败任务提高 effort 或升级模型,而不是让所有请求默认使用最昂贵配置。
大模型正在从“选一个最好的”变成云计算里熟悉的资源调度问题。企业需要维护自己的评测集,记录每类任务的成功率、耗时、Token、人工介入和返工成本,再决定怎样路由。
没有这套数据,财务部门只能看总账单,工程团队只能看 Benchmark,双方都不知道钱到底花在了哪里。
最强模型可能会变成“光环产品”
Fable 5 使用量不高,不一定意味着它对 Anthropic 没有价值。
汽车公司需要旗舰跑车证明技术能力,但真正贡献销量的往往是中端车型。芯片公司也会用最高规格产品建立品牌和技术上限,再把架构能力下放到更大的市场。
前沿模型可能走向相同位置。
它可以服务少量高价值任务,吸引最困难的客户,帮助 Anthropic 发现新的能力边界。更重要的是,Fable 上验证过的能力会进入下一代 Opus 和 Sonnet。Opus 5 在 Fable 发布一个半月后就以一半价格逼近它,本身就是这种能力下放的例子。
但这会改变模型公司的商业叙事。
训练最强模型需要巨额资本,最强模型却未必拥有最大的推理收入。真正跑量的产品可能永远是“足够强、快得多、便宜得多”的中间层。前沿模型负责研发和品牌,中端模型负责现金流。
模型公司还会面临持续的自我蚕食:一款昂贵旗舰刚刚建立价格锚点,几周后的新模型就用更低成本接近它。升级速度越快,企业越不愿意把长期生产系统绑定在最高价型号上。
最终更稳定的收入,可能来自模型路由、缓存、评测、Agent 运行平台和企业治理,而不是单纯依赖最强模型的 Token 溢价。
企业现在应该怎样选模型
如果正在建设企业 Agent,不要把 Fable 5 或任何旗舰模型直接设成全局默认值。更稳妥的做法是:
- 先建立真实任务集。 从线上流量抽取简单、中等和高难任务,保留人工确认过的正确结果。
- 测每个成功任务的成本。 Token 费用只是其中一项,还要记录延迟、重试、人工审查和失败损失。
- 让便宜模型处理主体流量。 输出容易验证、错误可以恢复的任务,没有必要购买最高能力。
- 把前沿模型留给困难尾部。 当低成本模型失败、任务超过复杂度阈值,或错误代价很高时再升级。
- 定期重新评测。 Opus 5 对 Fable 5 的快速追赶说明,三个月前的最优路由很可能已经过时。
这套方法看起来不如“全员换上最强模型”激动人心,却更接近企业软件真正的采购方式。
Fable 5 遇冷,可能是模型市场成熟的开始
早期的大模型市场接近技术爱好者市场:能力提升足够显眼,大家愿意追逐每一次榜单刷新。
企业市场不同。模型一旦进入客服、研发、财务和运营流程,就要与预算、延迟、审计和失败责任放在同一张表里计算。
Fable 5 的问题不是不够强,恰恰是它太强、太贵,而多数任务暂时用不到它最昂贵的那部分能力。
这也不意味着前沿智能不再重要。真正困难的新任务,仍然要靠能力上限打开。只是模型公司不能再假设,技术上领先 10%,商业收入就会自动领先 10%。
企业不会为“最聪明”长期买单,它们会为“更高概率完成任务,并且总成本更低”买单。
当最强模型不再自动成为最畅销模型,大模型行业才真正开始像一个成熟市场。
参考资料
- Ramp AI Index:Cracks in the AI Thesis
- Financial Times 报道转载:Anthropic’s best AI model struggles to attract users
- Anthropic:Claude 模型与价格总览
- Anthropic:Introducing Claude Fable 5 and Claude Mythos 5
- Anthropic:Introducing Claude Opus 5
- Anthropic:Optimizing for cost and intelligence
- Ramp AI Index 方法与 API 文档
