Concitech AI · 深度长文
2026/08/27 06:39
GLM-5.3-Flash 开源:0.4 元背后的国产推理栈
GLM-5.3-Flash 以 320B 总参数、18B 激活和限时 0.4 元每百万输入 Token 的价格发布。真正值得关注的,是混合注意力、定制 SGLang 与国产 AI 芯片组成的整条推理栈。
8 月 26 日,Z.ai 发布并开放了 GLM-5.3-Flash 权重。两条消息很快在中文社区刷屏:320B 总参数、18B 激活、100 万上下文,中国区限时输入 0.4 元、输出 1.4 元每百万 Token。
如果只看标题,它像又一场熟悉的模型发布会:参数更大,榜单更高,价格更低。
但这次真正值得看的,并不是“它是否击败 Opus”。而是 Z.ai 把模型架构、推理引擎和国产芯片放到了一张成本表里。过去大家常说“国产模型可以跑在国产芯片上”,现在这句话第一次带上了真实流量、万卡规模和明确的 API 价格。
这三件事同时出现,分量比一个榜单名次更重。
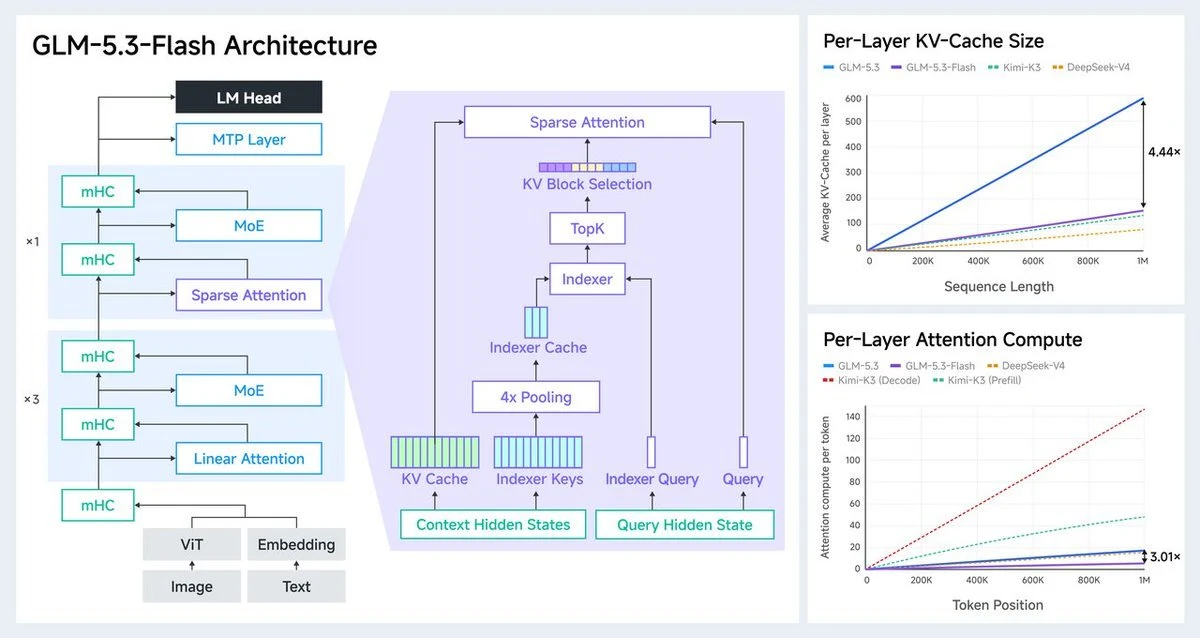
图:Z.ai 公布的模型架构。左侧为线性与稀疏注意力的混合结构,右侧比较了长上下文下的 KV Cache 和注意力计算。
先把最吸睛的数字摆上桌
GLM-5.3-Flash 是 GLM-5 系列首个原生多模态模型。它有 3200 亿总参数,但每个 Token 推理时只激活 180 亿参数;权重已在 Hugging Face 发布,采用 MIT 许可,并支持 SGLang、vLLM 等推理框架。
API 价格则分成两套口径:
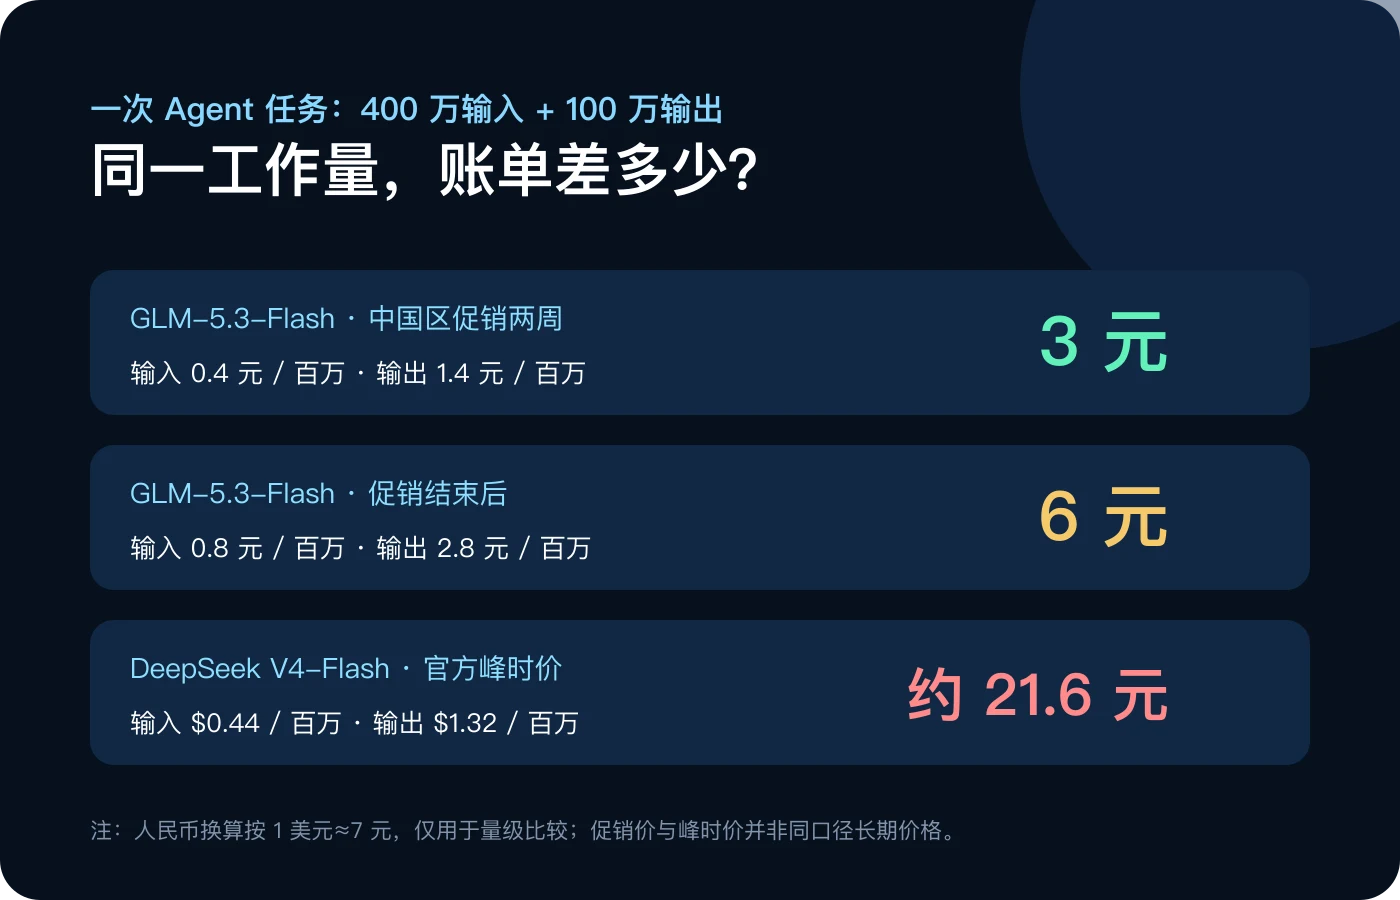
- 中国区发布促销持续两周,输入 0.4 元、输出 1.4 元/百万 Token;
- 促销结束后恢复为输入 0.8 元、输出 2.8 元/百万 Token;
- 国际站标准价为输入 0.15 美元、输出 0.50 美元/百万 Token,缓存输入 0.03 美元。
按一项长上下文 Agent 任务使用 400 万输入、100 万输出计算,促销期账单约 3 元,恢复价后约 6 元。
DeepSeek 官方当前给 V4-Flash 的峰时价是输入 0.44 美元、输出 1.32 美元。按 1 美元约合 7 元粗算,同一工作量约 21.6 元。这个比较并不完全公平——一边是限时促销,一边是峰时价——但足以说明 Z.ai 这次定价有多激进。
低价当然不等于低总成本。Agent 的上下文组织、缓存命中率、输出长度和失败重试都会影响最终账单。尤其是 GLM-5.3-Flash 在 Artificial Analysis 的测试中输出偏长,Token 单价便宜,并不保证每个任务都按同样比例省钱。
低价不是魔法,而是把模型“瘦”在推理阶段
320B 听上去很重,18B 激活才是关键。
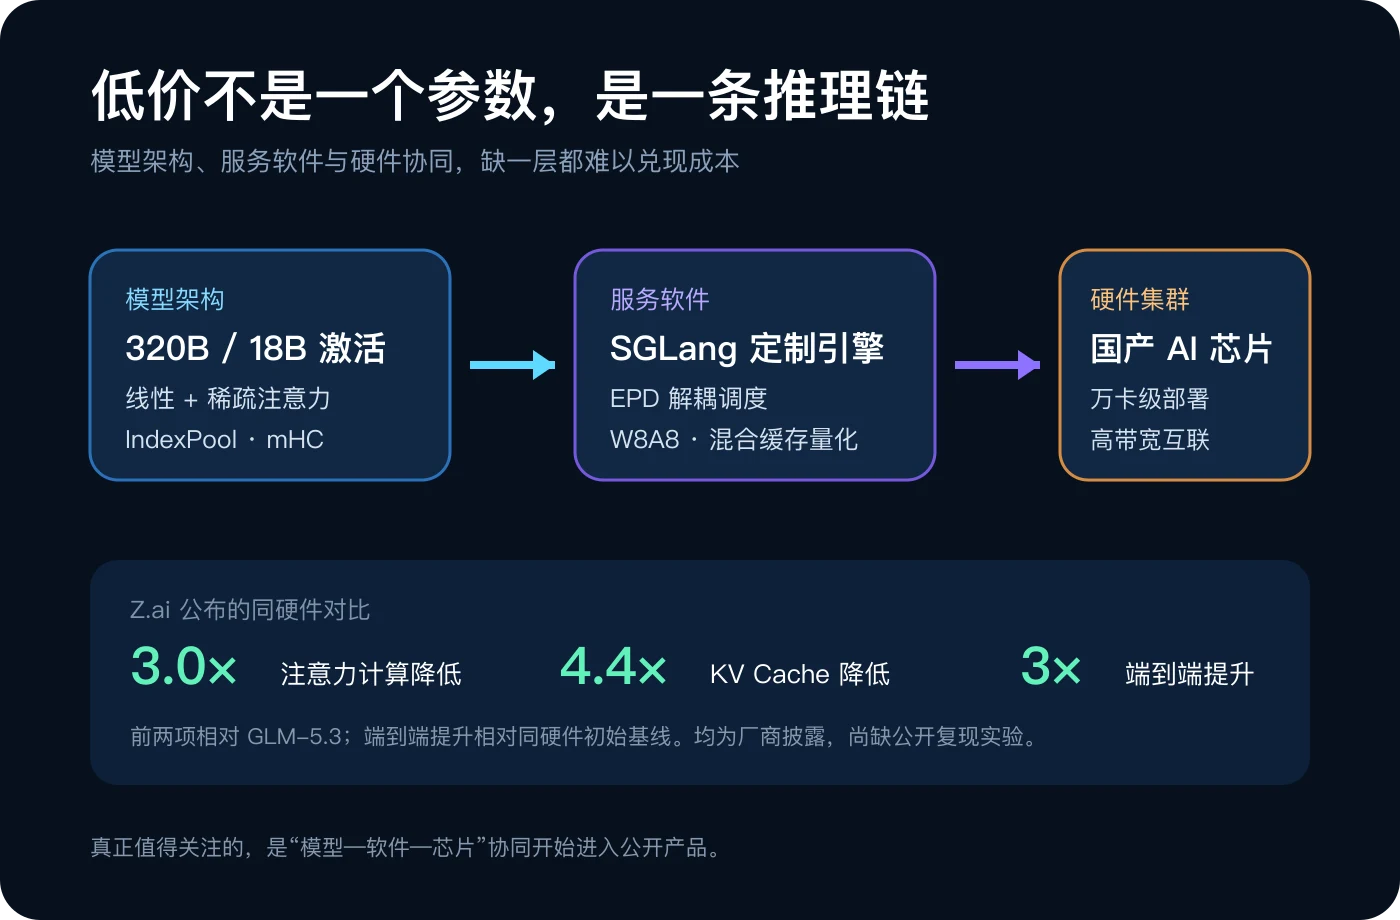
GLM-5.3-Flash 采用混合专家架构。大量专家参数提供容量,但每一步只调用少数专家。与 GLM-4.5 系列相比,它在总参数相近的情况下,把激活参数从 32B 降到 18B,层数从 92 层压到 45 层。
长上下文又是另一笔昂贵的账。Z.ai 首次在 GLM 系列中混合使用线性注意力和稀疏注意力:前者处理局部依赖,后者通过轻量索引器寻找全局相关信息。IndexPool 再把四组索引键向量压成一组,减少 100 万上下文下的延迟和内存占用。
按照 Z.ai 的测算,相比 GLM-5.3,GLM-5.3-Flash 的注意力计算量降低约 3 倍,KV Cache 体积降低约 4.4 倍。不过,官方也承认它的 KV Cache 仍略大于 DeepSeek V4-Flash 和 Kimi K3。
这句自我揭短很重要:GLM-5.3-Flash 不是在每个效率指标上都领先,它只是找到了一个更适合大规模推理的折中点。
它真的追平 Claude Opus 4.8 了吗?
答案是:部分任务接近,不能概括为全面追平。
在 Z.ai 公布的六项编程和 Agent 评测中,GLM-5.3-Flash 的 Terminal-Bench 2.1 为 84.3,接近 Opus 4.8 的 85.0;DeepSWE 是 63.4,对方是 58.0。但到了 NL2Repo,它为 56.3,明显落后于 Opus 4.8 的 69.7。
Z.ai 自建的 Code Bench 上,两者在最高推理档位为 29.0 和 29.5。这个结果可以说明“接近”,但自建榜单不该成为唯一证据。
第三方 Artificial Analysis 给 GLM-5.3-Flash 的 Intelligence Index 是 57,属于当前开放权重模型的第一梯队。与此同时,它测得模型输出速度约 48.7 Token/秒,低于同类模型 67 Token/秒的中位数;完成整套评测时,模型输出约 1.5 亿 Token,也比同类中位数更啰嗦。
所以,更准确的说法是:它用远低于闭源旗舰的价格,进入了相近的能力区间,但速度、输出效率和具体任务表现仍有明显差异。
国产芯片这一次,不只是兼容列表里的一行字
发布前,GLM-5.3-Flash 曾以“ox-alpha”的匿名名称在 OpenCode 和 OpenRouter 接收真实流量。Z.ai 表示,过去一周的这些流量全部由国产 AI 芯片集群承载。
官方没有公布芯片型号,但披露了推理栈的主要做法:在 SGLang 上定制推理引擎,使用 W8A8 量化、INT8/FP8/BF16 混合缓存量化、Layer Split,并用 EPD 架构把多模态编码、提示词预填充和逐 Token 解码拆成独立资源池。
Z.ai 称,这套系统已扩展到数万张国产加速卡;相对同一硬件上的初始基线,端到端性能提升了 3 倍,每 Token 成本接近主流英伟达 GPU。
这里必须加一句边界:芯片型号、集群规模明细、并发负载和原始测量数据都没有公开,外部暂时无法复现“接近英伟达”的结论。它仍是厂商披露,不是独立审计。
可即便如此,匿名模型承载过真实公网流量,仍比演示视频或兼容性声明更有意义。国产芯片正在从“能把模型点亮”,走向“能以产品价格稳定提供服务”。
对开发者来说,最实际的三个判断
第一,GLM-5.3-Flash 很适合进入候选模型池,但别只跑问答样例。用自己的 Agent 轨迹测任务成功率、工具调用稳定性、首 Token 延迟、总输出 Token 和失败重试次数,才能看到真实成本。
第二,“18B 激活”不代表一张消费级显卡就能装下。自部署仍要容纳 320B 权重,并处理 100 万上下文带来的缓存压力。开放权重降低了许可门槛,没有消除硬件门槛。
第三,价格战已经从模型 API 进入全栈工程。接下来真正拉开差距的,可能不是谁再涨 5 分,而是谁能把注意力、缓存、调度、量化和芯片协同做成稳定服务。
最后
GLM-5.3-Flash 没有用一张榜单终结模型竞争,也没有证明国产芯片已经全面替代英伟达。
它完成的是另一件更现实的事:把一个 320B 的原生多模态模型,用 18B 激活、混合注意力、定制推理引擎和国产芯片集群,压进了每百万 Token 几毛到几元的价格区间。
当能力差距缩小到“不同任务各有胜负”,成本曲线就会开始决定谁能真正进入生产环境。
这一轮,最值得关注的不是新模型有多聪明,而是聪明开始变得多便宜。
资料来源
