Concitech AI · 深度长文
2026/09/18 07:56
智谱让 GLM 修自己的推理系统:两周周期,吞吐接近原值三倍
GLM-5.3 驱动的 Infra Agent 参与国产加速卡推理栈建设。智谱披露:周期少于两周,端到端吞吐接近初始基线三倍。核心资产落在一套稠密反馈环境。
一个大模型参与了自身推理系统的建设。
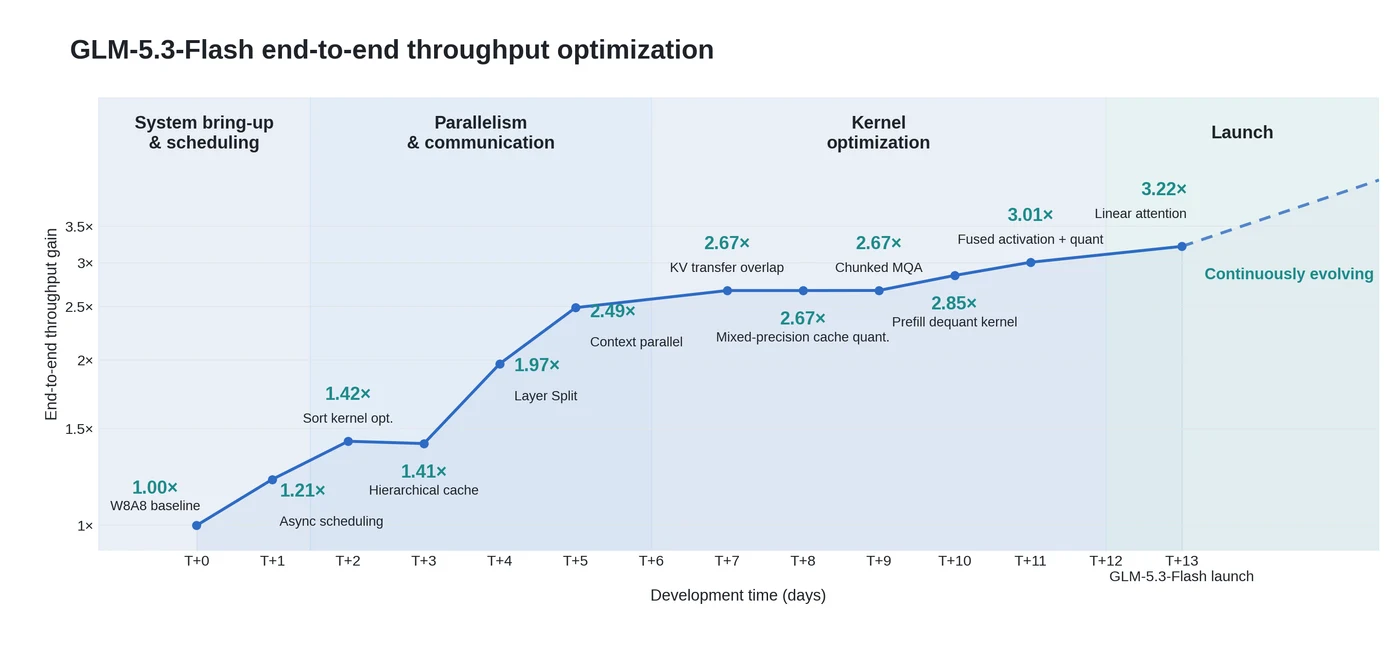
服务对象是 GLM-5.3-Flash。硬件底座包含十万张以上国产 AI 加速卡。适配周期少于两周。端到端吞吐接近初始基线三倍。
执行者名单包含一名特殊成员:GLM-5.3 驱动的 Infra Agent。
智谱称这项工作为递归自我改进的早期形态。这个说法带来科幻感。官方复盘里的核心贡献属于工程方法:人类建立反馈环境,Agent 提出假设、修改代码、运行实验,测试结果决定下一轮动作。
代码生成能力是一张门票。反馈质量决定 Agent 的工程产出。
爆款数字分属两个证据等级
中文推文提出“全时 GPU 利用率超过 85%”的说法,消息来源被作者称为“道听途说”。智谱官方文章缺少 85% 指标与商业分润数据。
85% 属于二手消息,公开证据缺席。本文排除这个数字。
引用推文来自智谱创始人、清华大学教授唐杰。推文对应一篇智谱官方技术复盘。官方材料给出四项可归因数据:
- 国产 AI 加速卡集群规模超过十万张;
- GLM-5.3-Flash 的全量生产推理流量落在这套系统;
- 模型适配与生产准备周期少于两周;
- 端到端吞吐接近初始基线三倍。
唐杰的推文使用 3.2 倍表述,官方正文使用“roughly 3×”。文章采用官方正文口径。
这些数据属于智谱自述。公开材料缺少独立审计结果。一个开源痕迹提供了旁证:Flash Linear Attention 项目的 PR #1180 记录了长上下文精度修复,合并日期是 2026 年 8 月 27 日。
两周工程面对什么
GLM-5.3-Flash 采用混合架构。稀疏注意力与线性注意力共存。模型拥有 1M Token 上下文与多模态请求能力。
国产加速卡带来显存容量、互连带宽、算子覆盖和软件文档问题。成熟英伟达生态提供的默认答案失效。推理团队重建内核、并行策略、缓存结构、通信路径与服务编排。
智谱列出的方案包含 ReplaySSM、W8A8 量化、INT8/FP8/BF16 混合精度缓存、Layer Split,以及 Encode-Prefill-Decode 解耦架构。
这类工作属于系统工程深水区。一次局部优化抢占另一条路径的资源。一个速度提升引入数值误差。一个异步接口卡住 Python GIL。代码库提供静态信息,生产系统暴露动态行为。
代码理解与性能回退诊断属于两项能力。
代码能力之外的瓶颈
“吞吐下降 20%”是一条结果。它缺少责任层级。
责任层候选包含算子、通信、内存、线程调度与服务编排。端到端压测给出输赢,根因保持隐藏状态。
资深工程师脑中拥有一套隐性过程奖励。检查对象包含 Timeline、Microbenchmark 与分层输出。Agent 缺少这套经验。
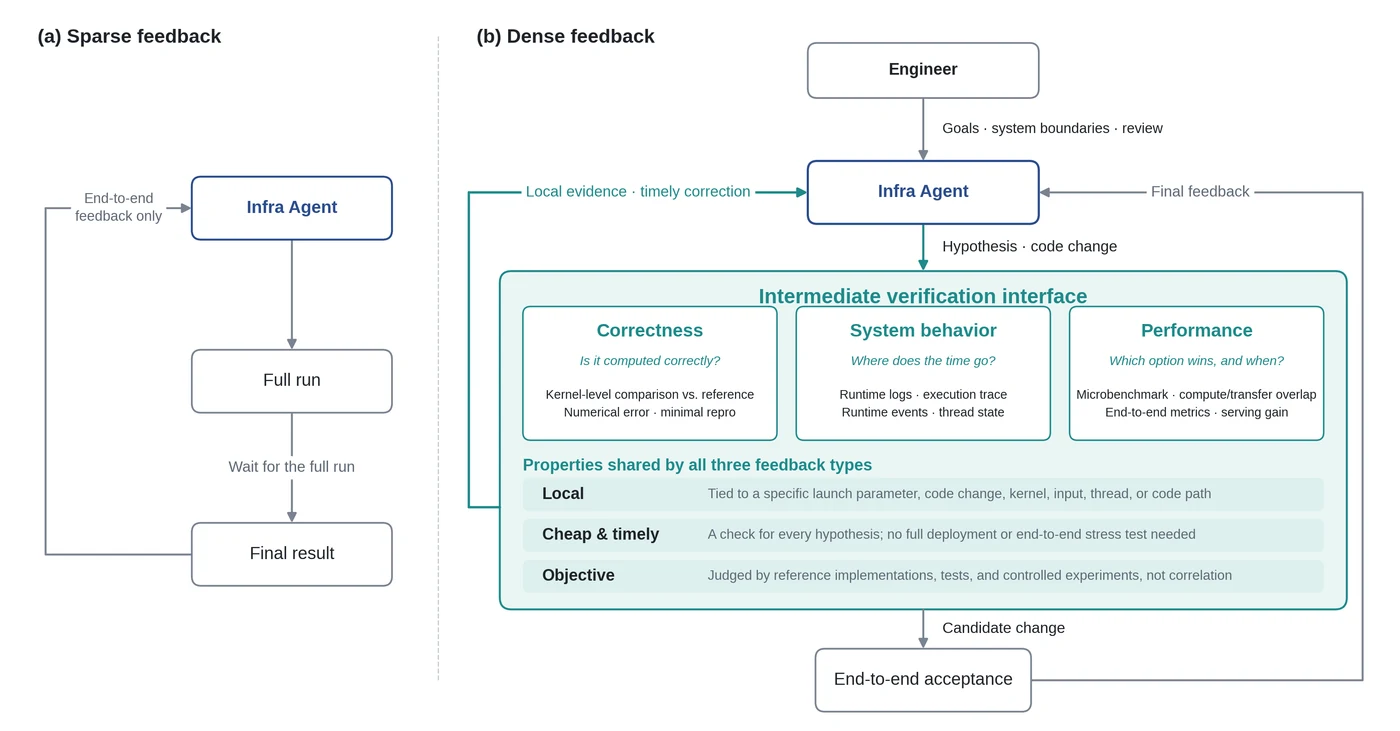
经验成为接口,名称是 Dense Feedback,中文名是“稠密反馈”。
稠密反馈包含三类信号:
- 正确性反馈检验计算结果;
- 系统行为反馈定位时间消耗环节;
- 性能反馈匹配方案与输入条件。
可归因性定义“稠密”。日志数量与概念无关。理想信号具有局部范围、低实验成本和客观验证标准。
三个案例说明反馈价值
第一个案例涉及长上下文精度。
KDA 的 Context Parallelism 路径合并多个上下文分片状态。原实现采用 TF32 计算。链式状态合并积累舍入误差,长序列放大偏差。
局部精度测试暴露差异。问题范围收缩至状态传播路径。修复方案采用 tf32x3。Flash Linear Attention 的 PR #1180 收录这项改动与三组测试。
第二个案例涉及 KV Transfer 并发。
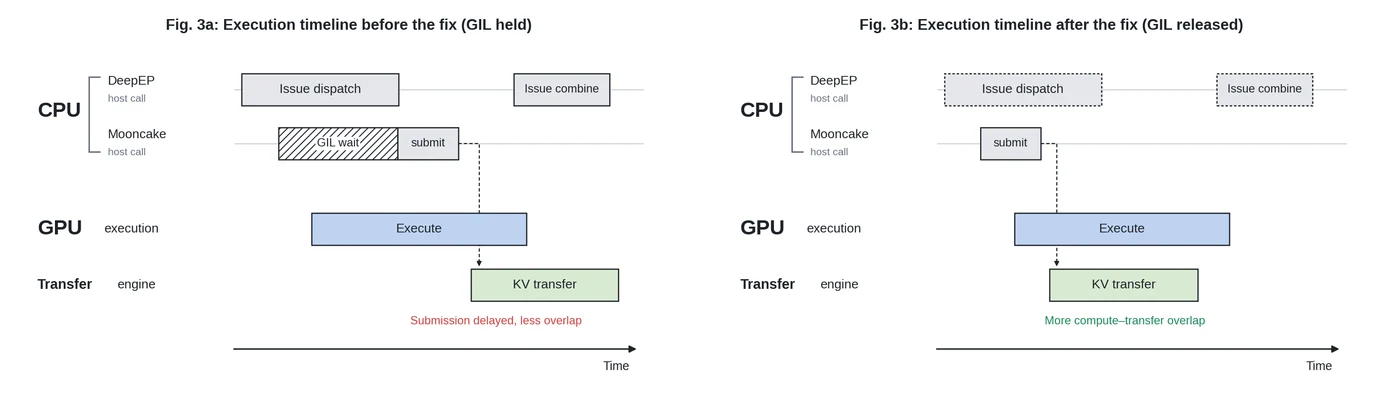
团队设定一条验收线:Prefill 加 KV Transfer 的性能差距小于 5%。测试结果超过 20%。Timeline 暴露另一个现象:KV Transfer 与 DeepEP dispatch 缺少重叠。
Python/C++ 调用链成为 Agent 的追踪对象。问题定位结果是 DeepEP 节点内路径的 GIL 释放区间。修复内容是锁区间调整。测试条件保持一致。性能差距降至 1% 以下。
第三个案例涉及 KDA Decode Kernel。
原分块方式让归一化与门控计算重复四次。Agent 合并 Tile,保存中间结果,取消重复计算。内核速度达到修改前方案的 1.71 倍。
重点落在一条共享链路:异常信号、局部实验、根因假设、代码修改、回归验证。
工程师变成反馈设计者
智谱给出清晰分工。
工程师定义目标、系统边界和风险规则。Agent 负责分析、假设、代码与实验。环境提供分层反馈。高风险改动接受人工审查。
这个分工改变工程师的核心产出。旧产出是某段优化代码。新产出是一套机器调用型验证环境:参考实现、数值测试、运行追踪、局部基准和验收标准。
好反馈具备复利属性。一次任务产生测试、轨迹和失败样本。后续模型得到训练材料。新 Agent 获得一套工程方法。
软件团队的竞争点发生迁移。代码库规模的重要性下降,反馈基础设施的重要性上升。拥有高质量测试、可观测接口与实验沙箱的团队,Agent 产出质量占优。
这套逻辑的适用对象包含推理系统、数据库、编译器、浏览器和大型后端。复杂系统存在同一难题:结果指标稀疏,责任层级模糊,实验周期昂贵。
递归自我改进距离遥远
智谱选择了一个醒目的概念:Recursive Self-Improvement。
现有案例缺少自治闭环。目标来自人类,反馈环境来自人类,风险边界来自人类,生产验收来自人类。模型承担工程循环中的分析与执行部分。
这个边界削弱科幻叙事。现实价值获得强化。
自主写出整套 AI 系统属于远期命题。代理工程师参与推理栈优化成为生产事件。模型、系统和训练数据之间出现一条短闭环:
模型修改服务系统。服务系统承载模型。工程轨迹进入后续训练材料。
核心资产是稠密反馈环境。某个 Kernel Patch 和一次三倍吞吐属于阶段结果。
Agent 时代的工程管理问题得到一个新答案:团队的任务是设计机器理解型、调用型与验证型反馈。
代码成本趋向下降。高质量反馈成本保持高位。
