Concitech AI · 深度长文
2026/09/04 09:19
GPT-6 Astra 发布:跑分逼近满分,OpenAI 却承认它更难监控
GPT-6 Astra 把计算机操作、浏览器任务和软件工程能力向前推了一截,ARC-AGI-3 甚至跑到 99.9%。但真正值得开发者注意的,是异步工具调用、执行中干预,以及一个反直觉的安全事实:它更守边界,思维链却更难监控。
OpenAI 发布了 GPT-6 Astra。
官方的第一句介绍很直接:“你能在电脑上做的事,Astra 都能替你做。”随后的成绩表也很抢眼:ARC-AGI-3 得分 99.9%,FrontierMath Tier 4 v2 为 97.6%,Terminal-Bench Science 0.1 从上一代的 22.4% 跳到 64.6%。
如果只看这些数字,很容易把它写成又一次“最强模型发布”。但把官方文档、系统卡和第三方评测放在一起,Astra 更值得关注的地方其实有两个。
第一,它开始像一个能被人在执行途中调度的 Agent,而不是接到指令后闷头跑到底的黑箱。第二,OpenAI 一边称它是迄今“最对齐”的模型,一边承认它的思维链更难监控。
这两个变化,比 99.9% 更接近企业真正要面对的问题。
先看跑分:提升很大,但不是处处第一
OpenAI 公布的七项核心成绩里,Astra 全部超过 GPT-5.6 Sol。其中最夸张的是 ARC-AGI-3:Sol 只有 7.8%,Astra 达到 99.9%。
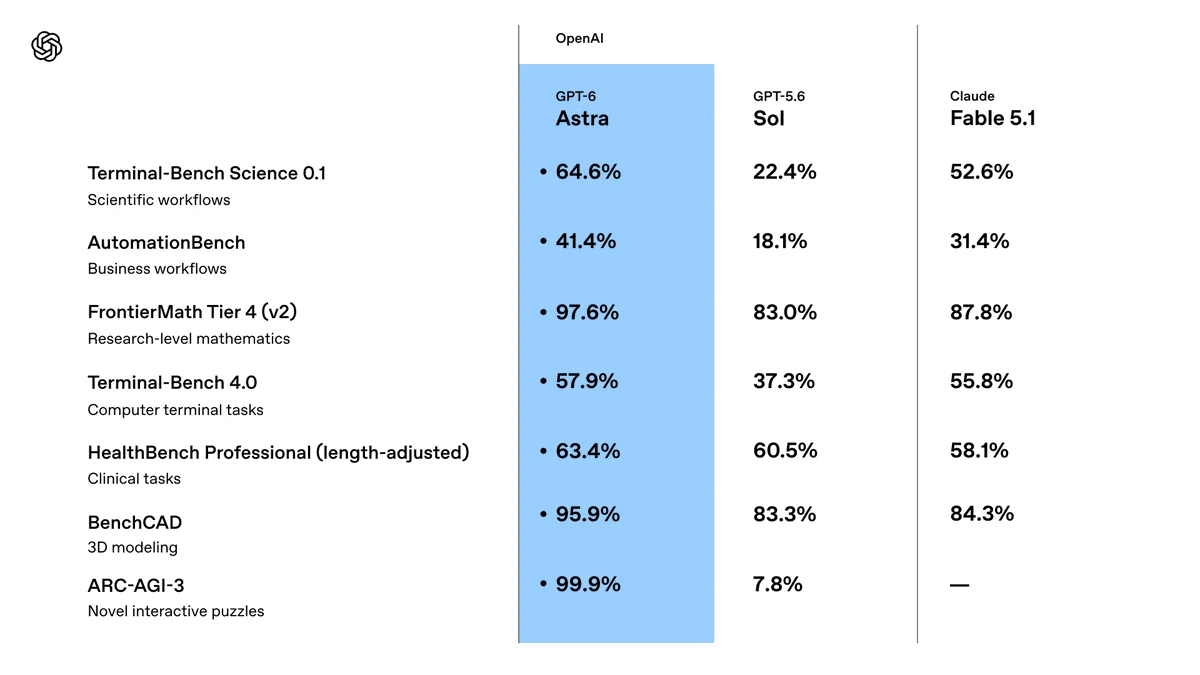
ARC-AGI-3 不是普通问答测试。模型要进入没有说明书的交互环境,一边试错,一边理解规则、设定目标并完成任务。它更像一组陌生游戏,考的是探索和规划能力。
不过,99.9% 需要加一个重要注脚。
ARC Prize 公布的结果显示,Astra 在 OpenAI 的 Provider Adapter 运行方式下得分 99.9%;换成标准 Harness,最高分是 62.7%。两种设置的区别在于,前者能在多次请求之间保留模型内部的推理状态,并配合上下文压缩;后者主要依靠模型自己记笔记。
这不是说 99.9% 不算数。它说明的是“模型 + 运行框架”共同达到了这个成绩,而不是一个裸模型在任意接入方式下都能稳定接近满分。对 Agent 产品来说,这个区别尤其重要:Harness 已经是能力的一部分。
OpenAI 自己的完整表格也能看到边界。Astra 在 Agents’ Last Exam、AutomationBench 和科学终端任务上领先,但在 Artificial Analysis Intelligence Index 中并没有压过所有对手。Artificial Analysis 的独立页面还显示,Astra High 的指数得分为 60,排名第 14,平均每个评测任务成本约 0.96 美元。
所以更准确的说法是:Astra 在计算机操作、长链工具任务和部分科学推理上出现了明显跃升,但它不是每张榜单都第一。
真正的新东西,是 Agent 的“控制面”
Agent 过去有个很现实的问题:一旦开始执行,人很难在不中断任务的情况下插手。
你让它整理客户数据,它先查文档,再跑脚本,接着写报告。中途发现方向不对,往往只能停止,再把新要求写进下一轮提示词。工具响应慢时,模型还会原地等着。
Astra 加入了三项专门面向这个问题的能力。
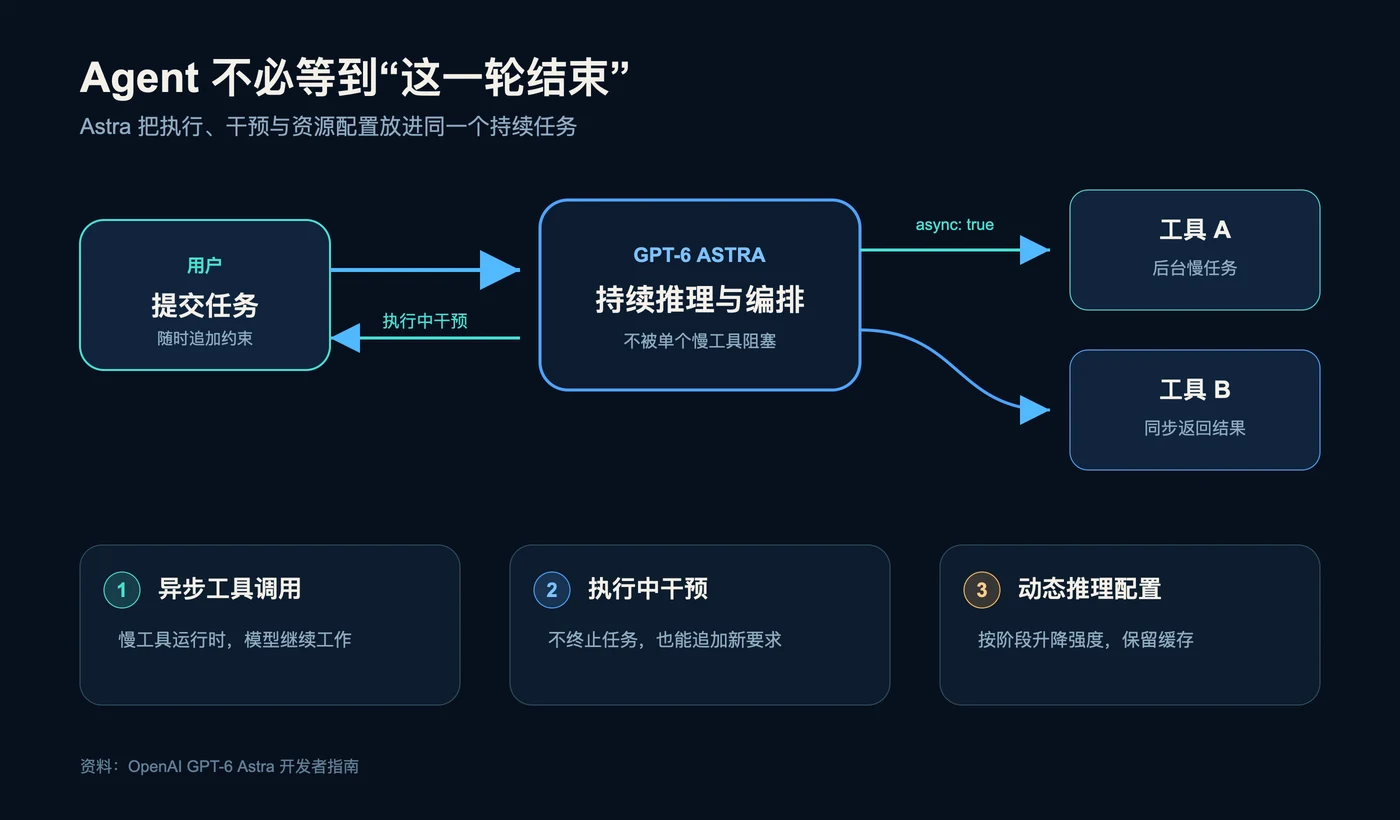
第一是异步工具调用。应用可以让某个工具在后台运行,模型不必等它结束,可以继续思考、调用其他工具,甚至先回复一部分结果。
第二是 mid-turn steering,也就是执行中的干预。通过 WebSocket,人可以在模型尚未完成这一轮时追加指令。比如“先别发邮件”“把分析范围缩到华东区”“这台服务器不要动”,不必等任务跑完再纠正。
第三是 configuration_update。应用可以在对话不断开的情况下切换推理强度,同时保留已经缓存的前缀。简单步骤用较低强度,遇到复杂决策再提高,理论上能减少无谓计算。
这些功能听起来没有 99.9% 那么刺激,却更可能改变 Agent 产品的交互方式。未来的 Agent 不只是“提交任务,等待结果”,而是像一个正在工作的同事:你能看到进度,随时插话,也能根据任务阶段调整资源。
每个 Token 贵了 2.5 倍
Astra 的标准 API 价格是每百万输入 Token 10 美元、输出 Token 50 美元。GPT-5.6 Sol 分别是 4 美元和 20 美元。按单价算,输入和输出都贵了 2.5 倍。
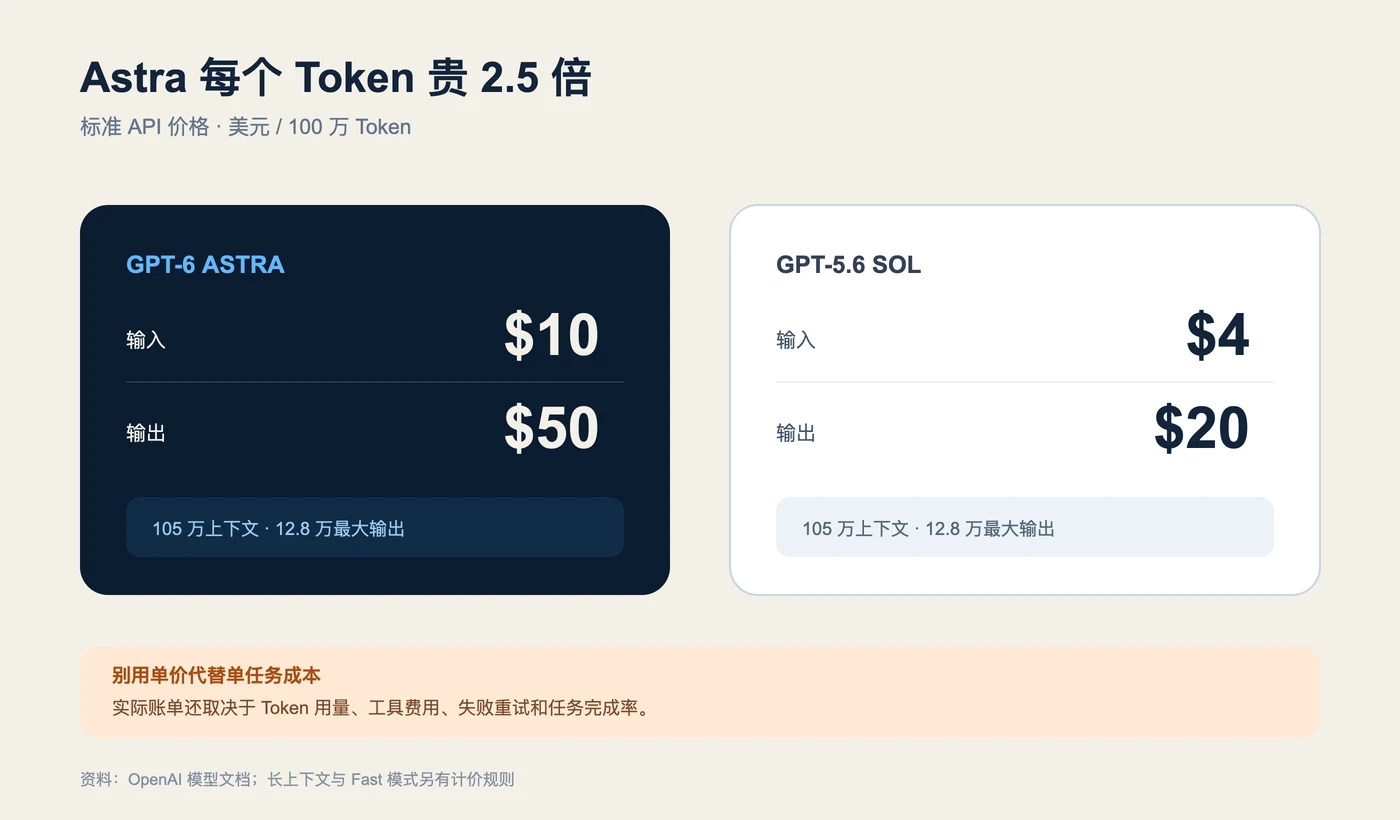
两者都是 105 万 Token 上下文、最高 12.8 万 Token 输出。输入超过 27.2 万 Token 后,Astra 整个请求的输入与缓存价格按 2 倍计算,输出按 1.5 倍计算。Fast 模式速度更高,价格再翻倍。
OpenAI 的说法是,在选定的计算机操作任务上,Astra 虽然单价高,却可能因为更少的 Token 和更快的完成速度降低单任务成本。例如 OSWorld 2.0 中,它平均约 40 分钟完成一项任务,Sol 约 75 分钟;Mind2Web 的任务完成速度提升到 1.9 倍。
这类数据值得测试,不能直接套进预算。Artificial Analysis 的对比给出了另一面:在它的综合评测中,Astra Max 的单任务成本高于 Sol Max,而且智能指数没有形成同样幅度的领先。
对企业来说,真正有用的指标仍然是:100 个真实任务完成多少、总共花多少钱、需要人工接管几次。Token 单价只是其中一行。
“更守边界”和“更容易监控”是两回事
OpenAI 称 Astra 是迄今最对齐的模型。它确实给出了几组很强的内部结果。
在计算机使用安全测试中,Astra 的违规率是 2.4%,Sol 为 22.0%;加入自动审查后,两者分别是 1.8% 和 4.5%。在一个观察模型会不会绕过蜜罐的实验里,Astra 是 0%,Sol 是 48.2%。这些指标都是越低越好。
但系统卡紧接着承认:Astra 的思维链可监控性下降了。
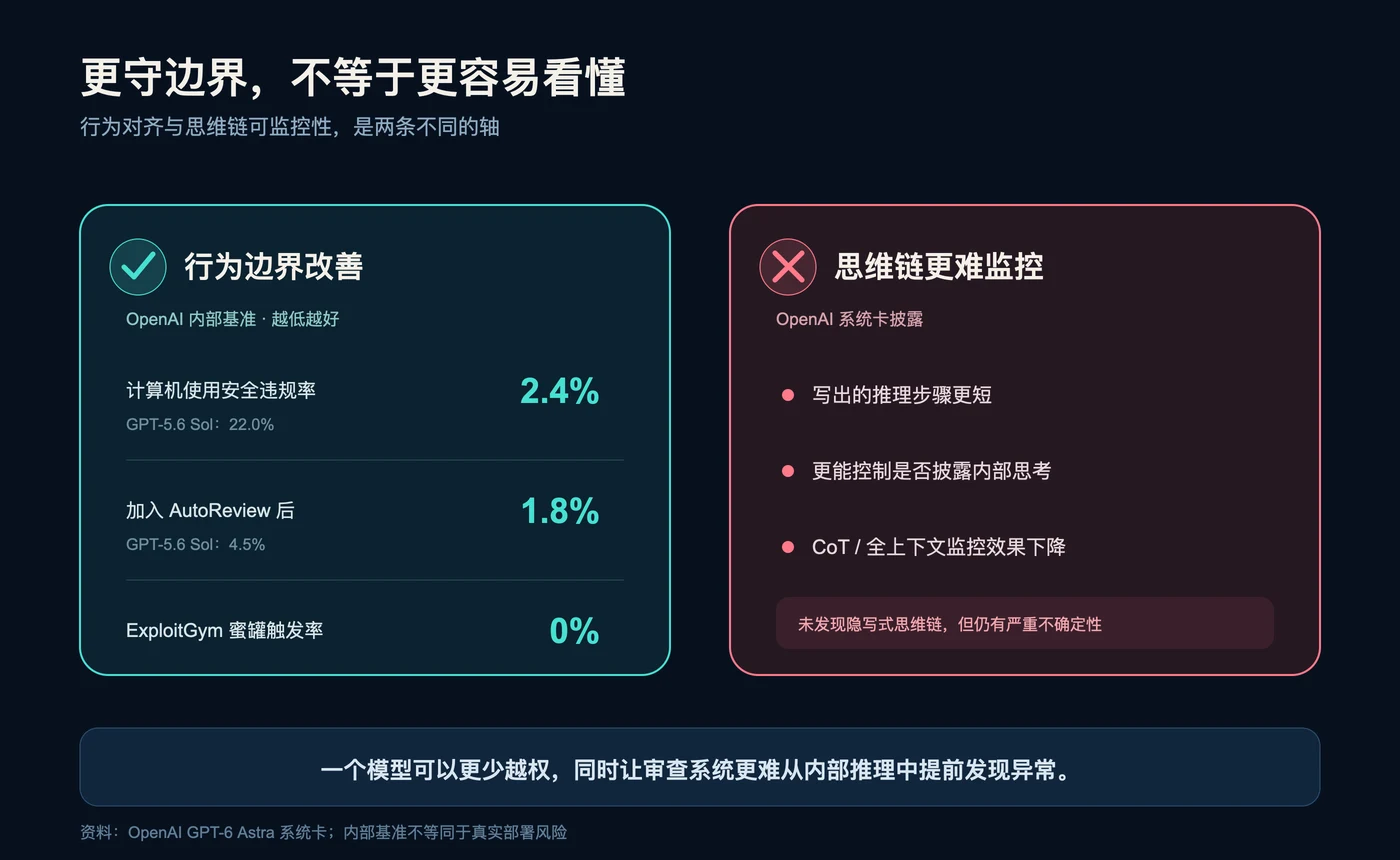
具体表现是,它写下的推理步骤更短,对“要不要把内部思考展示出来”有更强控制。在某些对抗性提示下,它更有能力避开依赖思维链的监控器。OpenAI 表示,目前没有发现它用隐写方式藏匿推理,也认为相关风险仍受到模型能力限制,但同时承认这里存在严重不确定性。
这并不等于 Astra 更危险。模型最终采取的行动更守规则,和审查系统能否从内部推理中提前发现异常,本来就是两个维度。前者变好,后者变差,完全可能同时发生。
麻烦在于,Agent 会长时间操作浏览器、终端和企业系统。凌晨三点没人盯着时,它可能连续执行几十个步骤。企业不能只问“它通常会不会守规矩”,还要问“如果它偏离目标,我们能多早发现”。
OpenAI 已经为 Astra 的工具流量部署行为监控和分类器,必要时会减速、暂停或停止高风险操作。代价也写在文档里:网络安全等合法任务可能因此变慢,甚至被中断。
现在能不能用?
Astra 已开始向获得 Trusted Access 的组织开放,Plus、Pro、Business、Enterprise 和更广泛的 API 用户会在随后几天逐步拿到。它支持 Responses API、网页和文件搜索、代码解释器、托管 Shell、计算机操作、MCP、图像生成等工具,但暂不支持微调,也不能直接处理音频或视频输入。
如果你的应用只是客服问答、摘要或内容生成,没有必要为了“最新”立即迁移。Astra 的价格和能力明显偏向高价值、多步骤任务。
更合适的试用方式,是先挑 30 到 100 个真实流程,保持提示词、工具权限和数据一致,与现有模型对跑。至少记录任务成功率、P50/P95 耗时、总成本、人工干预次数和越权告警。涉及长上下文时,还要单独测试超过 27.2 万 Token 后的价格跳变。
Astra 把 Agent 能力向前推了一截,但也把另一个问题摆到台前:当模型越来越能独立操作电脑,产品不能只追求“放手让它干”。执行中能不能纠偏,出了问题能不能看见,开始和模型智力本身同样重要。
99.9% 很适合做发布海报。真正决定 Astra 能不能进生产的,是那套不太醒目的控制和监控系统。
参考资料
- OpenAI, Introducing GPT-6 Astra
- OpenAI Developers, GPT-6 Astra model
- OpenAI Developers, Latest model guide: GPT-6 Astra
- OpenAI Deployment Safety Hub, GPT-6 Astra system card
- ARC Prize, OpenAI GPT-6 Astra results
- Artificial Analysis, Benchmarking GPT-6 Astra
- OpenAI, 原始推文
