Concitech AI · 深度长文
2026/09/18 09:38
前OpenAI研究员押注Jev:AI决策层迎来新物种
TypeSafe AI 发布 Jev。模型输出 Choice、Score、Noul 与概率分布。速度和成本优势指向 Agent 决策层,厂商评测与社区项目构成首批证据。
聊天模型给人一段文字。Jev 给软件一个判断。
这句话解释了 TypeSafe AI 的产品赌注。
TypeSafe 创始人 Diogo Almeida 是 InstructGPT 论文作者之一。他的姓名出现在 OpenAI 公布的 ChatGPT 团队名单。他提出一个问题:聊天模型的能力跨过多个门槛,软件自动化为何受阻?
他的答案指向输出接口。自由文本适合人类阅读,软件依赖类型、概率与分支。
TypeSafe 花费两年研发 Jev。公司定义 Jev 为首款「System One Model」。名称源自《思考,快与慢》的系统一:快速判断、低延迟响应、有限选项。
Jev 的公开发布日期是 2026 年 9 月 15 日。两天后的社区项目清单覆盖浏览器 Agent、模型路由、代码审查、上下文筛选、桌面控制、知识图谱和游戏控制。
这批项目给出一个信号:AI 模型的下一轮竞争包含「决策层」。
Jev 的三种输出原语
传统大模型接收提示词,输出 token 序列。工程团队承担文本解析、JSON 校验、越界值处理与程序分支转换。
Jev 接收 state 与 typed questions。state 是文本或 JSON 状态。问题定义允许的答案空间。接口返回结构化结果。
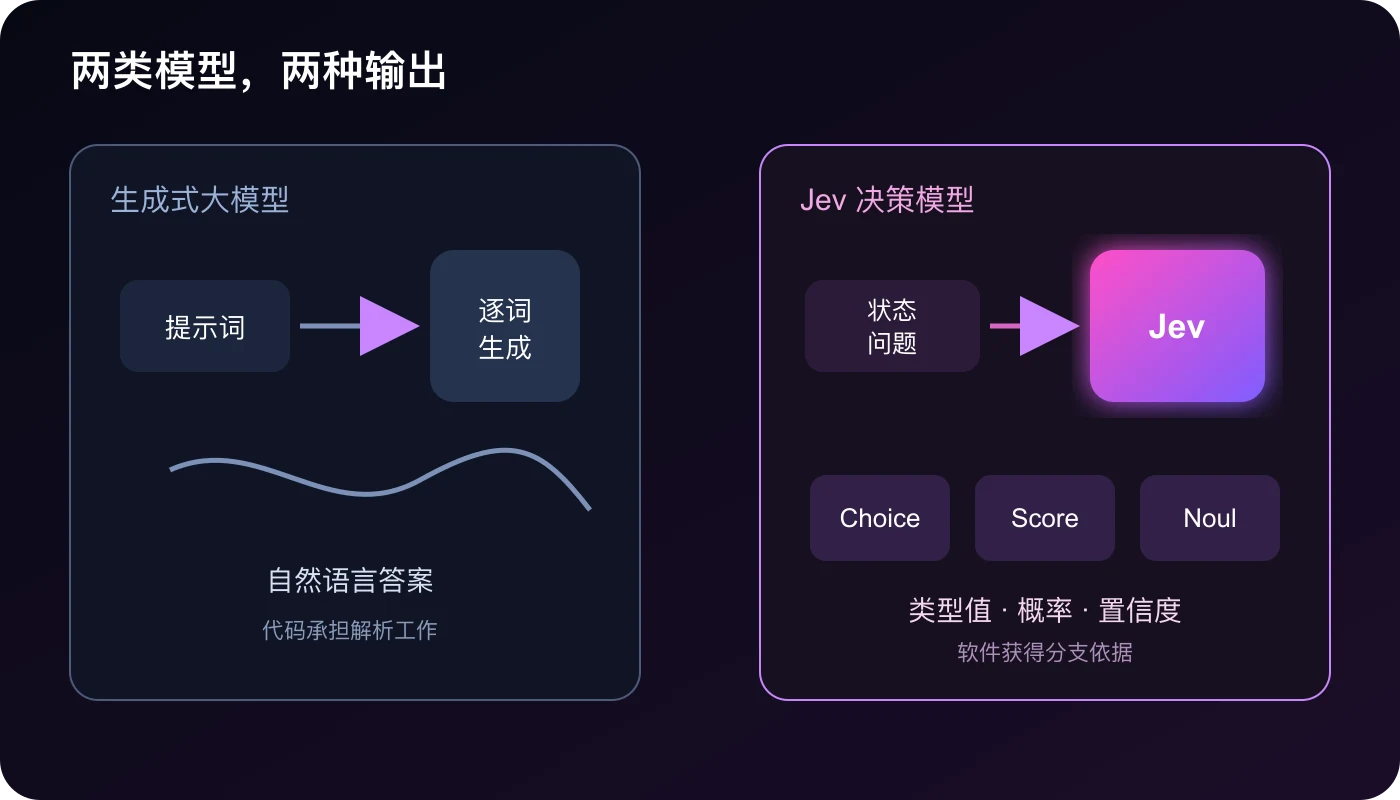
官方文档列出三种原语:
Choice:候选项选择。结果包含选项、各项概率和置信度。
Score:量表评分。结果包含等级、各等级概率和置信度。
Noul:命题判断。结果是 0 到 1 的概率。
多个问题共享同一份状态。每个问题获得独立评估。官方文档称,问题数量对响应时间的影响有限。
Jev 的价值来自接口约束。开发者定义候选集合,模型输出落入集合内部。非法 JSON、虚构字段与额外文本失去出现空间。
「结构合法」与「判断正确」属于两个命题。错误判断属于残余风险。类型约束保证答案形状,模型能力决定答案质量。
概率比答案多一层工程价值
分类器具有标签输出能力。Jev 的差异主张是概率校准。
训练方法的名称是 RLCD,即 Reinforcement Learning for Calibrated Decisions。它的目标是正确答案与可信概率分布。相同类型样本里的 80% 置信判断,理想状态对应 80% 正确率。
软件获得风险控制接口。
高置信结果进入执行分支。中置信结果进入复核队列。低置信结果进入人工路径。阈值属于业务规则,副作用控制权属于代码。
这个设计适合高频、窄域、可枚举的判断:工单分类、告警分级、模型路由、内容筛选、工具选择、检索排序、欺诈线索评分。
长篇写作、开放式规划、代码生成和复杂证明属于生成模型的任务。
20 到 200 倍速度来自什么
Diogo Almeida 给出的发布数字是 20 至 200 倍速度优势、40 至 400 倍成本优势。官方评测页面展示四类内部工作流:安全告警、Agent 轨迹审查、发票处理、客户服务。
数字背后有三个原因。
第一,Jev 排除了自由文本生成。模型输出是有限选项或概率。
第二,多个问题采用并行采样。传统工作流包含多次模型调用。
第三,输出 token 费用为零。Jev 1.13 的输入价是每百万 token 0.042 美元,文本上下文上限是 64K token。
这些数字属于 TypeSafe 自建评测。结果取决于任务设计、比较模型、准确率定义和负载环境。官方页面展示的 Jev 得分缺少全项第一。速度与成本优势成立的前提是任务可拆成结构化判断。
产品发布缺少论文、模型权重与 RLCD 算法细节。独立复现所需材料缺席。发布口号属于厂商主张,真实业务数据决定工程价值。
14 个项目揭示 Jev 的合适位置
社区项目的共同点是「缩短决策回路」。
Browser Use 的 jev-ultrafast 让 Jev 选择浏览器动作与页面元素,文字输入交给小模型。项目演示记录的 Google Flights 搜索耗时是 7.1 秒。
Jev Codex Router 的流程包含编程任务难度评估与模型选择。项目作者使用 237 个真实 turn 回放,报告成本降幅为 60%。这个数字属于项目自测。
Winnow 负责 Claude Code 工具输出的相关性筛选。Blink 负责代码目录与文件的语义概率分配。Jev Review 负责代码风险的前置评分。SemDecide 封装语义判断为 Unix 命令。
游戏项目 1v1 Jev 让模型承担移动、瞄准、开枪等判断,报告频率是 9Hz。这个演示说明低延迟决策的交互价值。
项目列表包含知识图谱寻路、桌面控件选择、MCP 工具、量化研究原型。量化项目 Prism 的默认模式是 shadow/advisory,交易执行权属于原系统。这种边界值得保留。
Jev 改写的是 Agent 成本结构
Agent 的主要浪费来自大量小判断:哪个文件相关,哪个工具合适,哪个结果可信,哪个动作风险更高,哪个模型值得调用。
前沿大模型承担每个小判断。调用次数决定延迟与费用总额。固定规则承担全部判断。系统失去语义弹性。
Jev 试图填补两者之间的空位。
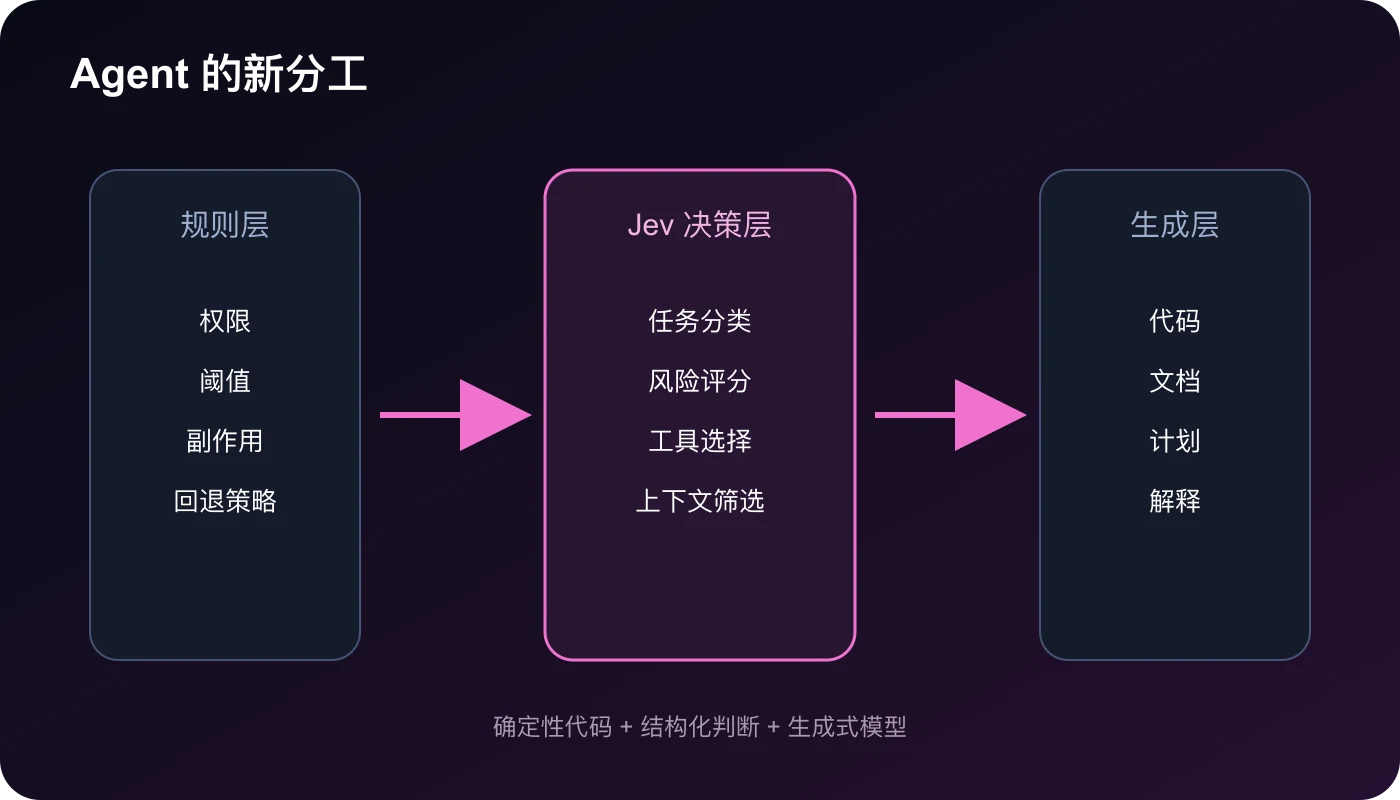
一种新型 Agent 架构包含三层:确定性代码掌握权限和副作用,Jev 处理高频语义判断,生成模型处理长程推理与内容生成。
这套分工带来四个变化。
模型路由成为基础设施。上下文筛选成为独立服务。置信度成为产品状态。人工复核成为概率阈值后的正式分支。
Jev 的商业机会来自调用量。单次决策价格处于低位,高频 Agent 的每个任务包含数十至数百次判断。决策模型瞄准自动化系统的隐形底座位置。
核心考题是校准
Jev 的成败与「输出合法」关系有限。工程框架具备 JSON 和枚举值约束能力。
核心考题是三个指标:判断准确率、概率校准度、跨分布稳定性。
错误选项与 0.99 置信度构成高置信错误。它的系统风险高于普通聊天错误。开发者的必备工具包括自有数据集、风险分层、阈值回测、版本固定与审计日志。
官方文档提示,英文是主要训练语言,其他语言能力存在差异。中文业务的独立评测属于必要环节。模型别名指向新版本。生产系统记录版本号,阈值策略绑定版本。
Jev 与 AGI 答案之间存在距离。它代表一条值得关注的工程路线:模型输出完成形态变化,「一段话」变成「一个可执行判断」。
聊天模型打开了人机对话市场。决策模型瞄准机器与机器之间的接口。
懂得选择的模型,是这场变化的主角。
资料来源:TypeSafe AI 发布文章、TypeSafe 官方文档、TypeSafe 工作流评测、Diogo Almeida 公开推文、社区项目仓库。性能数字含厂商自测或项目自测口径。
