Concitech AI · 深度长文
2026/09/21 21:20
LangChain测试Jev裁判:平均延迟0.44秒,样本量5条
LangChain的Jev裁判实验包含5条固定天气Agent轨迹、4个评测器和100次重复判断。Jev取得最低延迟与最低方差,连续质量分数的人工标签贴近度落后。
Agent 评测有两条常见路线。代码评测器检查格式、字段和规则;LLM 裁判处理开放答案。LangChain 团队测试了第三种工具:Jev。
公开实验给出四个醒目数字:Jev 的二元判断准确率是 100%,质量分数方差低于三款 LLM 裁判,平均延迟是 0.44 秒,单次成本是 0.00035 美元。
另一组数字值得同等关注。Jev 的连续质量分数平均绝对误差是 0.106,四个评测器中数值最高;±0.10 容差命中率是 60%,四个评测器中数值最低。Jev 的强项是稳定性。连续分数与人工标签的贴近度属于另一回事。
样本量是 5 条天气 Agent 轨迹。这是一项小样本实验,通用结论缺少证据。
Jev裁判的工作方式
Jev 是 TypeSafe AI 的 System One 决策模型。输入包含状态、问题和候选项,输出是类型化答案。答案类型包括 Choice、Score 和 Noul。
LLM 裁判生成文本,程序提取评分。Jev 返回数值、布尔值或选项。相同状态支持多道问题,状态编码具备复用能力。
这种接口适合 Agent 评测:轨迹充当状态,评测标准充当问题,分数与通过标记充当答案。评测链路省去解析器、JSON 修复和提示词格式约束。
实验设置:5条轨迹、4个裁判、100次重复
实验对象是一个天气 Agent,技术组件包括 Deep Agents 和 Tavily。五条测试轨迹对应西雅图当前天气、奥斯汀周末预报、都柏林带伞判断、东京延伸预报和地点含糊的 Springfield 查询。
每条轨迹的 Agent 输出固定。四个裁判读取同一批内容,单个裁判的重复次数是 100。固定轨迹排除了 Agent 输出波动,评测器成为唯一变化项。
评测信号包含两项:
does_pass:二元通过判断quality:0 至 1 的连续质量分数
一名人工评审员提供参考标签。四个裁判是 Jev、GPT-5.6 Luna、GPT-5.6 Terra 和 Claude Sonnet 4.6。
二元判断:Jev的500次结果匹配人工标签
五条轨迹乘以 100 次重复,单个裁判产生 500 个二元判断。Jev 的 500 个判断匹配人工标签,准确率是 100%。Terra 是 99.8%,Luna 是 96.4%,Claude 是 80%。
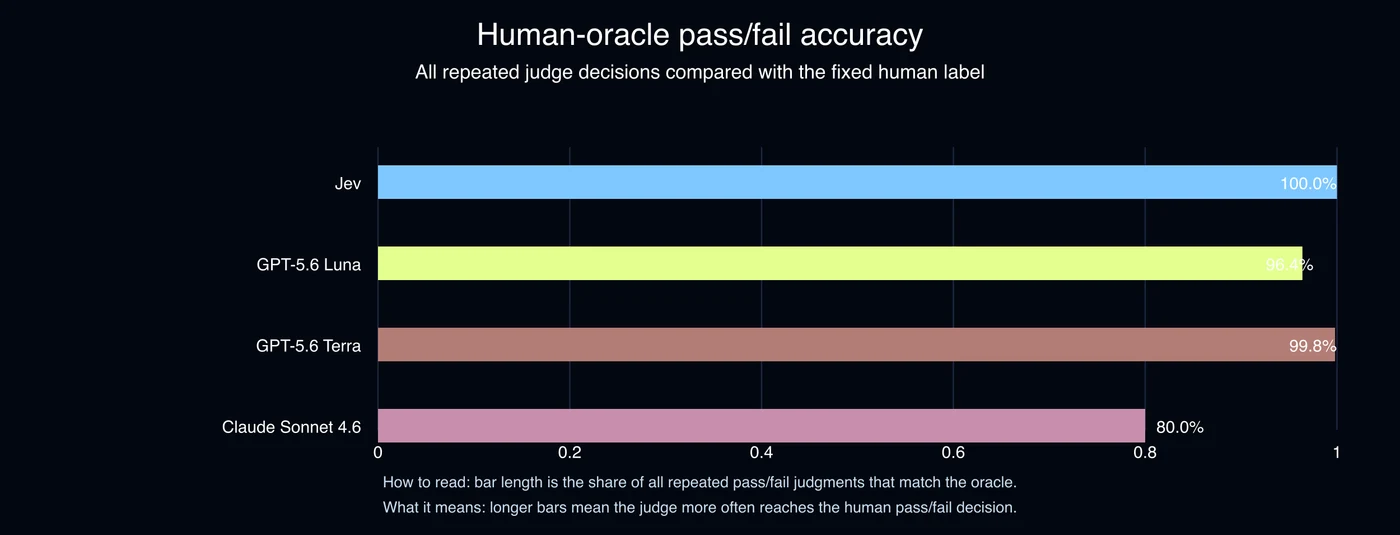
Claude 的 80% 来自一个集中错误。Springfield 轨迹的 100 次判断偏离人工标签,其余四条轨迹匹配人工标签。这个结果呈现单个样本触发的系统性分歧,随机抖动的解释力偏弱。
Jev 的二元误差数是 0。五条样本的覆盖面限制了统计外推。
重复性:质量分数方差相差92至913倍
Jev 的平均质量分数方差是 0.0000149。Claude 的方差是 0.00137,倍数是 Jev 的 92 倍。Luna 的方差是 0.00647,倍数是 433 倍。Terra 的方差是 0.01364,倍数是 913 倍。
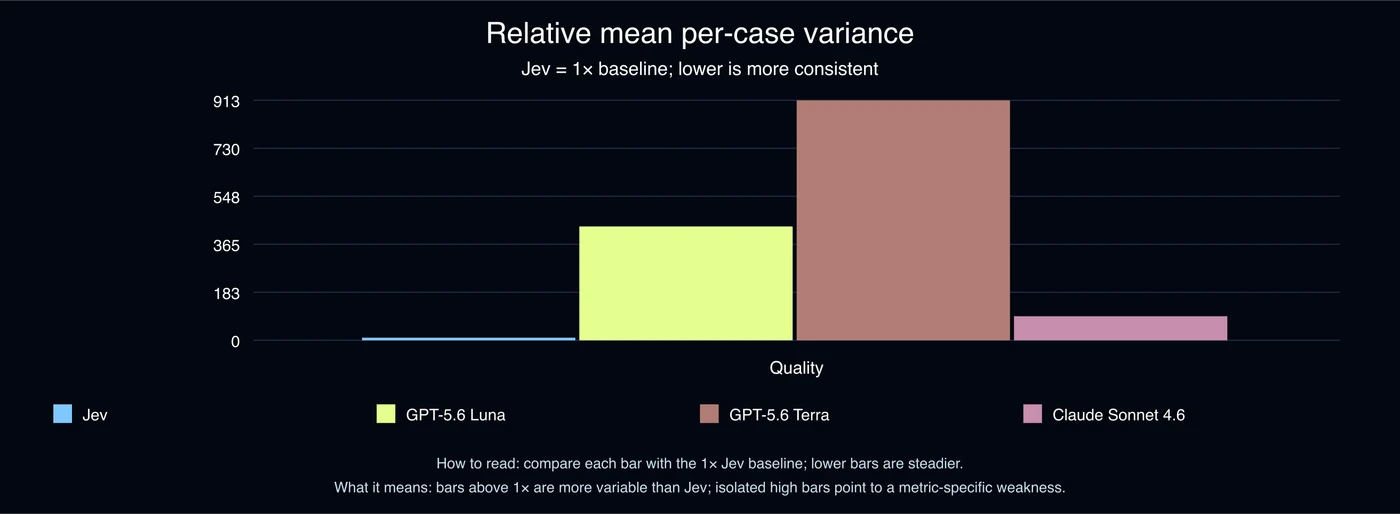
这组数字回答重复性问题:相同输入的分数接近程度。低方差代表稳定输出。正确性属于独立指标。
Agent 评测平台重视重复性。分数抖动制造回归噪声,质量门槛产生频繁翻转。Jev 的类型化输出和低方差适合高频评测流水线。
质量分数:稳定性领先,人工标签贴近度落后
仓库的 accuracy.json 记录了连续质量分数与人工标签的距离。Jev 的平均绝对误差是 0.106,Luna 是 0.087,Terra 是 0.077,Claude 是 0.078。
±0.10 容差命中率呈现同一方向:Jev 是 60%,Luna 是 65%,Terra 是 68.6%,Claude 是 76.4%。
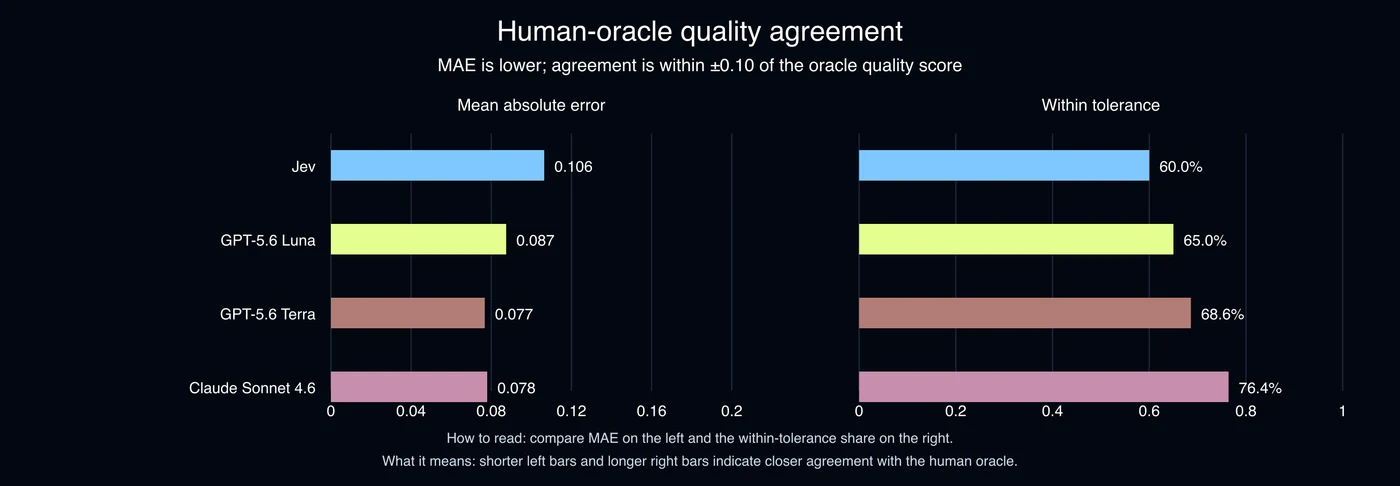
这张图改变了标题数字的含义。Jev 给出的分数方差最低,分数和人工标签的距离最大。稳定性与标注一致性属于两项指标。
二元判断与连续评分呈现两种结果。Jev 的通过判断命中 500 次,细粒度质量分数的贴近度落后。Agent 团队的评测目标决定指标选择:质量门禁偏向二元可靠性,模型排名偏向连续分数校准。
成本与延迟:0.44秒,单次0.00035美元
Jev 的平均延迟是 0.44 秒。Luna 是 2.50 秒,Terra 是 2.83 秒,Claude 是 2.16 秒。
Jev 单次成本是 0.00035 美元,Luna 是 0.00039 美元,Terra 是 0.00289 美元,Claude 是 0.02811 美元。四者的实验总成本是 0.34 美元、0.39 美元、2.90 美元和 28.17 美元,排列顺序相同。
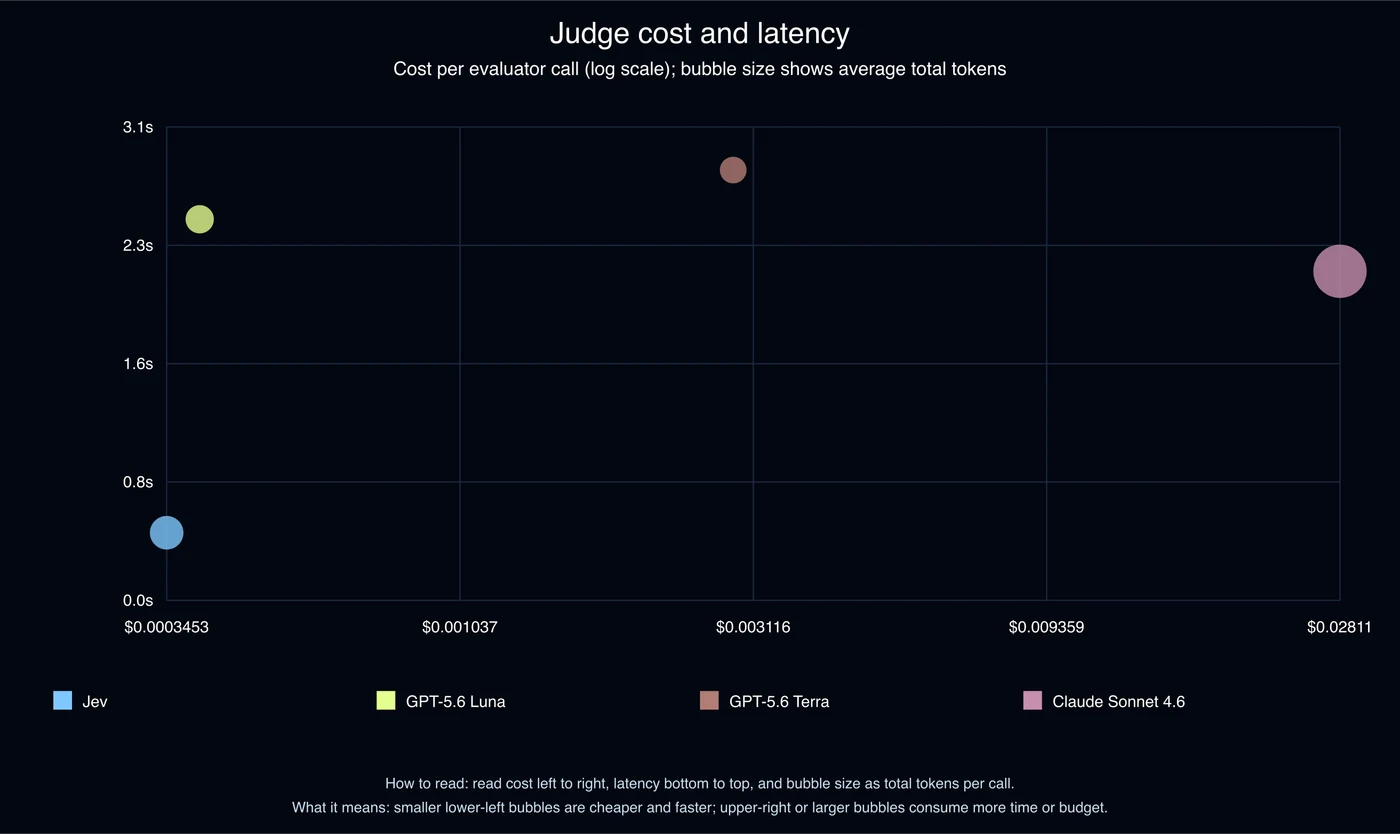
Jev 与 Luna 的单次成本接近,延迟差距是 2.06 秒。Claude 与 Jev 的单次成本倍数是 80.3。大规模线上评测放大这类差异。
这项实验的边界
样本规模是首要限制。五条轨迹来自同一个天气 Agent,任务类型集中,语言范围和工具类型有限。
人工参考来自一名评审员。多人一致性数据缺席,参考标签本身的误差范围未知。
实验采用固定 Agent 输出,评测器的重复性得到隔离。端到端系统中的检索波动、工具失败和轨迹长度变化位于测试范围之外。
三款 LLM 裁判采用提供商默认生成设置。温度、top-p、seed 和最大 token 数的显式配置缺席。实验元数据缺少 Jev 托管服务版本字段。
这些限制定义了结论边界:这组数据支持一个天气 Agent 的固定轨迹评测,跨领域裁判排名缺少证据。
Agent评测的第三种工具
Jev 适合边界清晰、格式固定、调用密集的评测题。LLM 裁判擅长开放式批评、错误解释和新标准发现。
组合架构符合两类模型的特征:Jev 负责结构化打分和规则判断,LLM 裁判负责开放分析,人类标签负责基准校准。
LangChain 这次实验的价值来自指标拆分。四张图把评测器拆成准确率、重复性、延迟、成本和校准度。稳定性与人工分数偏差并存。Agent 评测包含这两项检查。
