Concitech AI · 深度长文
2026/09/08 21:16
MCP 真是 Token 黑洞吗?一篇论文测完 7 个 Agent,发现最贵的另有其人
一项覆盖 7 种 Agent Harness、5 个模型和 54 个主矩阵配置的实验发现,同一个软件任务的 Token 消耗最高相差 20 倍。主导成本的可能不是 MCP 或 CLI,而是包在模型外面的 Harness。
Pi 最近分享了一篇很有意思的论文。
研究团队让 7 种 Agent Harness、5 个语言模型完成同一个 GitHub 任务,然后逐项检查仓库状态,统计每次运行到底用了多少 Token、调用了什么工具、是否真的完成工作。
最后的结果很夸张:
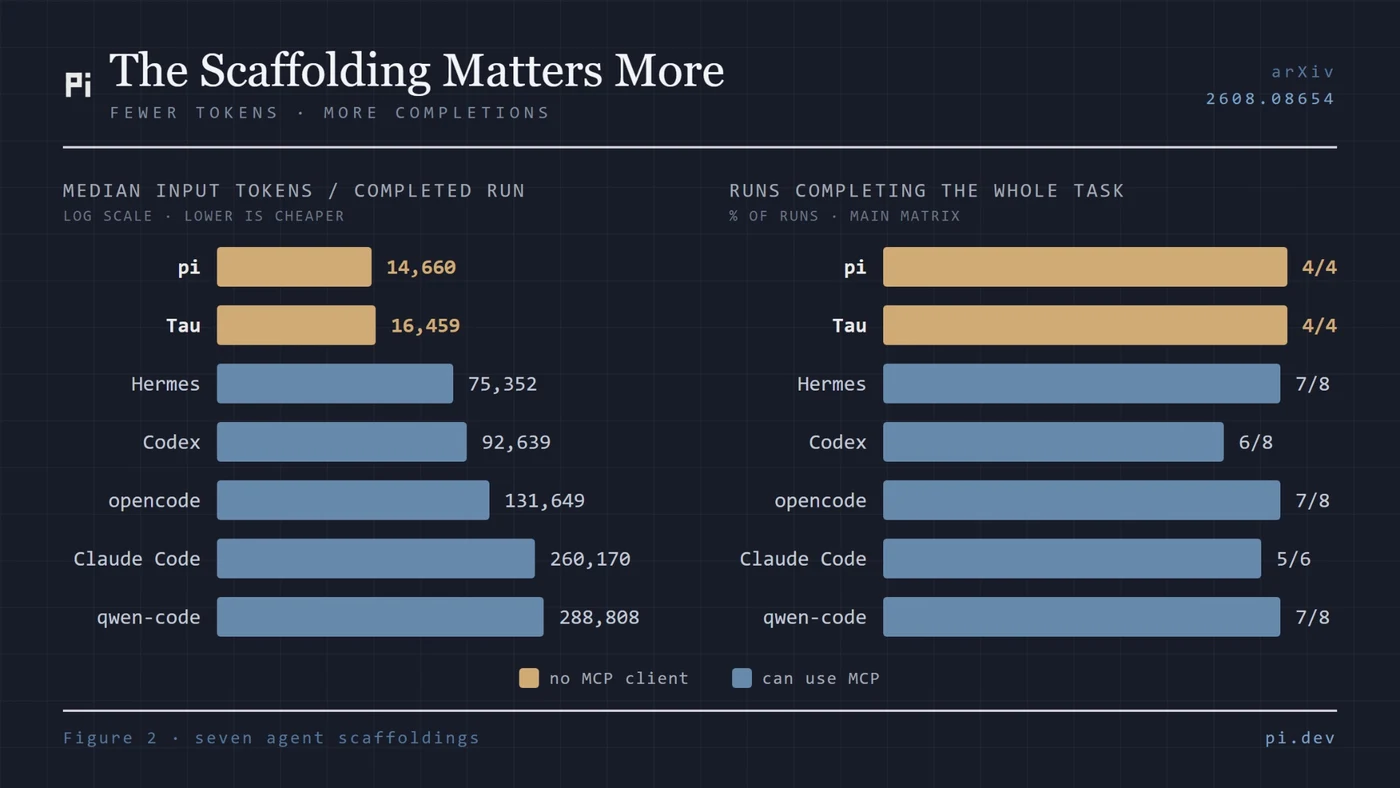
Pi:14,660 input tokens
Tau:16,459
Hermes:75,352
Codex:92,639
OpenCode:131,649
Claude Code:260,170
qwen-code:288,808
最便宜和最贵之间相差接近 20 倍。
更意外的是,研究团队原本想回答“MCP 比 CLI 贵多少”,做完实验后却发现,这个问题没有稳定答案。相对稳定的差异,来自包在模型外面的 Agent Harness。
论文标题就叫:The Scaffolding Matters More Than the Interface,脚手架比接口更重要。
这次实验到底测了什么
研究团队设计了一个固定的软件任务,让 Agent 对一个私有 GitHub 仓库完成 6 个操作:
- 找到指定的 Issue。
- 创建一个分支。
- 把给定补丁应用到文件。
- 提交修改。
- 创建 Pull Request。
- 统计指定目录中的文件数量。
这个任务同时需要本地文件操作和远程 GitHub 操作,也能留下可核验的结果。
研究团队没有相信 Agent 最后的自我汇报,而是通过 GitHub API 检查四项事实:分支是否存在、补丁是否真正写入、Pull Request 是否创建、文件数量是否回答正确。
这一点很重要。Agent 说“已经完成”和仓库里真的出现修改,是两回事。
参与测试的 7 种 Harness 是:
| Harness | 是否内置 MCP 客户端 |
|---|---|
| Claude Code | 是 |
| OpenAI Codex | 是 |
| qwen-code | 是 |
| Hermes | 是 |
| OpenCode | 是 |
| Pi | 否 |
| Tau | 否 |
其中前五种分别测试 MCP 和 CLI 两种模式。MCP 模式连接官方 GitHub MCP Server;CLI 模式不连接任何 MCP Server,只允许 Agent 使用 Shell、git 和 gh。
Pi 和 Tau 本身没有 MCP 客户端,只测试 CLI。Tau 是一个用 Python 独立实现的极简 Harness,与 Pi 共享设计理念,但不共享代码。
论文的主矩阵包含 54 个配置。每次请求都经过统一代理,记录 input tokens、cached tokens、工具调用和每轮携带的 Schema 数量。本地模型配置另外重复运行,用来估算同一配置的随机波动。
第一个结论:最贵的不一定是 MCP,而是 Harness
把 MCP 和 CLI 结果先放在一起,7 种 Harness 完成一次任务的中位 input tokens 如下:
| Harness | 中位 Input Tokens | 主矩阵完整完成 |
|---|---|---|
| Pi | 14,660 | 4/4 |
| Tau | 16,459 | 4/4 |
| Hermes | 75,352 | 7/8 |
| Codex | 92,639 | 6/8 |
| OpenCode | 131,649 | 7/8 |
| Claude Code | 260,170 | 5/6 |
| qwen-code | 288,808 | 7/8 |
Pi 和 Tau 不但最省 Token,在主矩阵里也完成了全部尝试。Tau 后续的重复实验中出现过一次失败,因此不能把它们写成“永不失败”,但两者的成本仍明显低于其他 Harness。
为了排除 MCP Catalogue 本身的影响,论文又只比较 CLI 组。这一组里没有任何 Harness 连接 MCP Server,所有 Agent 都使用同样的 git、gh 和 Shell。
结果仍然相差巨大:
| CLI 模式 | 中位 Input Tokens | 相对 Pi |
|---|---|---|
| Pi | 14,660 | 1.0× |
| Tau | 16,459 | 1.1× |
| Codex | 82,378 | 5.6× |
| Hermes | 83,954 | 5.7× |
| OpenCode | 137,800 | 9.4× |
| qwen-code | 297,649 | 20.3× |
| Claude Code | 410,797 | 28.0× |
也就是说,即使大家都不用 MCP,只换一套 Harness,同一个任务仍然可以相差 5 到 28 倍。
但这里不能偷换成“因为 Pi 没有 MCP,所以它便宜 28 倍”。Pi 和 Tau 与其他 Harness 的差异远不止有没有 MCP。系统提示词、默认工具数量、每轮附带的 Schema、上下文整理、重试方式、子任务机制和 Agent Loop,都可能改变总消耗。
论文证明的是两类 Harness 在这个任务上存在巨大差距,没有单独证明其中哪一项设计导致了差距。
第二个结论:MCP 对 CLI,没有一个固定倍数
网上常见的说法是,MCP 会比 CLI 多花 3 倍、10 倍,甚至 35 倍 Token。
这篇论文专门做了同 Harness、同模型下的 MCP 对 CLI 配对比较。13 组严格配对结果从 0.43× 一直跨到 29.06×,中位数是 0.93×。
有的配置中 MCP 贵很多,有的配置中 MCP 反而更便宜:
| Harness | MCP ÷ CLI |
|---|---|
| Claude Code | 0.57× |
| qwen-code | 0.74× |
| Hermes | 0.84× |
| OpenCode | 0.95× |
| Codex | 16.09× |
上表是各 Harness 完成任务后的组内中位数,两边可能包含不同模型组合,因此最严格的判断仍应看那 13 组同模型配对。两种算法得到的共同结论是:MCP 没有一个可以脱离 Harness、模型和任务单独引用的固定成本倍数。
论文测得,同一个配置重复运行时,Token 消耗的典型跨度约为 1.51×,最宽达到 5.41×。小于两倍的差异,很可能还没有超过 Agent 自身的随机波动。
所以,“MCP 一定比 CLI 贵多少倍”这种说法,至少不能从这项实验里得到支持。
第三个结论:工具如何交给模型,比工具属于什么协议更重要
论文发现了一个很值得继续验证的机制。
GitHub MCP Server 一共提供 44 个工具。Codex、qwen-code、Claude Code 和 OpenCode 会在每次模型请求中发送完整 Catalogue。任务如果需要 20 轮交互,这 44 份工具说明就会重复进入 20 次请求。
Hermes 使用的是按需发现方式。它每轮只发送 7 个 Schema,其中两个是网关工具:一个负责查找和描述可用工具,另一个按名称执行工具。其余工具说明只有在模型需要时才取回。
在完成的 MCP 运行中,两种方式的中位 Token 是:
按需获取,7 个 Schema:70,836
全量发送,44 个 Schema:216,986
相差约 3.1 倍。
这还不能成为“按需发现必然省 3.1 倍”的结论,因为样本里只有 Hermes 使用这种方式,Harness 的其他差异没有被排除。
但它至少指出了一个比“MCP 还是 CLI”更具体的问题:
每次请求到底向模型发送了多少工具说明?
同样连接 MCP,可以把 44 个 Schema 永久塞在上下文里,也可以只保留一个轻量入口,用到时再发现。协议相同,模型承担的上下文却完全不同。
失败次数一样,失败成本却差了近 6 倍
主矩阵中,MCP 组和 CLI 组都失败了 3 次,都是 19 次尝试中的 3 次。后续重复实验也都是 29 次中完成 25 次。
因此,这份数据没有证明 MCP 更容易失败。
差异出在失败发生在哪里:
| 模式 | 失败消耗占总 Token | 失败消耗占估算成本 |
|---|---|---|
| CLI | 7.3% | 2.2% |
| MCP | 9.8% | 12.9% |
MCP 组失败的三个配置恰好更昂贵,失败成本约是 CLI 组的 6 倍。论文也明确提醒,失败样本只有 6 个,不能据此认定这是协议属性。
这个结果仍然揭示了 Agent 成本里经常被忽略的一部分:失败不是便宜地提前退出。该实验中,失败运行的 Token 中位数大约是成功运行的两倍。Agent 往往会反复尝试、修复和绕路,花掉更多 Token,最后仍然没有交付。
只统计“成功一次要多少钱”,会漏掉失败重试产生的生产成本。
Agent 经常不用你指定的工具
研究团队早期做过一组没有彻底隔离凭证的实验。21 次运行都连接了 GitHub MCP Server,但 Agent 的实际行为是:
6 次只使用 MCP
6 次完全绕过 MCP,改用 Shell
6 次混合使用 MCP 和 Shell
3 次没有调用任何工具
其中还有 4 次直接通过 HTTP 调用 GitHub API。
即使在提示词里明确要求使用指定接口,行为也没有明显改变。研究团队最后在环境层移除了其他路径:CLI 组不配置 MCP,MCP 组则让 Shell 里的 gh 拿不到凭证。
这对所有 Agent Benchmark 都是个提醒。配置里“提供了 MCP”不代表模型实际用了 MCP;提示词里“要求使用 CLI”也不代表它没有偷偷走 API。
如果不记录真实工具调用,测出来的可能只是几种路径混在一起的平均数。
27B 小模型缺的,可能不是能力
论文中最夸张的一组数据来自本地运行的 270 亿参数模型 qwen3.6:27b。
同一个模型、同一个任务,在不同 Harness 和接口组合下:
Tau + CLI:17,416 tokens
Pi + CLI:25,548
Hermes + MCP:66,320
Claude Code + MCP:188,183
qwen-code + MCP:397,922
Codex + MCP:2,418,828
最便宜和最贵相差 139 倍。
这个模型在 12 个配置中的 10 个完成了全部任务,也在每一种被测 Harness 下至少成功过一次。它不是完全不会做,而是在某些 Harness 里为了做成同一件事,被迫携带更多上下文、进行更多轮交互和工具调用。
Codex + MCP 那次成功运行调用了 108 次工具,最终消耗超过 241 万 input tokens。Tau 用 7 次工具调用和 1.7 万 tokens 完成了同样任务。
对本地小模型来说,Harness 不是一层可以忽略的包装。它可能直接决定这项工作能否经济地运行。
这篇论文不能证明什么
数据很抢眼,但边界同样清楚。
首先,论文目前是 arXiv 预印本,不等于已经完成同行评审。
其次,它只测试了一个 GitHub 任务。GitHub 已有成熟的 git 和 gh,CLI 天然占优。如果某个服务没有可靠 CLI,MCP 的标准化发现、认证和结构化调用可能更有价值。
再次,Hosted 模型的大部分配置只运行一次,论文自己测得单次 Agent 运行波动可以很大。7 种 Harness 的模型覆盖也不完全一致,所以不能把表中每一行都当成严格的模型控制实验。
最后,Pi 和 Tau 的优势不能只归因于“没有 MCP”。它们与其他 Harness 在系统提示词、默认工具、上下文管理和 Agent Loop 等方面都不同。论文测到了整体差异,没有把每个组件单独消融。
这些限制不会推翻结果,但会改变我们应该怎样使用它。
更实际的 Agent 选型方式
如果任务固定,而且目标服务已经有成熟 CLI,优先从更薄的 Harness 开始。Shell、少量文件工具和明确的验证器,可能已经足够。
如果任务开放、服务很多、工具会动态变化,MCP 仍然有价值。但不要默认把所有 Schema 永久发给模型。按需发现、Tool Search、网关工具和渐进披露,通常更符合 Token 预算。
评估时也不要只记录总 Token。至少同时记录每轮 Schema 数量、缓存命中率、真实工具路径、工具调用次数、失败消耗和外部状态验证。
最后,别只优化模型。一个昂贵模型放进精简 Harness,可能比一个便宜模型放进臃肿 Harness 更省钱;一个 27B 本地模型,也可能因为 Harness 选错而多花两个数量级的上下文。
这篇论文最后把 Agent 成本写成了一个更接近现实的乘法:
模型 × Harness × 工具接口 × 任务 × 恢复策略MCP 当然会占上下文,CLI 也不是免费的。但在这次实验里,决定账单的最大变量不是接口名称,而是模型每一轮到底被 Harness 塞进了多少东西,又被带着绕了多少路。
