Concitech AI · 深度长文
2026/09/25 04:40
OmniJev开源:0生成Token的视觉决策模型
OmniJev接收图像、视频、屏幕和机器人视角,输出Choice、Score、Noul三类概率。本文介绍模型架构、项目方测试、延迟、安装方式和适用边界。
视觉语言模型擅长描述画面。机器人、浏览器 Agent 和监控系统面对另一类需求:动作选择、风险评分、事件判断。
OmniJev 的答案形态是概率分布。
北京中关村学院、中国科学院自动化研究所与智进化团队发布了这个全模态决策模型。项目开放 0.8B、2B、4B 三个版本,代码与权重采用 Apache-2.0 许可证。
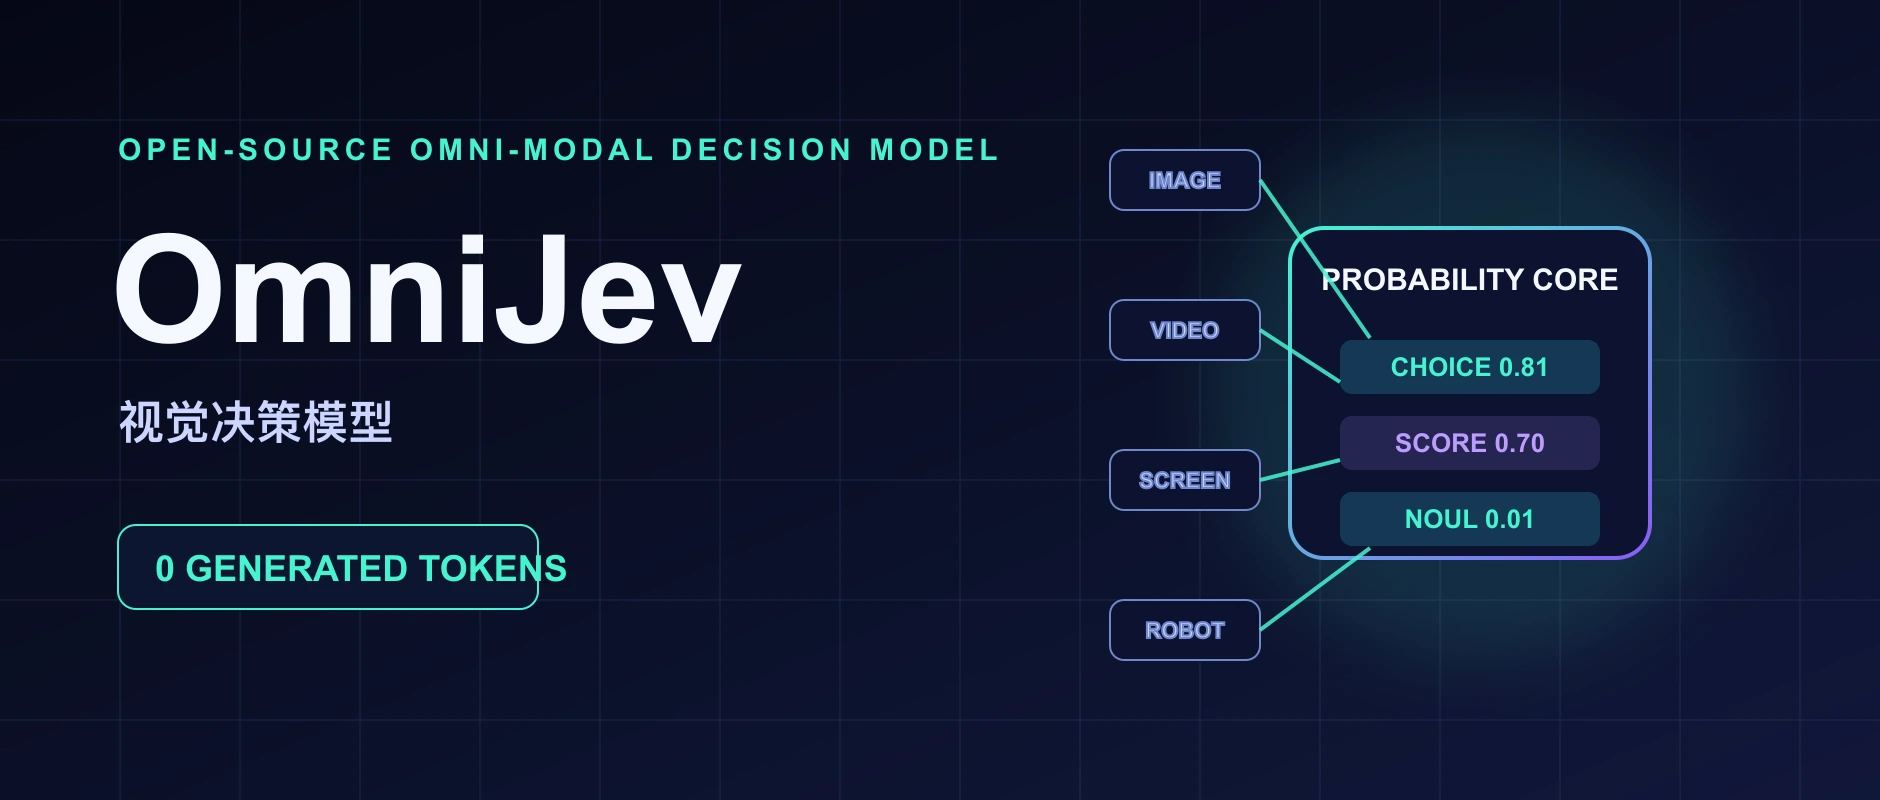
项目的核心主张是:状态进入模型,决策离开模型。文本解码环节缺席,生成 Token 数量为零。
视觉模型的概率接口
OmniJev 接收视觉状态、文字上下文与问题集合。视觉状态覆盖图像、视频、应用界面、网页、棋盘、游戏画面和机器人视角。
问题拥有固定类型。模型输出每个答案的概率。
Choice 对应候选项选择。输出包含各项概率、选中项与拒答概率。候选项支持图像区域,坐标范围是 0 至 1000。
Score 对应有序量表。输出包含等级与各等级概率。任务进度、风险程度、数量区间属于典型用途。
Noul 对应命题判断。输出是 0 至 1 的概率。火焰、错误弹窗、任务完成状态属于命题样本。
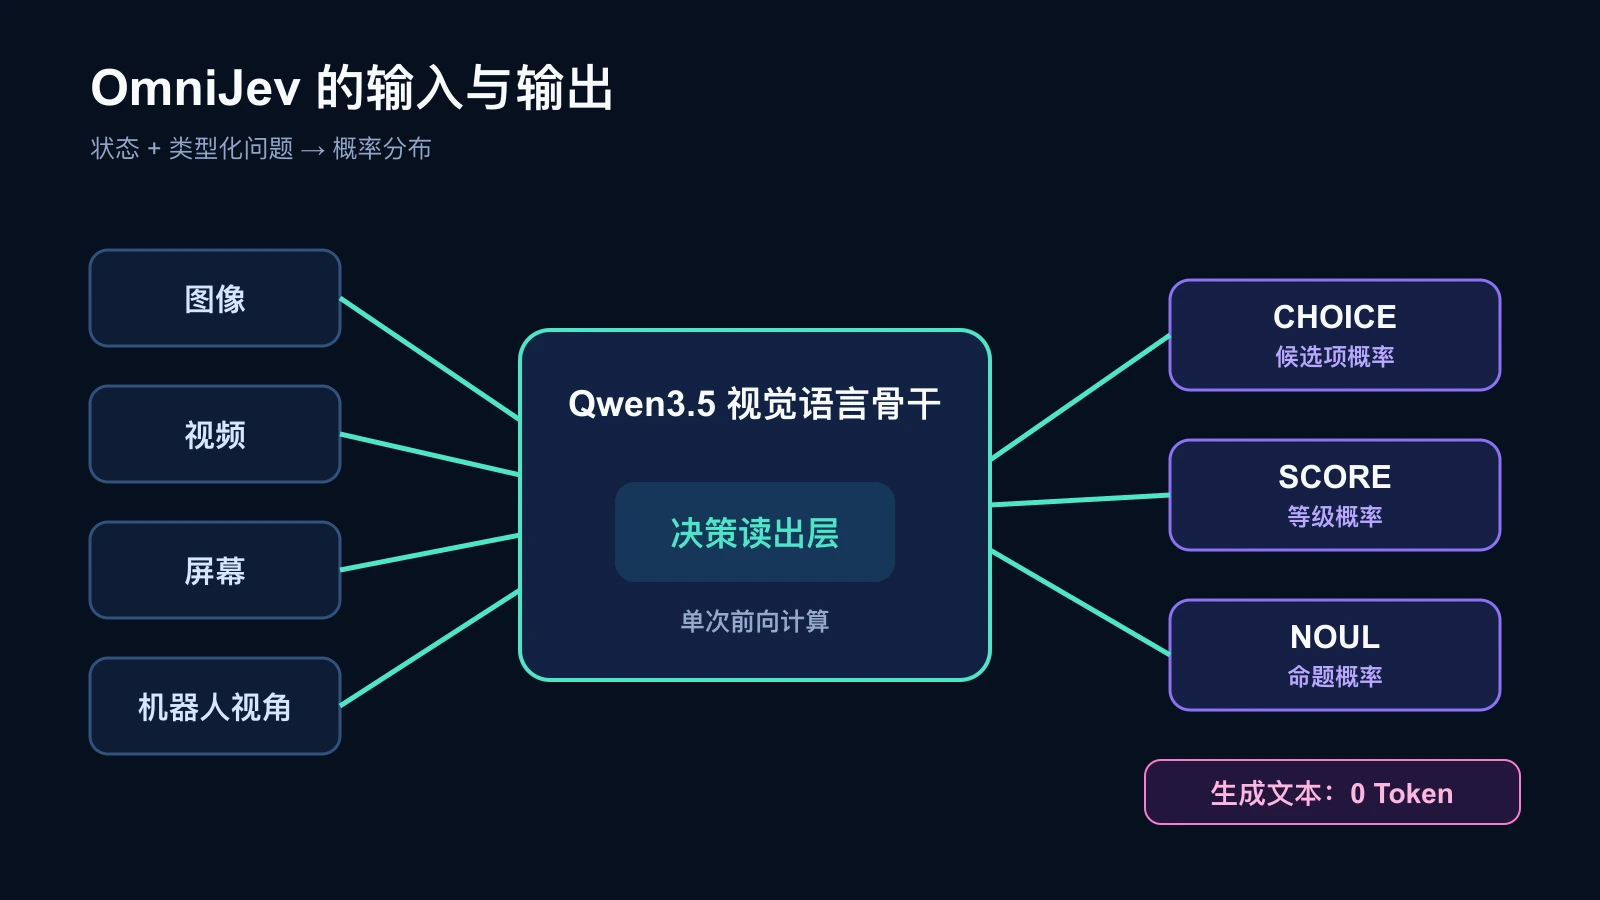
传统视觉大模型的链路包含视觉编码、文字生成、文本解析和字段校验。OmniJev 删除文字生成与解析环节。决策读出层产生固定结构。
结构约束解决答案形状。概率校准解决置信度含义。Proper scoring rules 负责决策概率训练,留出数据负责温度校准。
0.9 置信度的理想含义是九成正确率。概率分层组成阈值接口:高置信动作进入执行队列,中置信动作进入复核队列,低置信动作进入拒答分支。
一次计算,多项判断
同一张画面包含多道问题。
浏览器 Agent 识别目标元素、动作类型、任务进度和操作风险。机器人判断子任务、移动方向、抓取状态和完成状态。监控系统判断危险类型、紧急程度和危险区域。
OmniJev 共享视觉前缀。单次前向计算承担整组问题。每道问题拥有独立概率分布。
README 公布的训练集规模是 27 万条决策记录与 130 万个类型化问题。数据范围包含网页、手机、机器人、视频、游戏、手势、危险场景和声音频谱图。
三个模型采用 Qwen3.5 视觉语言骨干。OmniJev 权重属于增量权重,README 标注 4B 增量文件大小为 290MB。运行环境包含对应的 Qwen3.5 基础模型。
视频输入采用 16 帧时间戳采样。采样帧组成一张拼图,模型读取整段事件状态。这项设计压低计算量。帧采样限制细粒度时间信息。
项目方测试成绩
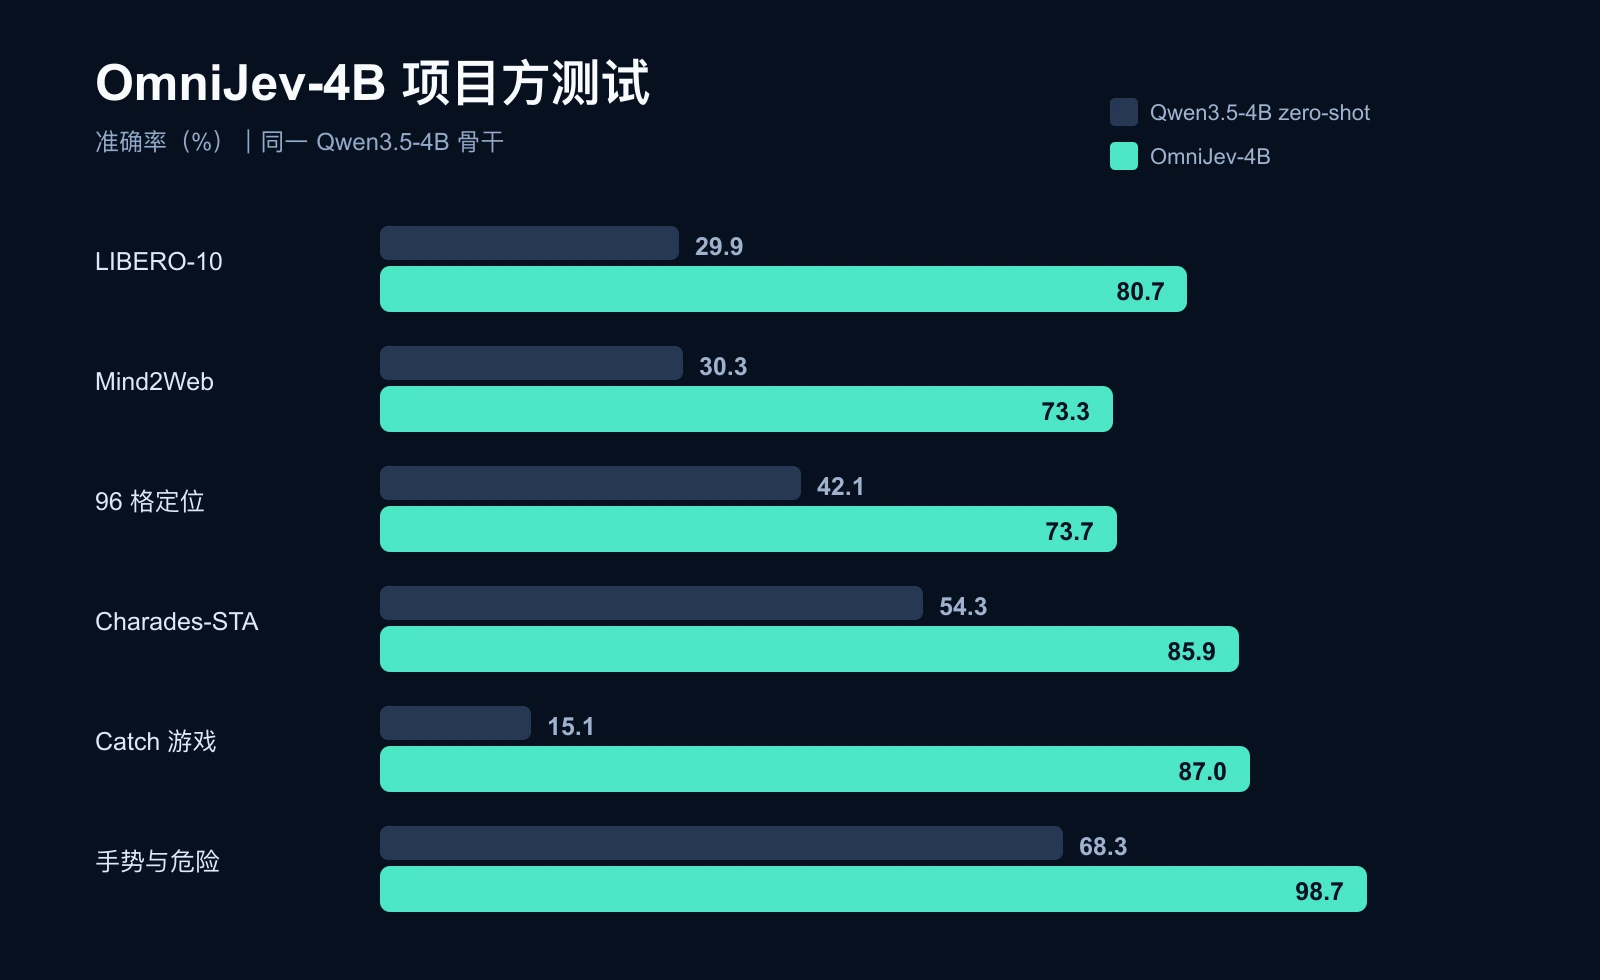
项目 README 公布了留出集结果。4B 版本与 Qwen3.5-4B zero-shot 骨干使用相同问题格式。
六组代表结果如下:
- LIBERO-10 机器人决策:29.9% 与 80.7%。
- Mind2Web:30.3% 与 73.3%。
- 网页 96 格定位:42.1% 与 73.7%。
- Charades-STA 视频事件:54.3% 与 85.9%。
- Catch 游戏:15.1% 与 87.0%。
- 手势与危险识别:68.3% 与 98.7%。
每组数字的前者属于基础模型,后者属于 OmniJev-4B。
排行榜留下两项反例。OK-VQA 的基础模型成绩是 86.0%,OmniJev-4B 是 80.9%。LongVideoBench 的两项成绩是 58.5% 和 58.2%。专用训练改变了能力分布。通用能力升级属于另一个命题。
全部数字来自项目团队。第三方复现记录处于空白状态。数据集构造、切分方式和评测脚本决定结果含义。生产项目要求自有样本测试。
两组延迟数字
项目官网首页显示 4B 版本单图单题 103ms,同图十二题 153ms。GitHub README 的同卡复测给出另一组数字:294ms 和 436ms。
README 的测试设备是一张 NVIDIA A800-SXM4-40GB,图像预算是 768 Token,统计值来自 12 次运行的中位数。2B 版本的单题时延是 217ms,十二题时延是 277ms;0.8B 版本对应 216ms 与 236ms。
README 解释了更新原因:旧数字来自多种硬件,同表比较缺乏可比性。本文采用同卡复测数据。官网数字与仓库数字之间的冲突构成文档问题。
十二题的单位问题成本低于单题成本。视觉编码复用贡献了这项差异。0 生成 Token 消除了输出长度波动,端到端延迟仍受图像编码、骨干规模、硬件与服务队列影响。
安装与调用
仓库提供 mso.infer 推理代码。4B 版本的基础步骤如下:
git clone https://github.com/tinnel123666888/OmniJev
cd OmniJev
python -m venv venv
./venv/bin/pip install -r requirements.txt

hf download tinnel123/OmniJev --local-dir ckpt
hf download Qwen/Qwen3.5-4B --local-dir base
Python 调用的核心对象是 MSO1:
from mso.infer import MSO1

model = MSO1("ckpt", "base")
answers = model.system_one(
    {"images": ["screen.png"]},
    {
        "op": {
            "type": "choice",
            "instructions": "Which operation comes next?",
            "criteria": {
                "click": "tap an element",
                "type text": "",
                "scroll": ""
            }
        },
        "risk": {
            "type": "score",
            "instructions": "How irreversible is the next action?",
            "levels": ["harmless", "needs care", "irreversible"]
        },
        "error": {
            "type": "noul",
            "instructions": "This screen shows an error dialog."
        }
    }
)
返回值保留问题 ID。Choice 结果含候选项概率和 abstain 概率,Score 结果含等级概率,Noul 结果含命题概率。
在线体验页面支持图片和视频。问题编辑器提供三种类型,结果面板展示概率分布、服务端耗时和请求往返耗时。
合适的项目边界
OmniJev 适合四类条件:候选空间封闭、判断频率高、响应时间敏感、概率阈值具备业务含义。
浏览器操作、机器人状态判断、视频事件检测、游戏动作选择、危险监控符合这些条件。开放式写作、长链规划和自由代码生成属于生成模型的能力区。
模型概率属于决策证据,权限属于规则层。支付、删除、设备控制和机器人动作要求规则层。规则层掌握权限与副作用,OmniJev 提供语义判断,生成模型承担开放式推理。
项目发布处于早期阶段。论文与完整训练配方缺席,权重依赖基础模型,基准结果缺少独立复现。Apache-2.0 许可证与三档模型降低实验门槛,在线 Demo 提供接口样本。
0 生成 Token 是表面特征。核心变化是模型输出契约:答案从文字变成概率,置信度从附加信息变成系统状态。
OmniJev 给视觉 Agent 提供了一个新部件:感知层与执行层之间的决策层。
资料来源:OmniJev 官网、GitHub 仓库、Hugging Face 权重、在线体验。测试数字属于项目方口径。
