Concitech AI · 深度长文
2026/08/31 11:10
Uber:70%以上 PR 由 Agent 完成,真正难题却是账单
当 AI 编程从个人插件变成企业基础设施,模型能力不再是唯一变量。Uber 用六因子成本方程、真实任务评测、上下文图谱和实时成本反馈,把 Agent 使用量推高近十倍,同时压低单位成本。
一家公司开始大规模使用 AI 编程工具后,最先出现的往往不是生产力奇迹,而是一张没人说得清的账单。
谁在花钱?钱花在哪个模型上?一次会话为什么越跑越贵?换便宜模型会不会把代码质量一起换掉?
Uber 最近公开了自己的答案。它把内部的 Agent 体系称为“软件工厂”:超过 70% 的 Pull Request 被归因于本地或云端 Agent;工程师累计构建了 3600 多个 Skills,每天执行超过 3 万次。
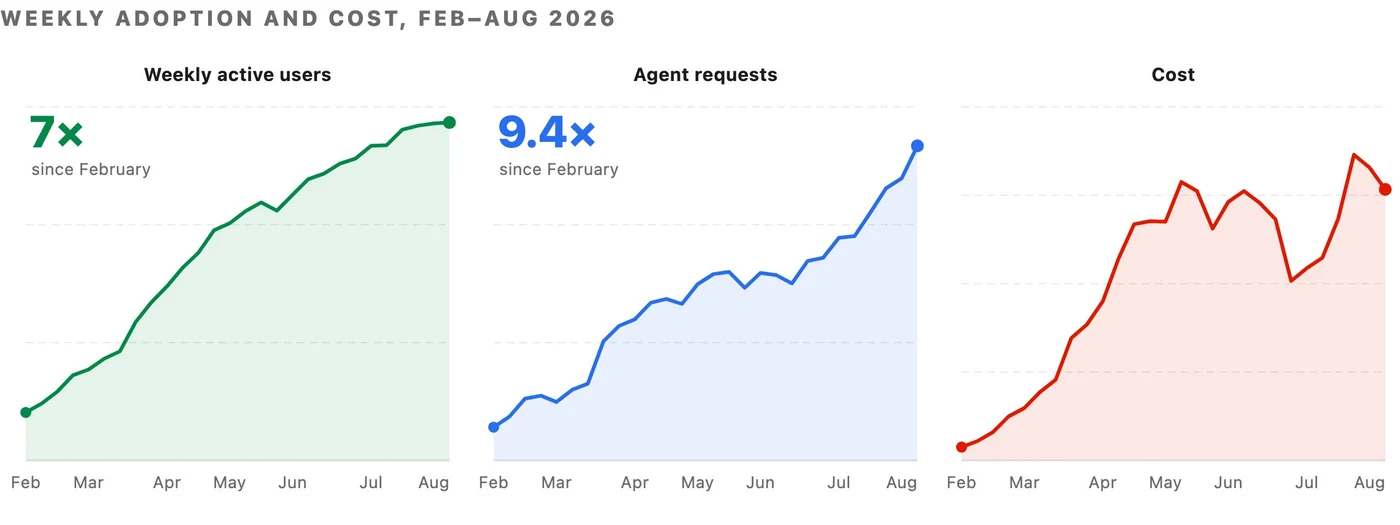
账单的变化更能说明问题。2026 年 2 月到 8 月,Uber 内部 Agent 周活跃用户增长 7 倍,周请求量增长 9.4 倍,但总支出自 4 月后相对稳定。为了排除模型更新、使用结构变化等干扰,Uber 固定同一模型观察:每千次请求成本较峰值下降近 34%,单次会话成本较 6 月峰值下降 52%。
与其把它看作一份“如何让员工多用 AI”的经验帖,不如关注它回答的运营问题:当 Agent 从个人工具变成生产系统,企业该怎样经营它。
70% PR 之后,AI 编程成了一门运营生意
很多团队衡量 AI Coding,仍停留在席位数、调用量和生成代码量。它们能说明工具有没有被打开,却很难说明公司是否得到了价值。
Uber 把统计口径往结果推进了一步:代码评审 Agent 看每次 review 的成本与 F1;告警 Agent 看每条告警的成本与平均修复时间;自动开发 Agent 看每个合并 PR 的成本、回滚率和落地数量。
这带来一个关键变化:模型不再因为榜单分数高就自动胜出。一个模型必须在真实工作里同时证明三件事——任务完成质量、单次结果成本和运行可靠性。
以代码评审 Agent uReview 为例,Uber 用带有已知缺陷的真实 PR 建立评测集,再按难度分级,持续测量精确率、召回率、F1、每次评审成本、延迟、超时和噪声。模型一旦落到“更贵又不更好”的位置,就会被替换。
这比争论“哪个大模型最强”朴素得多,也实用得多。企业采购的不是抽象智力,而是一个在特定流程里稳定产出结果的生产单元。
一张账单,被拆成六个可以管理的变量
Uber 用一个乘法公式分解 Agent 总支出:
用户数 × 每用户会话数 × 每会话轮数 × 每轮请求数 × 每请求 Token 数 × Token 单价。
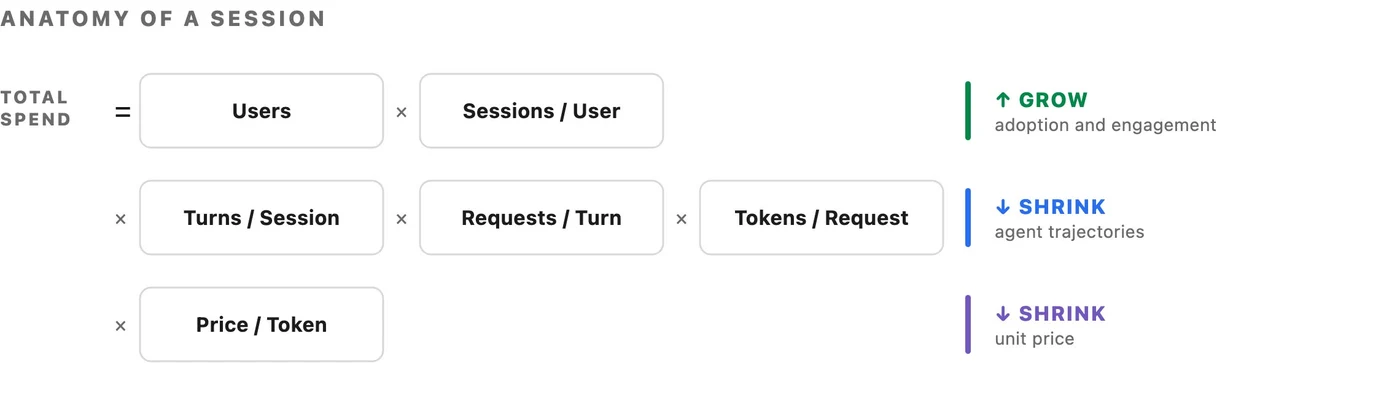
这个公式的价值,不在数学,而在管理方向。
用户数和会话数代表采用率,应该继续增长。每会话轮数、每轮请求数、每请求 Token 数,则包含了 Agent 为寻找信息、反复试错、轮询工具和携带无用上下文付出的额外开销。最后一个变量是 Token 单价,可以靠模型选择和供应商价格优化。
换句话说,Uber没有用“少用 AI”来控成本。它选择削掉不产生结果的计算。
这也解释了为什么只盯 Token 单价容易走偏。把模型换成便宜一半的版本,如果 Agent 因为能力不足多跑三轮,最终账单和质量可能同时变差。真正该算的是“每个完成任务的成本”。
最贵的 Token,通常浪费在 Agent 找路上
Uber 的优化手段里,有几项很反直觉。
一个直接动作是限制上下文。即使模型支持 100 万 Token 的窗口,交互式环境也会在 40 万 Token 左右触发自动压缩,默认推理强度设为 Medium。上下文能装得下,不等于每一轮都值得重发。
缓存时长也要贴合人的工作节奏。工程师经常离开会话超过 5 分钟,短缓存到期后,整个上下文前缀需要按原价重建。Uber 因此把交互式会话改用更长的缓存窗口;生命周期很短的子 Agent 仍使用短缓存。这里算的不是某一次写入价格,而是几轮交互的总成本。
再往下,是工具本身的“行李”。标准 MCP 接入会把工具定义预装进上下文。Uber 发现,安装 100 多个工具时,仅 schema 就会占用约 5 万到 7 万 Token,而且后续每轮还会重新发送。
它的解决办法是把 1000 多个内部与第三方 MCP 服务统一接到网关,再投影成 CLI 命令;Agent 需要什么,临时搜索和加载什么。查询、轮询、取结果这类啰嗦流程,则交给子进程批量执行,只把摘要交还给模型。
在 Uber 的同会话测试中,简单 SQL 查询也能减少 55% 至 71% 的 Token;批量工作流的节省超过 90%。这不是模型突然更聪明了,而是中间过程不再污染上下文。
上下文不是“提示词”,而是企业的数据基础设施
还有一类浪费更隐蔽:Agent 根本不知道答案藏在哪里。
Uber 的代码库有数亿行代码,内部还有大量服务、数据表、事故记录、PR、设计文档和部署信息。让 Agent 自己在这些系统里盲找,会产生更多工具调用、更长上下文和更多错误。
为此,Uber 建了 AI Context Graph:2400 万个节点、8000 万条边,整合 30 多个内部系统。服务归哪个团队、某张表过去被谁使用、一次事故关联了哪些部署,这些关系都可以被 Agent 查询。
一次对照实验很说明问题。同一个问题、同一个模型、相同调用成本,有图谱支撑的 Agent 用 38 秒给出正确答案;没有图谱的版本跑了 20 分 09 秒,调用两个子 Agent,遇到三次错误,最后结论仍然是错的。
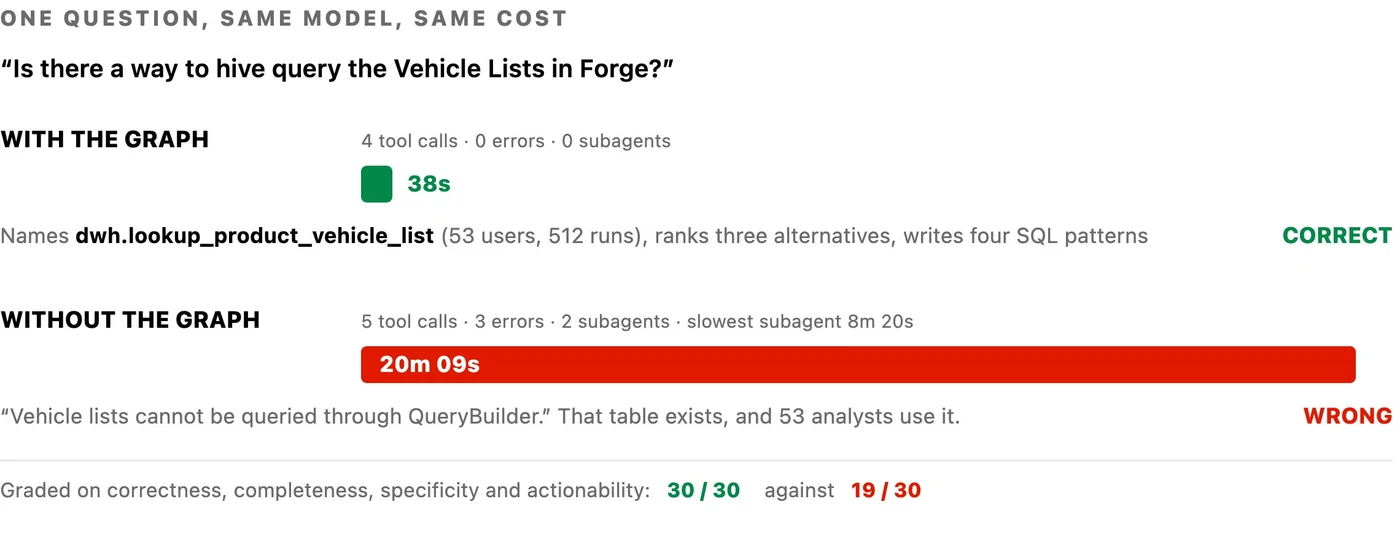
上下文工程因此同时影响成本和质量。给模型一条可靠的路,往往比给它更大的窗口更重要。
别先买更多额度,先建立“每个结果多少钱”
对大多数团队来说,复制 Uber 的 2400 万节点图谱既不现实,也没必要。但它的经营方法可以从很小的范围开始。
先选一个高频、边界清晰的任务,例如代码评审、测试失败修复或告警归因;用真实历史案例建立评测集;同时记录结果质量、完成时间和单次成本。主 Agent 负责拆解和验收,明确的子任务交给成本更低的模型。工具按需加载,查询和轮询放进脚本,避免把原始过程全部塞回上下文。
成本还得让一线工程师看得见。Uber 把实时费用放进终端状态栏,在达到预期支出的 50%、80% 和 100% 时提醒,并用会话分析看板识别 16 类浪费模式。它没有一上来就设置硬上限,因为硬上限只会让工程师少用,无法告诉团队哪里在浪费。
真正有用的问题不是“这个月 Token 花了多少”,而是:
每合并一个 PR、每完成一次 review、每处理一条告警,我们付了多少钱,质量有没有守住?
当这个口径建立起来,AI 编程才从一项模糊的软件订阅,变成可以持续优化的生产系统。
结语
Uber 的案例并不能证明每家公司都能把 Agent 使用量提高近十倍,同时让总成本保持稳定。它自己也明确提醒:这些数字来自 Uber 的代码库、团队规模和工作流,其他企业的结果会不同。
但它证明了一件更重要的事:AI Coding 的下一阶段,竞争不会只发生在模型能力上。
谁能把评测、模型路由、上下文、工具调用和成本反馈连成闭环,谁才有机会把偶尔好用的 Agent,变成一座可靠的软件工厂。
参考资料
