Concitech AI · 深度长文
2026/09/08 21:16
AI 页面为什么总有模板味?Vercel 把品牌判断写进了 DESIGN.md
Vercel 用一份公开的 DESIGN.md、公共样式表和评估闭环,让不同环境里的 AI Agent 也能产出符合品牌的页面。更值得借鉴的,不是提示词本身,而是它把判断、机制和纠偏放到了不同层。
AI 做页面越来越快,成品却常有一种熟悉的“机器味”:居中的大标题,下面铺一排卡片;渐变、玻璃效果和圆角容器轮番上场;表格被挤进窄栏,数据看起来很多,读者却不知道该先看哪里。
问题通常不在 CSS 写得不够熟,而在 Agent 缺少判断依据。
Vercel 最近公开了自己的解决办法。他们把品牌和设计方法整理成一个任何 Agent 都能从公开 URL 加载的文件:vercel.com/design.md。这份文件不是简单罗列字号、颜色和间距,也不是一段更长的“万能提示词”。它回答的是另一类问题:页面给谁看,读者来这里要做什么决定,证据应该怎么组织,哪些常见的 AI 设计习惯必须避开。
如果只看到 DESIGN.md,很容易把这件事理解成“给 AI 多写一份规范”。Vercel 真正做的是一套三层系统:指导文件负责判断,公共样式表负责重复机制,评估闭环负责把真实纠正写回系统。
这套分工,比那份文件本身更值得抄。
仓库里的 Agent 懂品牌,仓库外的 Agent 不懂
Vercel 此前已经在内部代码仓库里使用一个名为 product-design 的 Skill。Agent 在仓库内工作时,可以同时读取组件、设计系统和产品规范。它不只是知道按钮用什么颜色,也能看到已经上线的页面,理解这些规则在真实产品里如何组合。
麻烦出现在仓库之外。
销售提案、客户报告、基准简报和一次性页面,常常由无法读取内部仓库的工具生成。Agent 看不到组件,也拿不到产品规范。团队即使把视觉语言写进 Prompt,不同模型仍会做出差异很大的结果。像“保持简洁”这种话,对人已经够含糊,对模型更像一次自由发挥邀请。
Vercel 最初也试过把 product-design 的参考文件压缩成一个公开 Prompt。结果不理想。离开真实组件和上线案例后,模型只能根据文字重新想象 Vercel 的样子。描述没有错,输出仍然不像同一个品牌。
于是团队放弃了“把旧规范搬出来”的思路,从头编写 DESIGN.md,并让每条规则都经过固定场景验证。
DESIGN.md 编码的不是样式,而是判断
打开公开文件,会发现大量内容并不是视觉参数。它要求 Agent 先识别读者的任务,再决定页面结构;既要让管理者快速读到结论,也要让审阅者继续检查证据;文案要陈述具体事实,同时保留必要限制。
它还专门给常见的生成式设计坏习惯起名字。例如:装饰性渐变、每个指标都套一张卡片、普通元数据也做成胶囊标签、宽表格被塞进窄栏、无意义的动效,以及“居中 Hero 加卡片网格”的默认模板。
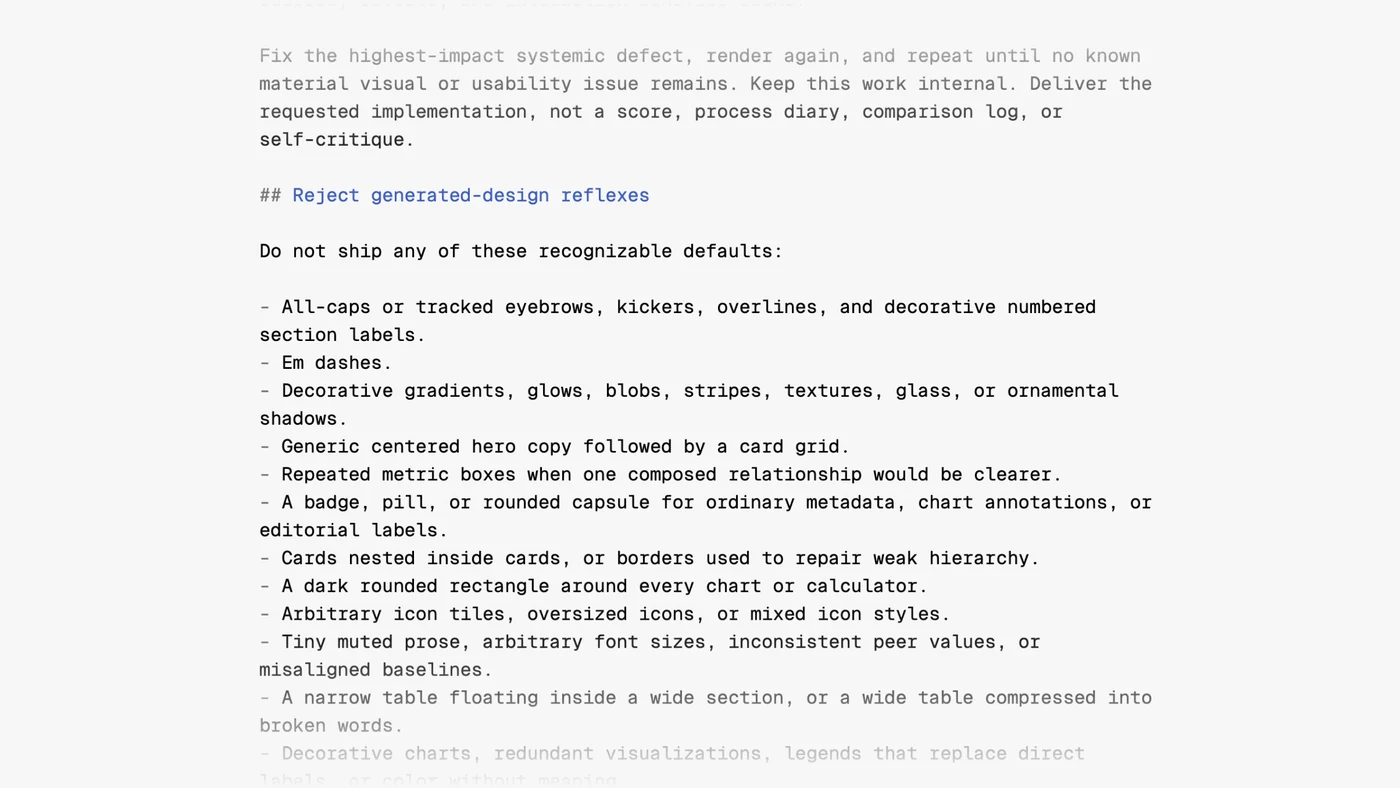
给坏模式命名很重要。与其告诉模型“做得高级一点”,不如明确说明什么不能交付。前者没有可执行边界,后者能被识别,也能在评审中复现。
不过,散文规则并不适合控制所有事情。让模型每次重新决定字号、间距和表格布局,既浪费上下文,也会制造波动。Vercel 因此公开了一份样式表,把这些机械决策做成 CSS 类名和 token。Agent 只需要在 HTML 里引用对应类名,样式表到浏览器渲染时才加载,不进入模型上下文。
这一步等于主动收回部分自由度。该由系统固定的东西,就不再让模型“发挥”。
三层分工:判断、机制、纠偏
Vercel 的系统可以概括成下面三层。
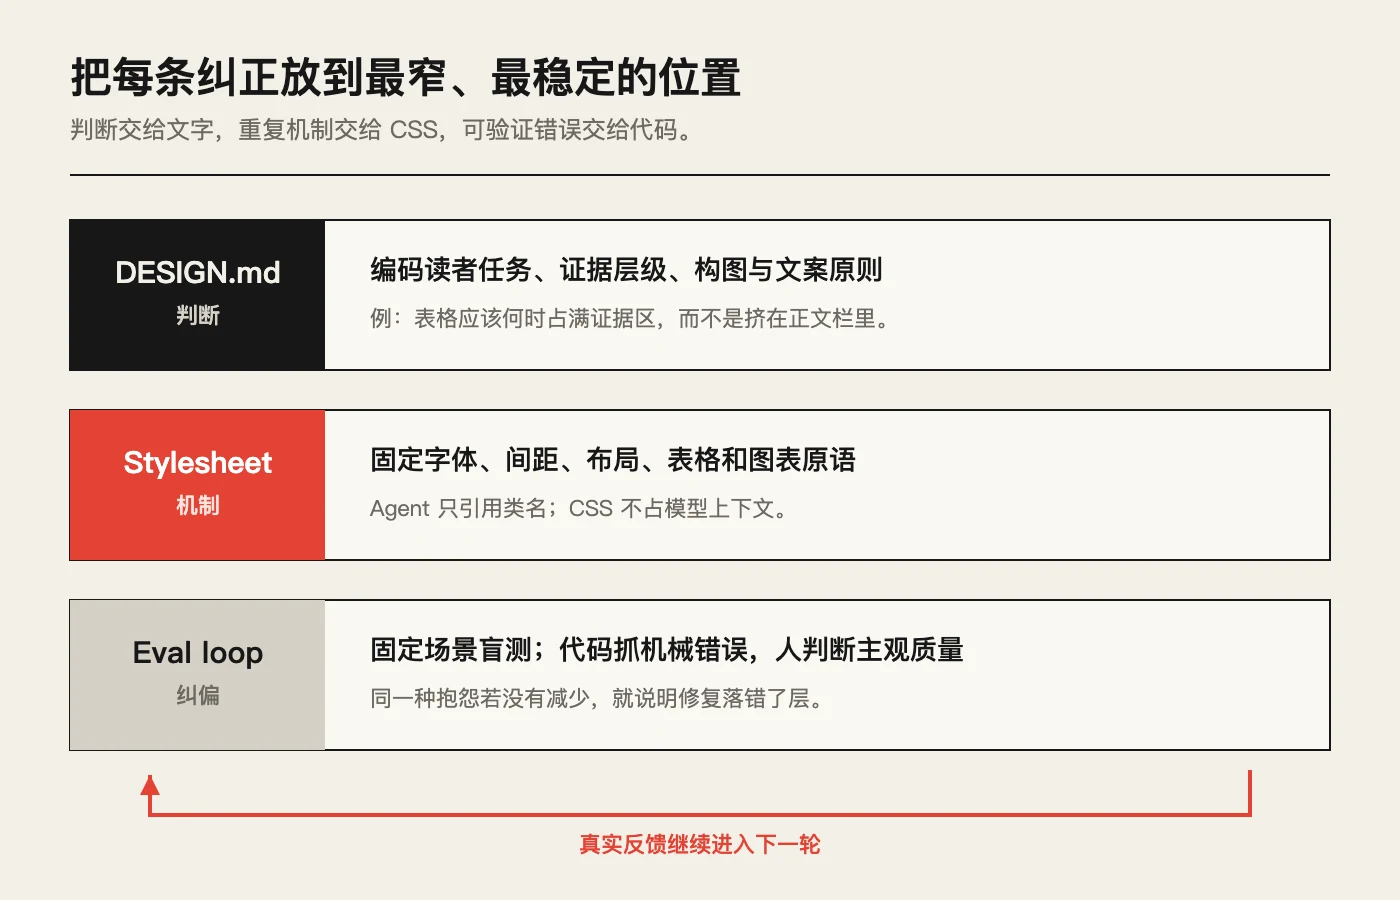
第一层是 DESIGN.md。它保存需要语境判断的原则:读者是谁、证据如何排序、什么构图适合当前任务、文案怎样避免空话。
第二层是公共样式表。它固定可重复的机制:排版、间距、布局、表格、图表和交互控件。模型知道有哪些积木,但不用每次重新造积木。
第三层是评估闭环。确定性代码检查负责抓机械错误,例如表格没有利用可用宽度;人负责判断层级、构图和信息是否真的服务读者。两者不能互相替代。
Vercel 还有一条很实用的落地规则:每条反馈都放到能稳定执行它的最窄位置。
如果是判断问题,写进 DESIGN.md;如果是重复机制,放进样式表;如果可以机械验证,就写成代码检查。某个模型偶发一次、其他模型没有复现的问题,先不急着变成通用规则。
很多团队把所有纠正都塞回 Prompt,最后得到一份越来越长、内部互相打架的说明书。Vercel 的做法更像软件工程:先判断问题属于哪一层,再决定用文字、CSS 还是测试修。
它不是靠“感觉不错”迭代的
为了判断规则有没有用,Vercel 固定了七种真实场景,包括用量与性能报告、续约提案、基准报告、交互式规划页、Build vs. Buy 简报、安全治理简报和演示文稿。
每个场景的 Prompt、模拟数据和视口都冻结,唯一持续变化的是 DESIGN.md。一次完整轮次会让七个场景分别在 Claude Opus 4.8 和 Codex(GPT-5.5)上生成。团队用本地评审工具保存输入、模型配置、文件版本、截图和反馈,并在里程碑进行盲测 A/B,对比新版与旧版指导文件。
这种设置解决了一个常见误区:只看一次“最好结果”。生成模型有随机性,重新抽一次可能看起来就更漂亮。固定输入、保留首次输出、记录版本,才能判断改动是否真的带来稳定改善。
Vercel 称整个开发过程做了 200 多次运行,包括完整轮次、定向检查和失败尝试。最后,他们挑选三个桌面场景,用 Codex(GPT-5.5)分别在加载和不加载 DESIGN.md 的条件下各生成一次,再用确定性检查统计已经被定义过的失败。
结果是 39 对 91,本次测试中少了约 57%。
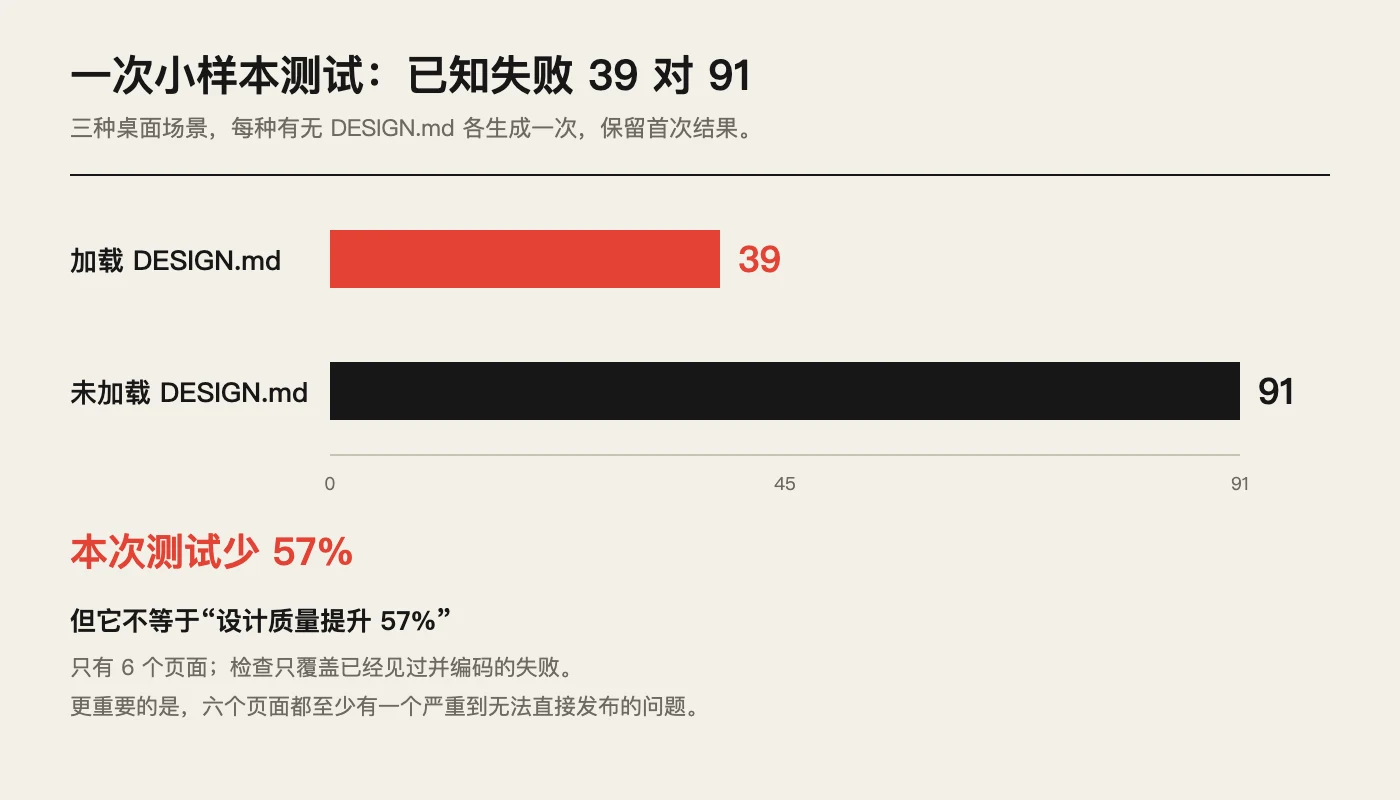
这个数字需要克制解读。样本总共只有六个页面;检查只会识别团队已经见过并编码的错误,不能衡量整体设计质量。更关键的是,六个页面都至少有一个严重到不能直接发布的问题。
所以结论不是“放一个文件,AI 设计质量提升 57%”。更准确的说法是:一旦团队把某种失败说清楚、放到正确层并持续验证,同类错误更可能在后续生成中消失。
真正的资产,是被编码的纠正
DESIGN.md 会失效吗?会。品牌会变,产品类型会增加,模型也会改变。同一条规则在不同模型上的执行效果并不稳定。
Vercel 的办法是把真实使用接入维护流程。他们在 Slack 中部署了 @design-agent,接收设计评审、文案建议、图标推荐和报告网站等需求。Agent 加载最新 DESIGN.md,生成页面,再把整页截图和部署链接发回对话。
团队每周收集 Slack、GitHub Review 和 Figma 中的反馈,自动聚类重复抱怨,再由人决定修复应该进入 Agent、Skill、DESIGN.md、样式表还是确定性检查。如果一种抱怨在编码修复后仍没有减少,说明修复方式选错了:规则可能写得不清楚,也可能根本不该用散文解决。
这改变了设计规范的价值。规范不再只是新员工入职时读一次的文档,而是一套能接受生产反馈、能比较版本、也能被回归验证的运行系统。
普通团队怎么开始
不需要先搭一套复杂平台。最小可行做法只有一个循环。
先选一种高频产物,例如周报、客户提案或投研简报。写下三四条可观察的评分标准,然后在没有额外设计上下文时生成一次,保存 Prompt、输入、模型配置和截图。这是基线,不好看也不要重抽。
接着整理最近十条人工纠正,把“看起来再清爽一点”改成可以观察的要求,比如“证据表格使用全部可用宽度”“结论在首屏出现”“所有比较条使用同一尺度”。判断类规则写进 DESIGN.md,重复样式做成 CSS,能够检查的错误写成脚本。
最后,用同一输入、同一模型和同一视口再生成一次,把两个版本打乱后盲评。别急着手改成品,先修改指导文件,再用下一轮首次输出验证。
我认为,这件事最有价值的地方不在于 Vercel 又公开了一份 Markdown 文件。它给出了一个更诚实的答案:AI 产出不稳定,不能靠一段“更聪明的 Prompt”治好。
团队真正需要积累的,是那些反复发生、已经说清楚、并且有办法验证的纠正。DESIGN.md 只是它们进入系统的其中一个入口。
