Concitech AI · 深度长文
2026/08/25 06:39
小米突然拿出 AI Cube:这台“120B 小主机”,真能挑战英伟达吗?
三颗玄戒芯片、120B本地模型、1.22TB/s带宽。小米AI Cube最吸引人的参数,也正是最容易被误读的地方。
8 月 24 日的小米玄戒芯片技术沟通会上,三颗新芯片一口气亮相:玄戒 O3、O100 和 D100。
发布会进行到后半段,小米又拿出了一台银黑色小主机。机身正面只有一行字:Xiaomi AI Cube,旁边特意标着 Prototype。
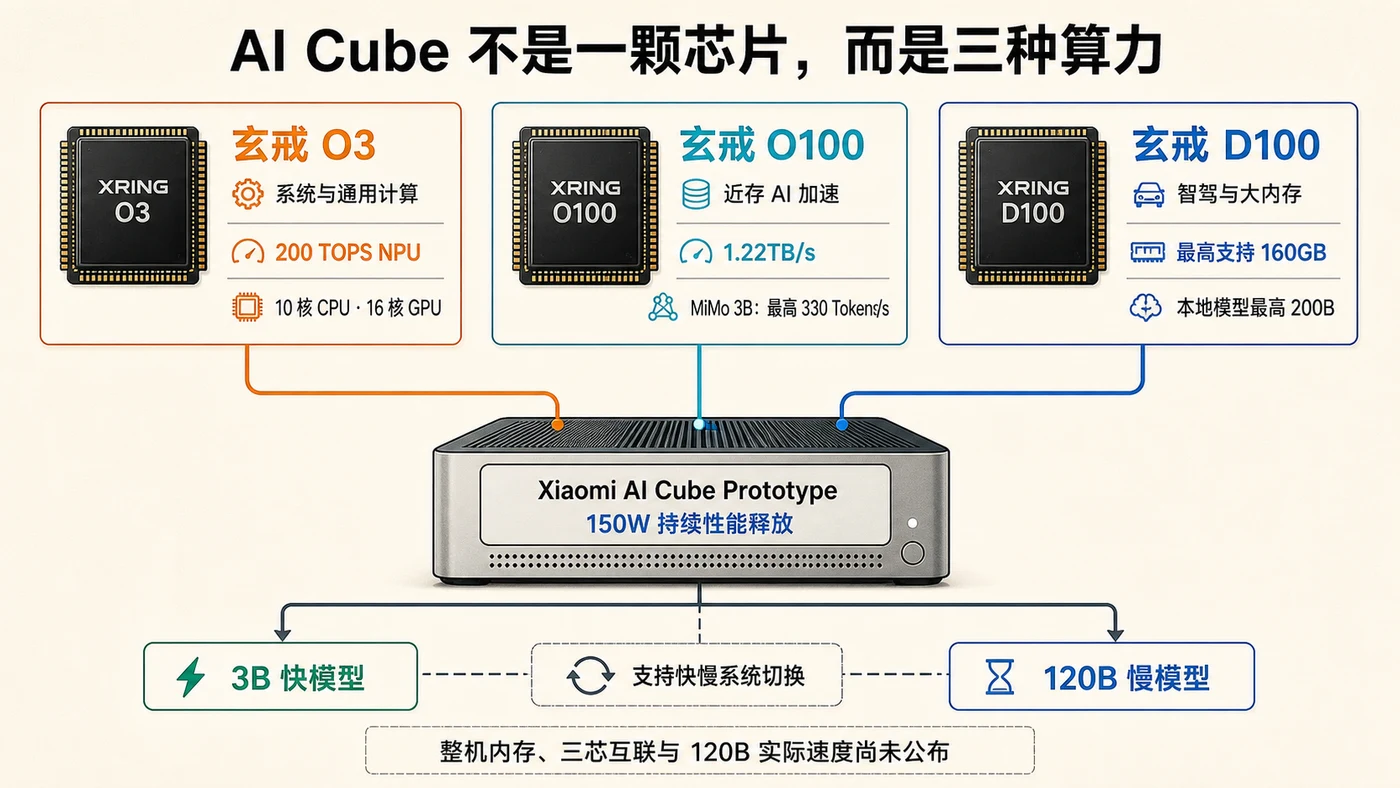
它把三颗芯片全部塞进桌面机箱,本地部署 120B 和 3B 双模型,支持快慢系统切换。官方展示的持续性能释放为 150W,外壳用航天铝一体成型,并加工了 33874 个散热孔。
这台机器很快在海外社区出圈。有人把它称为“中国版 DGX Spark”,也有人直接拿 1.22TB/s 带宽、160GB 内存和 330 Tokens/s,与英伟达 GB10 横向比较。
问题是,这三个数字并不属于同一个层级。
AI Cube 确实值得关注,但不是因为一张参数表已经赢了英伟达。它真正展示的是,小米想把手机芯片、AI 加速器、智驾芯片和 MiMo 模型拼成一套端侧计算平台。
先说结论:它是原型机,还不是可以买到的产品
截至目前,小米没有公布 AI Cube 的上市时间、售价、整机内存、存储、接口、操作系统或开发工具。
玄戒 O3 将在小米 18 Fold 上首发。雷军称 O100 和 D100 已经完成回片验证,计划 2027 年正式商用,但这不等于 AI Cube 会在 2027 年零售。
因此,现在能确认的是一台用于验证三芯协同和本地大模型的工程样机。它可能变成开发者工作站,也可能只是一台展示玄戒能力的参考设计。
把它直接称为“GB10 杀手”,至少早了一年。
三颗芯片,分别解决三种问题
AI Cube 不是常见的 CPU 加独立 GPU 结构。它把三颗用途不同的芯片放到了一起。
玄戒 O3:负责系统和通用计算
O3 是小米第二代旗舰 SoC,采用 3nm 制程,拥有 10 核全大核 CPU、16 核 G2-Ultra NX GPU,以及面向端侧大模型重构的 NPU。
小米给出的 NPU 张量算力是 200 TOPS。
TOPS 受数据精度、稀疏性和计算类型影响,不能直接与英伟达宣传的 FP4 PFLOPS 换算。这个数字更适合用来比较 O3 与同类移动 SoC,而不是判断整台 AI Cube 的大模型速度。
玄戒 O100:专门解决“内存墙”
大模型逐 Token 生成时,需要频繁读取权重。很多端侧设备并不是算力不够,而是内存带宽喂不饱计算单元。
O100 针对的就是这件事。
它采用 6nm 工艺和 3D 晶圆级堆叠,通过 28672 条有效数据通路,把计算与存储拉得更近,官方公布的近存计算带宽达到 1.22TB/s。
O100 与 O3 协同时,运行 Xiaomi MiMo 3B 模型的推理速度最高达到 330 Tokens/s。
注意,330 Tokens/s 对应的是 MiMo 3B,不是 AI Cube 上的 120B 模型。
玄戒 D100:从汽车借来的大内存底座
D100 原本面向智能驾驶,采用 3nm 制程,集成 20 核 CPU 和 16 核 NPU,最高支持 160GB 统一内存,并支持在本地部署最高 200B 参数模型。
小米把它提前装进 AI Cube,可能是因为大模型最先遇到的限制往往不是计算,而是模型能否完整放进内存。
但官方说的是“D100 最高支持 160GB”,尚未确认 AI Cube 样机实际安装了多少内存,也没有说明三颗芯片是否共享一块完全一致、缓存连贯的统一内存。
这一区别很重要。
网上最火的四个数字,应该怎样理解
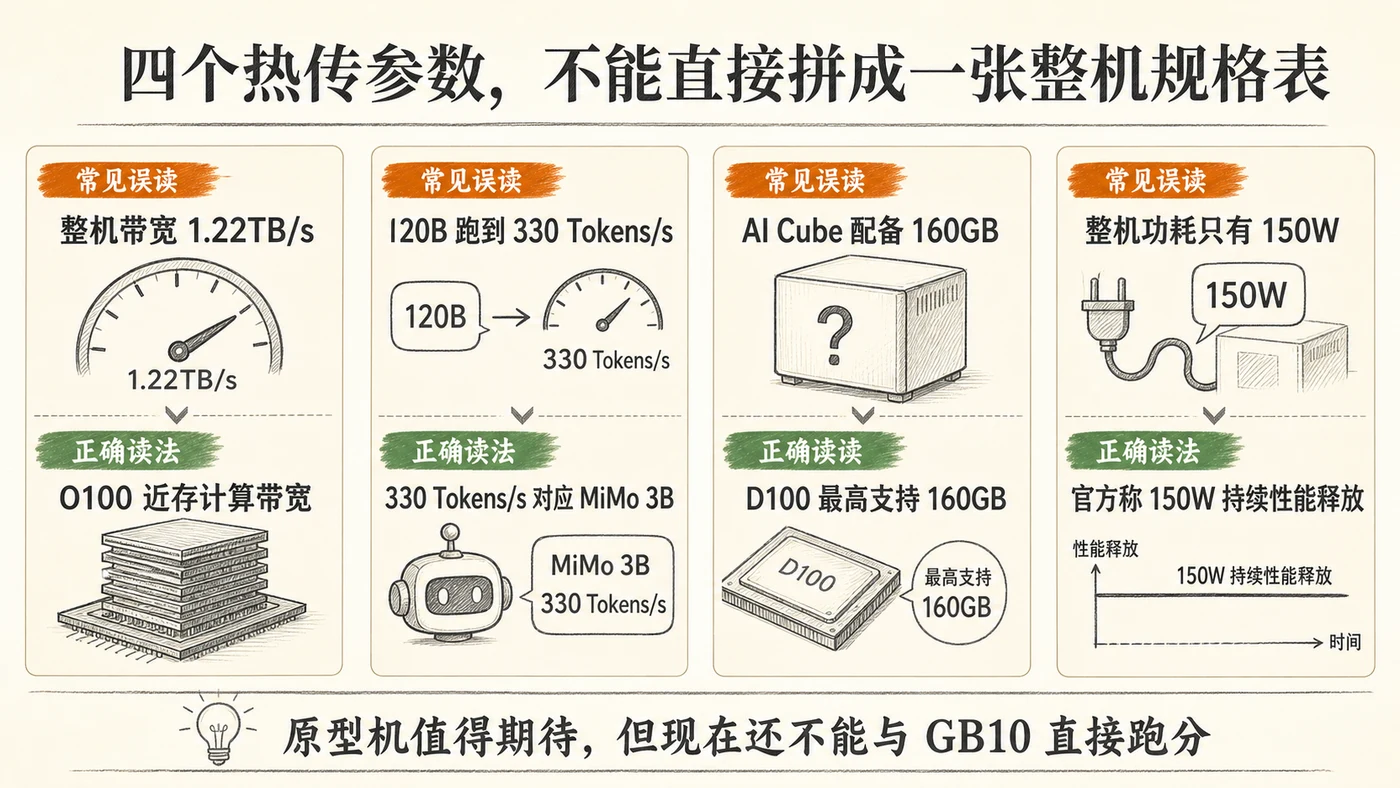
1.22TB/s 不是整机统一内存带宽
它是 O100 近存计算子系统的公开指标。
DGX Spark 的 273GB/s 指 128GB LPDDR5X 一致性统一内存的系统带宽。两者测量对象不同,不能简单得出“AI Cube 带宽是 GB10 的 4.5 倍”。
要做真正比较,需要知道 O3、O100、D100 之间怎样互联,120B 模型权重放在哪里,以及跨芯片搬运数据时会损失多少带宽。
小米目前没有公开这些信息。
330 Tokens/s 不是 120B 推理速度
这个成绩来自 O3 与 O100 协同运行 MiMo 3B。
小模型达到 330 Tokens/s 很有吸引力,尤其适合摘要、改写、意图判断和设备控制。但它不能证明 120B 模型也能以相同速度运行。
小米没有公布 120B 模型的名称、量化精度、激活参数、上下文长度、首 Token 延迟或生成速度。
160GB 是 D100 的支持上限
这不是已经确认的 AI Cube 整机配置。
一个 120B 稠密模型仅权重就大约需要:
- FP16:240GB;
- INT8:120GB;
- 4-bit:60GB。
实际运行还要给 KV Cache、运行时和系统服务留空间。AI Cube 能装下 120B 并不奇怪,但它大概率使用了量化、MoE 或其他压缩方式。具体方案仍未公布。
150W 也不能直接和 GB10 功耗相比
小米发布会的措辞是“150W 持续性能释放”,更接近整机散热或持续负载能力描述。
DGX Spark 官方规格则同时列出 140W 的 GB10 TDP 和 240W 电源。测量边界不同,暂时无法计算两台机器谁的每瓦 Token 更高。
120B 加 3B,可能比单纯堆大模型更有价值
AI Cube 展示了 120B 和 3B 双模型,并称可以进行“快慢系统切换”。
小米没有解释完整路由机制,但这个设计方向很合理。
3B 模型启动快、成本低,可以处理设备控制、简单问答、文本整理和请求分类。120B 模型负责复杂推理、代码生成和需要更多知识的长任务。系统先判断难度,再决定是否升级到大模型。
这与云端 AI 服务正在使用的模型路由类似,只是它被搬到了桌面设备上。
本地 AI 的资源远少于数据中心,更不能让最大模型处理每一次请求。真正实用的端侧系统,需要缓存、路由和多个模型协作,而不是把“能加载的最大参数量”当成唯一指标。
AI Cube 的三芯结构也可能服务于这种分工:O3 维持系统与轻量任务,O100 加速高频模型推理,D100 提供大内存和高算力。这里仍然是根据芯片定位做出的推断,最终方案要等小米公开架构。
它和 DGX Spark 到底是不是同一类产品?
两者都想把原本属于服务器机房的 AI 能力搬到桌面,但目前成熟度完全不同。
| 项目 | Xiaomi AI Cube | NVIDIA DGX Spark |
|---|---|---|
| 状态 | 工程原型 | 已量产销售 |
| 处理器 | O3 + O100 + D100 三芯 | GB10 Grace Blackwell |
| 内存 | 整机容量未公布;D100 最高支持 160GB | 128GB 一致性统一内存 |
| 带宽 | O100 近存带宽 1.22TB/s | 系统一致性内存 273GB/s |
| 模型 | 演示本地 120B + 3B | 官方支持最高 200B |
| 功耗口径 | 150W 持续性能释放 | GB10 TDP 140W,整机电源 240W |
| 软件 | 尚未公布 | DGX OS、CUDA、PyTorch、TensorRT-LLM、NGC |
| 价格 | 未公布 | 官方建议零售价 4699 美元 |
硬件数字只回答“理论上能做什么”,软件决定开发者今天能不能把工作跑起来。
DGX Spark 的优势主要来自完整平台,而非 GB10 单芯片。CUDA、驱动、容器、PyTorch、TensorRT-LLM 和大量现成模型脚本,已经替开发者处理了最麻烦的部分。
AI Cube 如果要成为真正的竞品,至少需要兼容主流框架,提供稳定驱动、量化工具、性能分析、模型转换和容器环境。否则开发者买到的是一台参数漂亮、每换一个模型都要重新适配的专用设备。
这可能是小米接下来最难补的一课。
小米为什么要做这样一台机器?
把 AI Cube 只看作迷你主机会低估它的作用。
小米已经有手机、汽车、家电和超过十亿台连接设备。它还在建设 MiMo 模型、HyperOS、智驾系统和自研芯片。过去这些业务各自需要不同的计算平台,现在小米试图用玄戒把底层统一起来。
O3 可以进入手机和平板,D100 进入汽车,O100给端侧大模型提供加速。AI Cube 则把三者放到一个可观察、可调试的环境里,用来验证编译器、模型路由和跨芯片协同。
它更像一台开发母机。
一套模型可以先在桌面验证,再缩小到手机,迁移到车机,或成为家庭本地 AI 中枢。如果各设备共享模型格式、工具链和运行时,小米就不必为手机、汽车和家电分别维护完全不同的 AI 技术栈。
雷军披露,小米重启大芯片研发五年多,累计投入超过 210 亿元,芯片团队接近 3000 人。小米还计划 2026 年在 AI 与具身智能相关领域投入超过 160 亿元。
AI Cube 是这些投入第一次以“桌面 AI 计算机”的形态汇合。
如果量产,它最适合做什么?
第一类是隐私敏感的本地 Agent。
企业可以把代码、合同、设计资料和内部知识库留在本地,避免每一次检索和推理都上传云端。设备买断后,持续高频使用也不再按 Token 支付 API 费用。
第二类是家庭与车辆的常驻 AI 中枢。
断网时仍能完成语音理解、设备控制、摄像头分析和本地自动化。相比每条指令都发到云端,本地推理延迟更稳定,也更容易做个性化记忆。
第三类是玄戒生态的开发设备。
开发者可以在桌面测试准备部署到手机、汽车和机器人的模型,前提是小米开放足够完整的 SDK、调试器和模型转换工具。
它不一定适合大规模训练。现有信息主要指向本地推理,小米也没有公布训练性能、集群互联或高速扩展能力。
真正决定 AI Cube 成败的,不是 120B
接下来值得关注的只有几个问题:
- AI Cube 是否会量产,价格是多少?
- 样机实际内存容量与三芯互联拓扑是什么?
- 120B 模型到底是哪一个,量化精度和实际速度是多少?
- 能否直接运行 PyTorch、llama.cpp、SGLang 或其他主流框架?
- 小米会不会把 MiMo、HyperOS 和玄戒 SDK 对第三方开发者开放?
这些问题回答之前,AI Cube 还不能算 DGX Spark 的正式竞争对手。
但它已经说明,小米的自研芯片不准备停在手机 SoC。O100 负责大模型,D100进入汽车,O3 覆盖移动终端,再由 AI Cube 把它们组合起来。小米正在搭建一套横跨人、车、家和机器人的本地算力底座。
120B 模型只是舞台上最醒目的演示。
真正需要关注的,是小米能否把三颗芯片变成一个开发者愿意长期使用的平台。
